搜索到
35
篇与
对齐
的结果
-
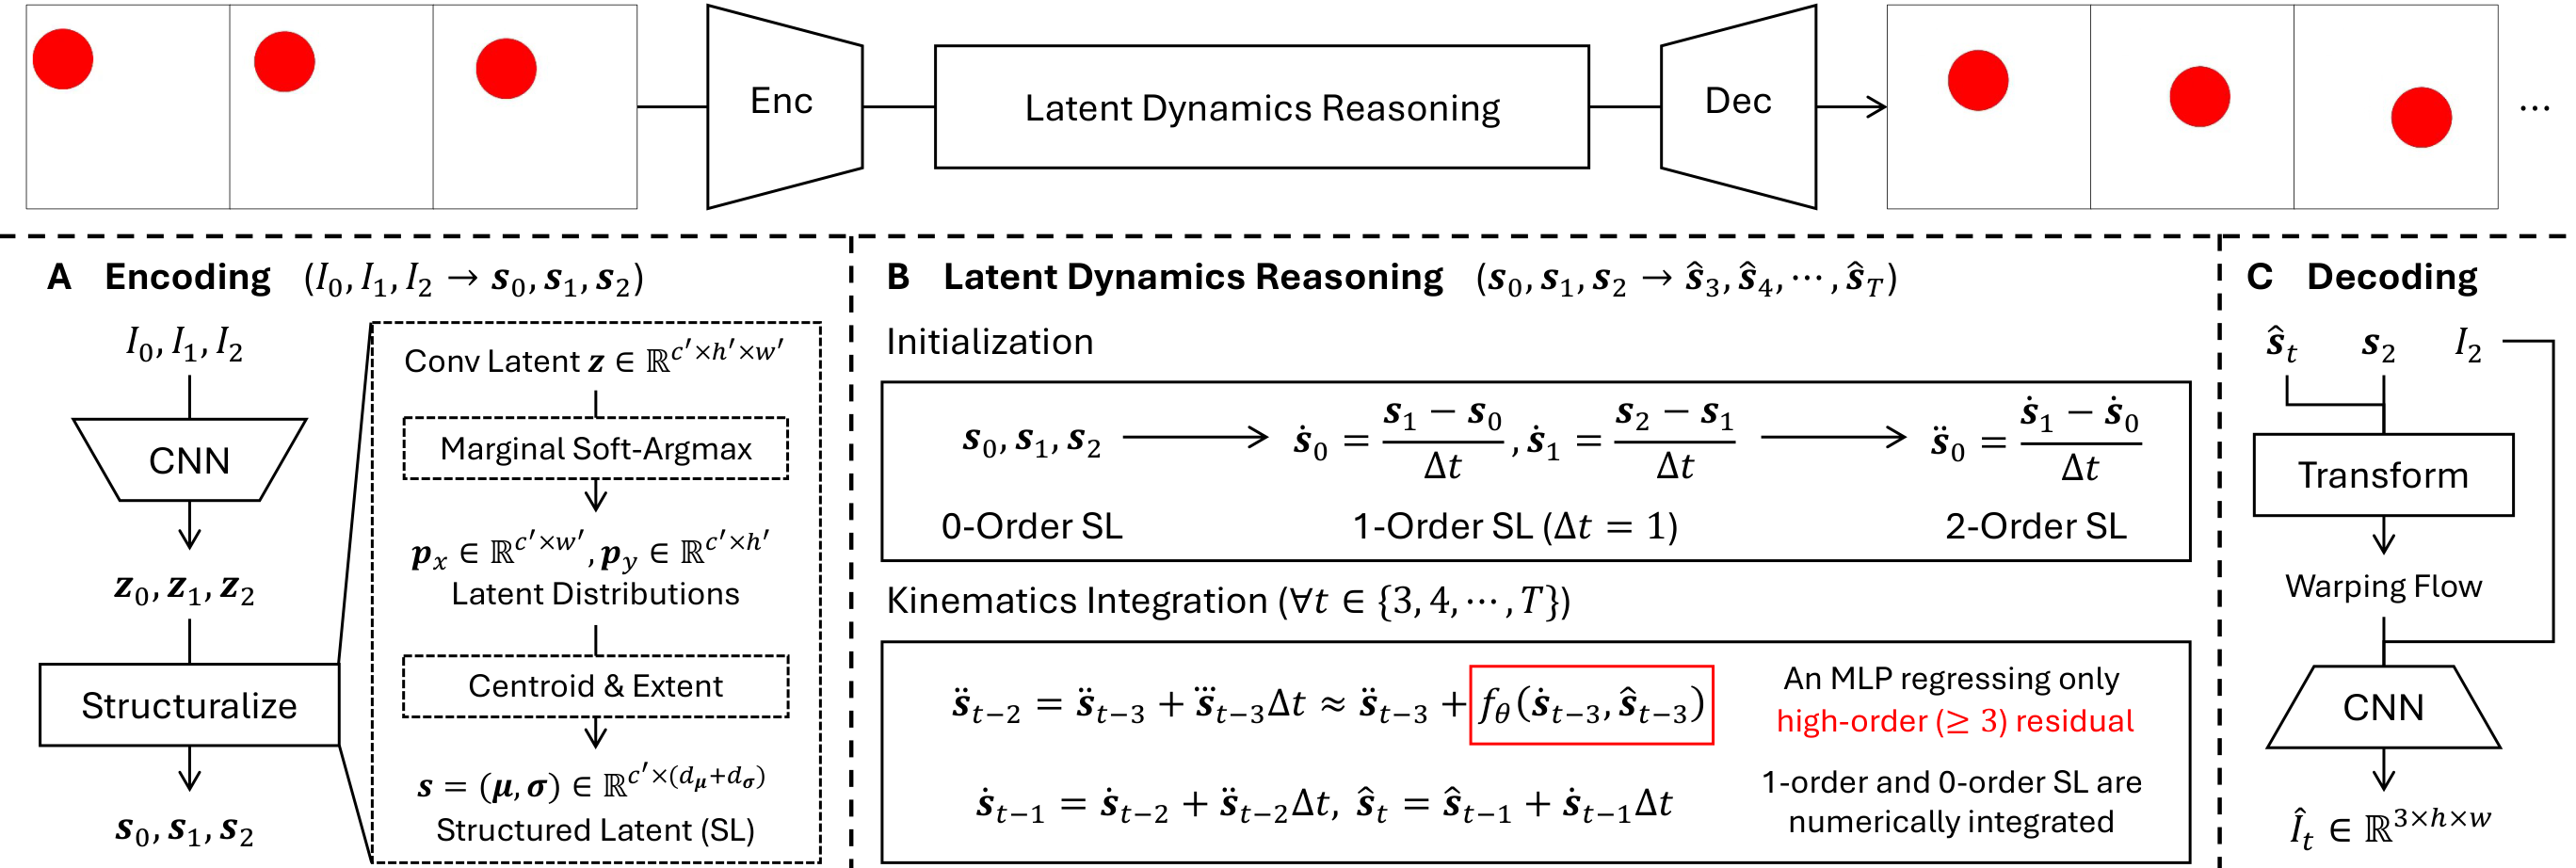
 AIGC 每日速读|2026-08-13|Adobe视频世界模型首次外推物理定律LDR 今日 AIGC 论文速览 今日共 10 篇 · 世界模型与物理外推 2 篇 · 全模态对话与数字人 1 篇 · 生成训练目标与对抗后训练 1 篇 · 流式与自回归视频生成加速 2 篇 · 图像超分与编辑 2 篇 · 语音合成细粒度控制 1 篇 · 视频生成评测基准 1 篇 重点论文标题列表 LDR(UCSD·Adobe):首个能外推物理定律的视频世界模型 Ex-Omni-2D(香港中文大学(深圳)·腾讯光子):四卡四步推理让对话模型有形象 ⚡ AdvFD(北京大学·快手可灵(KlingAI Research)):对抗表征治好FD指标刷分症 Stream Forcing(华中科技大学·地平线·Anyverse Dynamics):统一训练轨迹让流式视频FVD降36.6% SparSTAR(西江大学(Sogang University)):免训练块稀疏注意力720p提速1.6倍 今日论文速览 1. LDR:首个能外推物理定律的视频世界模型 Learning How the World Evolves: Extrapolative Video World Models via Latent Dynamics Reasoning | UCSD·Adobe | arXiv:2608.09926 ⚠️ 前序问题:世界按自身的动力学(运动定律)演化,但主流视频扩散模型基本是在拟合像素,而没有建模像素如何随时间转移。结果是它们能渲染出视觉上合理的帧,却未必真的遵守物理定律——尤其在分布外场景中,模型是真学到了底层动力学,还是只记住了训练集里的表观模式,此前很难分辨,也几乎没有模型能把学到的动力学外推到训练分布之外。 本文贡献:提出 Latent Dynamics Reasoning(LDR),纯粹从像素中捕获动力学:把潜空间的状态转移显式改写成运动学积分——低阶动力学用数值积分直接算出,网络只回归驱动 rollout 的三阶及以上残差项。为了让这套积分具备更好的外推能力,LDR 不在稠密卷积特征上做,而是运行在结构化潜变量(Structured Latent)之上。沿用 PhyWorld 的设定,在匀速运动、抛物线、碰撞、弹跳、逼近五个任务的白盒物理基准上验证,重点考察能暴露模型是否真正习得动力学的分布外场景。 Overview of LDR. Given three conditioning frames $I_0,I_1,I_2$, LDR predicts the future frames $\hat{I}_3,\hat{I}_4,\dots,\hat{I}_T$ in three stages. (A) LDR first encodes each input frame into a structured latent (SL). (B) LDR measures the low-order time derivatives of the given SL, then rolls out by regressing only the high-order residual with $f_\theta$ and numerically integrating the lower orders to the next latent $\hat{\boldsymbol{s}}_t$ ($t\in\{3,4,\cdots,T\}$). (C) LDR finally decodes each predicted latent to an RGB frame $\hat{I}_t$. 实验效果:在 256² 分辨率下,无论单任务还是联合任务训练,LDR 的分布内与分布外误差之差比视频扩散基线小 20 倍以上,同时参数量少 26 倍、运行速度快 143 倍。它在剧烈分布偏移下依然成立:仅用「红球从左向右」训练,却能正确预测蓝色方块从右向左的运动。作者称这是据其所知首个能把学到的动力学外推到训练分布之外的视频世界模型。 Stress test under severe OOD shift. Trained only on red balls but tested on an unseen object (e.g., “earth”), LDR still predicts the correct motion, while the others fail. 批判点评:这篇的方法论姿态比数字更值钱。它没有把「物理一致性」当成一个再加些数据、再加个 loss 就能改善的软指标,而是直接在架构层面把低阶运动学变成不可学的确定性计算,只留高阶残差交给网络——这等于把归纳偏置从「祈祷模型学到」改成「结构上直接给定」,也顺带解释了参数量能少 26 倍:本来大量容量就是被用来重新发明积分。20 倍的分布内外误差差距收窄,比任何 FVD 分数都更能说明泛化。但必须把庆祝的音量调低:验证完全落在 PhyWorld 式白盒基准上,五个任务都是刚体质点级的简单动力学,与真实视频里的流体、布料、多物体接触、遮挡完全不在一个复杂度量级;红球到蓝方块的泛化确实漂亮,但那本质上是「外观换了、动力学同构」,并未证明它能外推到没见过的动力学类型。运动学积分假设状态可以被少数低阶导数良好描述,一旦遇到碰撞、断裂这类不可微事件,残差项还能不能兜住是未知的。此外它与主流视频扩散模型不是同类可替换品——143 倍加速的对照物是在白盒任务上的基线,不代表能接管开放域视频生成。它更应被读作一个强有力的存在性证明:外推是可能的,前提是别再让网络从零学积分。 2. Ex-Omni-2D:四卡四步推理让对话模型有形象 Ex-Omni-2D: Expressive Omni-Modal Dialogue Models with Native Visual Presence | 香港中文大学(深圳)·腾讯光子 | arXiv:2608.10720 ⚠️ 前序问题:全模态对话模型已经能理解多模态输入并合成语音回复,但这些回复在视觉上是「无身体」的——只有声音没有形象。要补上形象通路,最直接的做法是端到端监督,可这需要大规模的「查询-文本-语音-视频」四元组数据,现实中几乎无法收集。另一方面,流式增量生成还面临后段块质量累积退化的问题。 本文贡献:提出 Ex-Omni-2D,给定多模态查询、参考图像和参考音频,协同生成文本、个性化语音与参考条件视频三位一体的回复。模型先预测一个结构化的 Visual Thought Plan(VTP)描述场景、情绪与动作,再生成回复文本和原生多码本语音单元;这些语音单元构成共享的声学-时间接口,既解码为语音又与视频帧在线对齐。正是这个接口让回复通路与形象通路能各自从异质的语音、对话、形象视频数据中学习,从而绕开四元组大规模监督。全序列 Video Generator 作为主教师,进一步蒸馏成少步的块因果 Streaming Student,其 Prefix Streaming 机制把干净潜变量跨相邻块携带,抑制后段块的累积退化。 Overview of Ex-Omni-2D. Speech, text, and vision encoders provide multimodal context to the Large Language Model, which produces a non-user-facing Visual Thought Plan (VTP) and the user-facing response. The Speech Generator uses reference audio for voice conditioning and generates speech in a native multi-codebook space. The Video Generator encodes the reference image and VTP, and reuses the generated speech representation to synthesize the synchronized video response. It is instantiated as a full-sequence Teacher for primary realization and a distilled Prefix-Streaming Student for efficient incremental deployment. 实验效果:四步推理下,完整的四 GPU 流水线在 400×720 / 720×400 分辨率上达到端到端 RTF 1.293,提供了一个实用的质量-效率操作点。 Prefix-Streaming analysis. Top: representative later-chunk examples; each row shows the reference image, a no-prefix frame, and its Prefix-Streaming counterpart. Bottom: full-duration DINO curves over 200 paired CommonEval videos. Markers denote chunk means and shaded regions denote bootstrap uncertainty. Prefix is mixed over early chunks but degrades more slowly and is consistently better from chunk~9 onward, supporting a reduction in cumulative late-chunk subject drift rather than a uniform per-chunk improvement. 批判点评:这篇真正的巧劲不在多模态本身,而在于用「多码本语音单元」当作声学与时间的共享接口——这一步把数据需求从不可能的四元组降解成三堆各自都存在的现成数据,是全篇最具工程判断力的设计,也是同类工作最容易卡死的地方。VTP 显式写出场景/情绪/动作,等于把风格控制从隐式条件变成可检查的中间产物,调试友好。Prefix Streaming 承载干净潜变量以抑制后段退化,说明作者清楚流式生成的病根是误差累积而非单块质量。但要泼几盆冷水:RTF 1.293 意味着生成 1 秒内容需要约 1.29 秒,仍未跨过实时门槛,而这是在四张 GPU 上取得的——按单卡折算的成本相当高,离真实的交互式数字人部署还有距离;论文摘要只给了 RTF 这一个硬数字,语音自然度、唇音同步、身份保持、指令遵循等关键质量维度均无量化对照,「Expressive」这个卖点因此缺乏支撑;分辨率停在 400×720 这类竖屏小尺寸,也暗示更高分辨率下的开销尚未解决。此外教师-学生蒸馏引入的质量损失有多大、四步是否已是下限,摘要层面都没有交代。 3. AdvFD:对抗表征治好FD指标刷分症 AdvFD: Boosting Visual Generation via Adversarial Fréchet Distance Loss | 北京大学·快手可灵(KlingAI Research) | arXiv:2608.11205 ⚠️ 前序问题:Fréchet 距离近来成为生成器后训练中有效的分布级目标,可以补充传统的逐样本扩散与流匹配损失。但直接优化 Fréchet 目标会引发「Fréchet hacking」:目标指标持续改善,而视觉质量以及在其他特征空间下的 Fréchet 对齐却可能停滞甚至恶化。作者把这一失效归因于现有 Fréchet 损失所依赖的静态预训练特征空间——它对真实与生成分布之间的差异只提供了不完整且固定的视角,生成器于是学会往这个固定视角的盲区里钻。 本文贡献:提出 Adversarial Fréchet Distance(AdvFD),用一个经过校准的对抗学习表征来补充 FD-Loss 中的静态表征目标。AdvFD 在原有静态 Fréchet 目标之外增加一个可学习表征:该表征对抗性地最大化真实与生成样本之间的 Fréchet 差异,而生成器则在由此产生的自适应特征空间中最小化同一差异。为防止对抗表征通过特征幅值放大来平凡地抬高目标,作者进一步引入真实特征白化(real-feature whitening),归一化其尺度与协方差几何,稳定这一 min-max 优化。 Overview of our adaptive training. (a) In the G-step, the generator is updated to minimize the static Fréchet objective together with the adaptive Fréchet discrepancy, while both the static and adversarial representations are frozen. (b) In the D-step, the generator is frozen, and the adversarial representation is updated to maximize the Fréchet discrepancy between real and generated distributions. The two steps alternately improve the generator and adapt the representation to discrepancies missed by the fixed encoder. 实验效果:大量实验表明 AdvFD 在 JiT 与 pMF 两种骨干、以及不同模型规模上,都能一致提升一步生成器的后训练效果。 AdvFD mitigates Fréchet hacking in one-step generation. Top: Compared with JiT-L trained using the static FD loss, AdvFD generates cleaner and more coherent images under the same 1-NFE sampling budget. Bottom: AdvFD consistently reduces FD-r3 and FD-r6 across JiT-L and JiT-H, with relative improvements of 41.4%/38.0% and 34.0%/32.1%, respectively, showing that the gains persist as the generator scales up. These results demonstrate improved perceptual quality and generalization across evaluation representations. Lower is better for all metrics. 批判点评:这篇最有价值的贡献是把一个大家隐约感觉到但很少被正面命名的问题定义清楚了:指标一旦进入训练回路,就会被优化压力反向利用。「静态特征空间提供固定且不完整的视角」这个归因很到位——它解释了为什么 FD 越刷越好而人眼看着没变好,也顺带把「刷 FID 即进步」的行业习惯拖到了聚光灯下。real-feature whitening 这个细节尤其体现作者对 min-max 训练的实战理解:不加约束的对抗表征最省力的作弊方式就是把特征整体放大,白化直接封掉了这条路。局限也不难看出:引入对抗表征等于把一个稳定的分布级损失换成了 GAN 式的 min-max 优化,训练稳定性与超参敏感性天然变差,白化只是缓解而非根治,论文对失败模式与调参代价的交代不足;「一致提升」这类措辞在摘要中缺少具体数字支撑,读者无法判断增益是显著还是边际;验证骨干限于 JiT 与 pMF、场景限于一步生成器后训练,对多步扩散或视频生成是否同样奏效未知;更微妙的是,用对抗表征衡量的「改善」本身也是一个可被 hack 的目标,这个套娃问题论文并未回答。 4. Stream Forcing:统一训练轨迹让流式视频FVD降36.6% Stream Forcing: Constructing Unified Training Trajectory for Robust Streaming Video Generation | 华中科技大学·地平线·Anyverse Dynamics | arXiv:2608.10439 ⚠️ 前序问题:流式视频生成对世界建模潜力巨大——未来帧必须在线逐步推断以形成连续视频流。但流式视频扩散模型存在一个根本性的训推不匹配:推理遵循一种特化的去噪顺序,而先进的训练策略通常需要多样的噪声级配置。于是训推一致性与训练覆盖面成了一对只能二选一的矛盾。 本文贡献:把视频扩散采样重新表述为一个以帧为索引、在噪声级上的随机过程。在这个随机过程空间内构造一条连续的训练轨迹,沿该轨迹采样调度从独立采样逐步演化到与推理一致的采样,从而不再需要在两端之间做取舍。作者进一步引入联合校准算法与时间相关采样算法,以保证轨迹平滑性与跨帧相关性。基于这些设计提出 Stream Forcing,一个兼顾训练充分性与推理效率的流式视频生成统一训练框架。 Overview of the curriculum training. Our method builds a continuous curriculum transition between independent training and inference-aligned training that balances full distribution coverage with consistency at inference time. 实验效果:UCF-101 基准上 FVD 改善 36.6%;方法还能稳健地零样本外推到长时程视频生成,在 UCF-101 上 FVD 改善 27.9%。 Visualization of unconditional video generation on UCF-101 dataset. DF: Diffusion Forcing df. AR-D: AR-Diffusion ardiff. Our method presents higher visual quality and more robust long-horizontal extrapolation. 批判点评:把「训推一致性 vs 训练覆盖」这对二元对立改写成一条连续轨迹上的渐变,是个漂亮的问题重构——它承认两端都有价值,用课程式过渡取代硬性选边,本质上和退火、课程学习属于同一族智慧,但用在噪声级调度这个具体位置上是新的。36.6% 的 FVD 改善幅度不小,长时程零样本外推还能保住 27.9%,说明训练轨迹确实带来了泛化性而非仅仅拟合了评测设置。不过要打的折扣不少:UCF-101 是分辨率低、类别有限的老基准,在它上面的 FVD 增益能否迁移到 720p 开放域文生视频,完全无法从这篇推断,而流式生成的真实战场恰恰在后者;「联合校准」与「时间相关采样」两个算法被摘要一笔带过,它们各自贡献多少增益、引入多少训练开销,没有消融交代;连续轨迹意味着需要设计演化时间表,这又是一组新超参,敏感性未知。此外流式生成最该报的延迟、首帧时间、单帧算力等在线指标一个都没出现,「推理效率」的主张目前只有结构性论证而无实测支撑。 5. SparSTAR:免训练块稀疏注意力720p提速1.6倍 SparSTAR: Sparse Attention for SpaceTime AutoRegressive Video Synthesis | 西江大学(Sogang University) | arXiv:2608.10519 ⚠️ 前序问题:InfinityStar 通过图像金字塔与片段金字塔的序列把视觉自回归生成扩展到视频,但它不断变化的尺度与跨片段上下文让后期尺度的注意力开销高昂,也使得从扩散模型或图像 VAR 模型直接搬来的稀疏模式变得不可靠。 本文贡献:提出 SparSTAR,一种为该设定量身定制的免训练块稀疏注意力方法。在每个高开销尺度与每个注意力头上,SparSTAR 依据当前的 query 与 key 激活对连续的 key block 打分,保留必需的条件上下文,并通过一条仅前向的稀疏路径执行选中的块。作者系统分析了片段内的跨尺度一致性、跨片段边界的模式持续性,以及复用跨越越来越远尺度时的质量退化。这些分析一致表明重要 key block 会发生漂移,因此在每个目标尺度重新计算块选择比复用迁移来的 mask 更可靠。 Overview of SparSTAR, a training-free block-sparse attention framework for video autoregressive generation that reduces attention latency while maintaining video quality. 实验效果:在 720p 文生视频与图生视频上,SparSTAR 保留了全部 token 与精修尺度,提供约 1.6 倍端到端加速,同时 VBench 分数与配对输出重建保真度接近稠密的 InfinityStar。 PSNR--latency trade-off for recalibration frequency on 720p T2V. Error bars denote 95% confidence intervals for PSNR across five seeds. 批判点评:这篇的贡献首先是一个诚实的否证:它没有先摆出方法再补实验,而是先系统测量「从别处迁移来的稀疏 mask 在变尺度自回归结构下到底能不能用」,得到的答案是不能——重要 key block 会随尺度漂移。这个结论比方法本身更有传播价值,因为当前有相当多加速工作默认稀疏模式具备跨设定可迁移性。免训练、仅前向、保留全部 token 与全部精修尺度这几条约束定得很克制,意味着它可以直接挂到现成模型上而不牵动生成质量的责任边界,工程可用性高。但天花板也被这份克制锁死了:1.6 倍加速对视频生成的实际体感改善有限,距离能改变产品形态的量级尚远;方法与 InfinityStar 的金字塔结构深度绑定,对当下更主流的视频 DiT 是否适用没有讨论,通用性存疑;每个尺度重新打分本身要花算力,摘要只说「保真度接近」,这类模糊表述掩盖了具体的质量损失幅度,而稀疏注意力最该担心的正是长时程一致性这种在 VBench 上不易暴露的退化。此外单一机构、无顶会标注、缺少与 SVG、SpargeAttn 等同类稀疏注意力方法的横向对比,也让它的相对位置不好判断。 6. Latent-to-4D:绕过RGB用视频潜变量直出4D Beyond Pixels: From Video Priors to 4D Worlds | 浙江大学 ReLER·CCAI | arXiv:2608.10744 ⚠️ 前序问题:4D 生成要从文本或图像等条件合成动态 3D 场景。现有方法分两派:一派把生成好的 RGB 视频再用一个独立的 4D 模型去重建,另一派改造某个特定视频生成器让它直接预测几何。前者受分布不匹配与误差传播之苦——视频生成器的输出分布并非 4D 重建模型所期望的输入分布;后者则把 4D 预测绑死在特定生成器上,生成器或条件方式一变就可能要重训。 本文贡献:作者提出一个新问题:共享同一个 VAE 的视频模型,其最终去噪潜变量能否充当通往显式 4D 预测的可复用接口?基于这一洞察提出直接的潜变量到 4D 生成,并实例化为 Latent-to-4D:它绕过 RGB,把视频潜变量与预训练 4D 解码器的 token 网格对齐,再通过逐帧与全局时空注意力加以精修。仅用约 1K 现有重建片段训练,单个 checkpoint 就能在同一 VAE 家族内的多个视频扩散 Transformer 之间原样迁移,无需重训。 Latent-to-4D training pipeline. A frozen video VAE encodes an observed video into a VAE-space latent. L4AR aligns the latent grid through a learned 3D convolution, reuses frozen camera and time tokens, and refines the representation through alternating frame-wise and global attention. The 4D decoder predicts cameras and dynamic world-space geometry. 实验效果:在 Text4D-200 与 I4D-200 上,Latent-to-4D 在基于投影的 DINO-F1 指标上分别超过同潜变量的 Wan+4RC 级联 2.88–3.45 与 5.81 点,并在几何、时间稳定性与整体质量上更受人类评审者青睐。 Image-to-4D comparison. Each row shows the input condition and 4D results. RGB baselines reconstruct the decoded video, whereas Ours consumes its terminal latent directly. 批判点评:「把共享 VAE 的潜变量当作跨模型可复用接口」这个提法很有工程审美——它没有再造一个更大的 4D 生成器,而是在既有生态里找到一个天然存在却被忽视的对接面,顺手解决了级联方案的分布不匹配和专用方案的绑定问题。约 1K 训练片段、单 checkpoint 跨多个视频 DiT 原样迁移,这个数据效率与复用性在 4D 生成里相当难得,也说明潜变量确实承载了足够的几何信息,RGB 那一步真的是多余的信息瓶颈。但边界必须说清楚:可迁移性严格限定在「同一 VAE 家族」内,一旦 VAE 换代或换厂,接口即失效,这与其宣称的通用性之间存在张力,且视频模型的 VAE 恰恰是迭代很快的部件;2.88–5.81 点的 DINO-F1 增益是相对同潜变量的 Wan+4RC 级联,属于自设对照,未与更强的专用 4D 生成方法正面比较;投影域的 DINO-F1 本身是间接指标,无法直接反映几何精度,人类偏好评测又缺样本量与统计显著性说明。此外训练依赖预训练 4D 解码器,其能力上限就是整套方案的上限,动态范围、拓扑变化剧烈的场景表现如何未见交代。 7. MeanSR:一步超分免蒸馏直接学平均速度场 MeanSR: Restoration Trajectory Learning for One-Step Perceptual Super-Resolution | 西北工业大学 | arXiv:2608.09405 ⚠️ 前序问题:基于扩散的超分能获得强感知质量,但需要昂贵的迭代去噪。现有一步蒸馏方法虽然压缩了推理时间,却依赖昂贵的预训练教师模型;代表性方法 CTMSR 通过 PF-ODE 一致性训练避开了蒸馏,但它只是约束网络行为,并没有显式建模从低分辨率输入到高分辨率图像的那个修复动力学过程。 本文贡献:提出 MeanSR,一种一步感知超分方法:学习一个以低分辨率图像为条件的平均速度场,直接刻画从退化或带噪输入到合理高分辨率输出的有限时间转移。平均速度与瞬时速度之间的关系本身即提供直接的训练信号,同时保留单步推理。作者进一步把分布轨迹匹配目标重新表述以适配平均速度生成,并引入阶段感知的时间采样(Stage-Aware Temporal Sampling)策略改进轨迹学习。 Overview of the proposed MeanSR framework. Stage 1 estimates an LR-conditioned restoration trajectory by predicting its average velocity under the MeanFlow formulation, while Stage 2 further aligns the generated restoration trajectory with the real HR trajectory through distribution trajectory matching. The proposed Stage-Aware Temporal Sampling (SATS) assigns different temporal distributions to trajectory estimation and trajectory alignment, respectively. 实验效果:在合成与真实世界基准上,MeanSR 在 CLIPIQA、MUSIQ、MANIQA 三项感知指标上均优于 CTMSR,同时显著降低 FLOPs 与推理延迟;重建出的结构更锐利、纹理更真实,感知伪影更少。 Comparison of representative one-step super-resolution methods. The x-axis denotes CLIPIQA, the y-axis denotes inference runtime, and the bubble size represents FLOPs. MeanSR achieves a favorable trade-off between perceptual quality and computational efficiency. 批判点评:这篇的定位很清楚:把 MeanFlow 那套「学平均速度场」的思路搬到超分,从而在免蒸馏的前提下把修复过程本身建模出来,而不是像 CTMSR 那样只用一致性去间接约束网络行为。这个区分是有实质的——显式的有限时间转移让训练信号直接指向「从退化态到清晰态该怎么走」,也自然解释了为何能同时改善质量并降低 FLOPs。摆脱教师模型对下游落地的意义同样实在,省掉的是一整套预训练成本。但它的贡献属于路径迁移而非原理创新,MeanFlow 的核心恒等式并非本文所出,主要工作是条件化与采样策略适配。评估层面问题更明显:三项指标 CLIPIQA/MUSIQ/MANIQA 全是无参考感知指标,众所周知偏好锐利与高对比,缺少 PSNR/SSIM/LPIPS 的配套报告,无法排除「感知分上去了但保真度掉了」这种典型的一步超分退化;主要对照仅 CTMSR 一家,未与 OSEDiff、SinSR 等一步扩散超分做完整横比;论文标注为投稿 AAAI 2027、仅 7 页,尚未经同行评审,Stage-Aware Temporal Sampling 的消融强度也难以从摘要判断。 8. ATDEdit:免掩码异步解码编辑达27.44dB Diffusion Image Editing via Asynchronous Token Decoding | 广东工业大学·香港浸会大学·北京大学·惠州学院 | arXiv:2608.09322 ⚠️ 前序问题:文本引导的扩散图像编辑要在修改语义属性的同时保住身份、布局与背景。但采样过程中简单地切换文本条件往往引起全局漂移——去噪动力学会把改动沿 token 传播开,进而破坏本不该改的区域。现有方案通常依赖外部或用户提供的空间掩码,或者需要微调模型。 本文贡献:提出 ATDEdit(Asynchronous Token Decoding Edit),一个推理期框架:把采样器的每一步视为对一个全局耦合 token 矩阵的并行更新,从而支持按 token 索引切换条件并施加差异化的更新策略。它不对所有 token 同步施加目标条件更新,而是用逐 token 的条件意外度(conditional surprisal)估计可编辑位置,仅对选中的 token 集合施加目标条件修正;在保留 token 位置提供源 key/value 记忆,并把选中的保留 token 潜变量行回投到其源值。这些操作促进背景保持,但作者明确声明其不构成像素级不变性保证。整套方法无需外部或用户提供的空间掩码,也无需模型微调。 Overview of ATDEdit for transforming a fox into a dog. (Top) Same-state source/target evaluations produce Token-wise Conditional Surprisal and an editable-token mask. (Bottom) Target-conditioned corrections are applied to editable tokens, while source key/value memory and hard projection constrain selected keep-token rows. 实验效果:在 PIE-Bench 上,ATDEdit 取得该基准上已报告的最强保持性指标,包括 27.44 dB PSNR 与 0.055 LPIPS,同时保持有竞争力的语义对齐。已被 ACM MM 2026 接收。 Comparison of edited results. Real images are in the first column. 批判点评:用「条件意外度」在推理期自动划定可编辑 token,是这篇最漂亮的一笔——它把「哪里该改」从需要人工掩码或额外分割模型的外部输入,转成模型自身条件响应差异的内生信号,免训练、免掩码这两个属性叠加起来带来的实用性相当高。更值得称赞的是学术诚实度:论文明确写出这些操作「促进背景保持但不构成像素级不变性保证」,在一个惯于把机制性偏好包装成理论保证的领域,这种自我设限反而提升了可信度,也准确点出了本方法的性质——它是软偏置而非硬约束。27.44 dB / 0.055 LPIPS 的保持性数字确实扎实。但需要警惕保持性与编辑力度的天然此消彼长:保持性做到基准最强,而语义对齐只被描述为「有竞争力」,这个措辞差异很可能意味着在需要大幅改动的编辑任务上它偏保守;意外度阈值 ρ(t) 是核心超参,其跨图像稳健性与失败模式摘要未交代,若阈值偏保守则编辑区域覆盖不全,偏激进则退回全局漂移;PIE-Bench 单一基准也不足以覆盖真实编辑意图的多样性,尤其是涉及大范围结构变化或多对象组合的情形。 9. CtrlSpeech:音素级控制音高音量与时长 CtrlSpeech: Coarse-to-Fine Control for Expressive Speech Synthesis | 德克萨斯大学奥斯汀分校·Amazon | arXiv:2608.08362 ⚠️ 前序问题:近来的 TTS 系统已实现很强的自然度与零样本音色克隆,但在词级或音素级上对富有表现力的语音做细粒度控制仍然困难——用户能换音色,却很难精准指定某个字要更重、更高或拖得更长。 本文贡献:提出 CtrlSpeech,一个具备由粗到细控制能力的可控表现力 TTS 框架。它构建在 DiTAR 架构之上,把全局说话人条件与音素对齐的音高、音量、时长信号结合起来,从而在保留目标说话人音色的同时实现局部韵律控制。这一设计让用户能在很细的时间粒度上调整表现力属性,使语音精修更灵活可控。 The architecture of . 实验效果:实验表明 CtrlSpeech 在零样本 TTS 上取得有竞争力的表现,并改善了对表现力属性的可控性,验证了其在灵活实用的表现力语音合成上的有效性。已被 Interspeech 2026 接收,Demo、代码与模型权重均已公开。 Coarse-to-fine speech control pipeline. 批判点评:把控制信号锚定在音素级的音高、音量、时长三元组上,是个务实到近乎朴素的选择,但恰好对上了配音、有声书这类真实生产流程的操作直觉——从业者要的正是「这个字重读一点」,而不是再来一个模糊的情绪标签。全局说话人条件与局部韵律控制解耦,保证了调韵律不串音色,工程上很关键。Demo、代码、权重三件套齐放,在 TTS 这个复现门槛偏高的方向里是实打实的加分项。但这篇的定位应当被诚实地看作扎实的增量工作而非突破:音素级韵律控制在 FastSpeech 2 时代就是标准配置,本文的实际贡献更像是把这套显式控制接口迁移并适配到 DiTAR 这个较新的自回归-扩散混合架构上;摘要通篇没有一个具体数字,「有竞争力」与「改善了可控性」这类表述无法支撑与 CosyVoice、F5-TTS 等主流系统的强弱判断;控制粒度也仍停在音高/音量/时长这些声学低层属性,对情绪、语气、口音等更高层表现力维度没有覆盖。此外六页的 Interspeech 短文体量,注定其消融与主观评测的深度有限。 10. Sci-VBench:16个前沿模型科学因果全线不及格 Sci-VBench: Evaluating Knowledge- and Reasoning-Intensive Video Generation in Science Domains | 浙江大学·中国科学院大学·同济大学·耶鲁大学 | arXiv:2608.09873 ⚠️ 前序问题:视频生成模型的视觉真实度进步很快,但它们是否真的掌握了科学知识与因果动力学,一直缺少有效的衡量方式。现有评测大多停留在表层视觉合理性,无法区分「画面看起来对」与「物理与科学过程真的对」。 本文贡献:提出 Sci-VBench,一个评测跨科学领域的知识密集与推理密集视频生成的综合基准。它包含 1,253 条专家标注样例,覆盖自然科学、健康医疗、人文社科、工程四大学科下的 60 个学科方向。每条样例都要求模型生成在时间上信息丰富、需要科学推理与知识落地的视频,而非仅有表层视觉合理性。作者进一步建立了基于评分细则(rubric)的评测协议,并验证在该协议下非专家人类评审者与 MLLM-as-Judge 系统都能与专家判断达成较高一致,从而支撑可规模化的可复现评测。 Overview of the dataset. Top left: distribution of the expert-annotated examples over subjects across core disciplines. Remaining panels: representative prompt--video examples from each discipline, generated by Gemini-Omni-Flash, where faithful generation requires grounding in the underlying scientific mechanism. 实验效果:对 16 个前沿闭源与开源模型的评测显示:自动感知质量分数在各系统间挤成一团,而在提示词落地(Prompt Grounding)以及科学与因果正确性上的表现差异显著,闭源与开源之间存在明显差距。这表明视觉真实度的进步尚未转化为对科学与因果动力学的可靠建模。已被 COLM 2026 接收。 Overview of the benchmark construction process. 批判点评:这篇的核心发现极具诊断价值:感知质量分数在 16 个模型间几乎无法区分,而科学与因果正确性上分差巨大——这直接说明当前主流视频生成评测已经饱和失效,大家在一个分辨不出好坏的维度上继续内卷。rubric 协议加上「非专家与 MLLM-as-Judge 都能对齐专家判断」的验证,是这类主观性强的基准最该做却常被省略的一步,它把可规模化评测的成本问题真正解决了。1,253 条专家标注、60 个学科的覆盖面也称得上扎实。作为评测工作,它的价值恰好与今天的 LDR 形成呼应:一个证明外推是可能的,一个证明现有模型普遍做不到。局限主要在方法论固有处:MLLM-as-Judge 与人类专家「较高一致」是在这套 rubric 下成立,一旦作为主要评分手段大规模使用,就存在被针对性优化的风险,届时它会重演今天感知指标的命运;四大学科 60 方向的样例分布必然不均,摘要未交代各领域样本量,跨领域分数可比性存疑;「科学正确性」在很多场景下需要专业判断,rubric 能否覆盖领域细微差别仍待检验。此外基准只能揭示差距而不提供改进路径,闭源领先的具体成因(数据、规模还是后训练)无法从中推断。 趋势观察 世界模型的评判标准从「像不像」转向「外推得出来吗」 — 今天最值钱的一篇是 UCSD 与 Adobe 的 LDR。它把一个长期被含糊处理的问题摆到台面上:主流视频扩散模型是在拟合像素,而不是在建模像素如何随时间转移,所以它们能渲染出视觉上合理的帧,却未必真的遵守运动定律。LDR 的做法很硬核——把潜空间的状态转移显式写成运动学积分,低阶动力学(速度、加速度)直接数值积分算出来,网络只负责回归三阶及以上的残差项。这等于把物理先验从「希望模型自己学到」变成「架构层面直接给定」。效果上,分布内与分布外误差的差距比视频扩散基线小了 20 倍以上,参数量少 26 倍、速度快 143 倍;只用红球从左往右运动训练,却能正确预测蓝色方块从右往左的运动。作者称这是首个能把学到的动力学外推到训练分布之外的视频世界模型。这条线索的意义在于,它把世界模型的验收标准从「生成质量」拽回到「泛化到没见过的物理配置」,也预示配套评测会跟着变——同一天浙大与耶鲁的 Sci-VBench 正好给出了另一个佐证:视觉真实度分数在 16 个前沿模型间挤成一团,而「提示词落地」与「科学因果正确性」的分差却很大,说明画面变好并没有自动带来对科学与因果动力学的可靠建模。 生成模型的训练目标本身正在被重新审计 — 北大与快手可灵的 AdvFD 指出一个很扎心的现象——「Fréchet hacking」:用 Fréchet 距离做生成器后训练时,目标指标一路走高,但视觉质量和在其他特征空间下的 Fréchet 对齐却可能停滞甚至变坏。根因是现有 FD-Loss 依赖静态的预训练特征空间,它对真实与生成分布之间差异的观察视角是固定且不完整的,于是生成器学会了往这个固定视角的盲区里钻。AdvFD 的解法是给静态目标补一个对抗学出来的表征:判别侧最大化该表征下的 Fréchet 差异、生成侧最小化同一差异,并用真实特征白化把它的尺度与协方差几何归一,防止对抗表征靠单纯放大特征来虚增目标。这类工作和「刷 FID 就等于变好」的旧习惯正面冲突,提醒我们指标一旦进入训练回路就会被优化压力反向利用。今天的 ATDEdit 从另一头呼应了同一种审慎——它明确声明自己的 KV 记忆与潜变量回投「促进背景保持,但不构成像素级不变性保证」,在一个人人爱声称 SOTA 的领域里,把话说到这个精度反而更可信。 视频推理加速开始区分「训练-推理对不齐」和「算力花在哪」两类病 — 今天有两篇从不同层面攻视频生成的效率。华科与地平线的 Stream Forcing 处理的是流式视频扩散的结构性顽疾:推理必须按一个特化的去噪顺序逐帧在线推进,而先进训练策略又需要多样的噪声级配置,两者天然冲突——训练覆盖面和训推一致性只能二选一。它把视频扩散采样重写成一个以帧为索引的、在噪声级上的随机过程,然后在这个过程空间里构造一条连续训练轨迹,让采样调度从独立采样平滑演化到与推理一致的采样,UCF-101 上 FVD 改善 36.6%,长视频零样本外推再改善 27.9%。Sogang 大学的 SparSTAR 走的是另一条路——不动训练,只在推理时省算力:它发现从扩散或图像 VAR 模型搬来的稀疏注意力模式在 InfinityStar 这种「图像金字塔 + 片段金字塔」的变尺度结构下并不可靠,重要的 key block 会随尺度漂移,所以每到一个目标尺度就重新算一次块选择,比复用迁移来的 mask 稳得多,720p 端到端约 1.6 倍加速且不丢 token 与精修尺度。一个改训练轨迹、一个改推理时的块选择,共同点是都先诚实地承认了「照搬别处的经验在这里会失效」。 少步化从图像生成蔓延到修复类任务,路径也从蒸馏转向直接学速度场 — 西北工业大学的 MeanSR 是个值得注意的信号:一步感知超分不再依赖昂贵的预训练教师做蒸馏,而是学一个以低分辨率图像为条件的平均速度场,直接刻画从退化/带噪输入到合理高分辨率输出的有限时间转移。这条路子承自 MeanFlow 一脉——平均速度与瞬时速度的关系本身就能提供训练信号,从而在保留单步推理的同时绕开教师模型。它对标的 CTMSR 虽然也免蒸馏,但只靠 PF-ODE 一致性约束网络行为,并没有显式建模支配修复过程的那个场。结果是 CLIPIQA/MUSIQ/MANIQA 全面超过 CTMSR,同时 FLOPs 与延迟大幅下降。把它和 AdvFD 放在一起看会更有意思:两者都在追问「我们到底该让生成器拟合什么」——一个说该拟合自适应的分布差异,一个说该拟合有限时间的平均速度场,而不只是逐样本的去噪方向。 端到端多模态交互的落地瓶颈,正从「能不能生成」变成「能不能流着出」 — 香港中文大学(深圳)与腾讯光子的 Ex-Omni-2D 挑明了当前全模态对话模型的一个体感缺陷:它们能理解多模态输入、能合成语音回复,但回复在视觉上是「无身体」的。它让模型先产出一个描述场景、情绪、动作的结构化 Visual Thought Plan,再生成回复文本与原生多码本语音单元,而这些语音单元同时充当共享的声学-时间接口,一边解码成语音、一边在线对齐视频帧——这个设计的实际价值是让回复通路与形象通路可以各自从异质的语音、对话、形象视频数据中学习,避开了「查询-文本-语音-视频」四元组大规模标注这个几乎不可能满足的前提。真正的工程含金量在流式那一步:把全序列视频教师蒸馏成少步的块因果 Streaming Student,用 Prefix Streaming 把干净潜变量跨块携带下去,抑制后段块的累积退化,四步推理、四卡在 400×720 下达到端到端 RTF 1.293。RTF 略大于 1 说明还不算真正实时,但已经把这条链路推到了可以谈产品化的操作点上。 人工智能炼丹君 整理 | 2026-08-13 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-12|阿里DUET两步视频质量多样性双赢 今日 AIGC 论文速览 今日共 10 篇 · 视频生成加速与少步蒸馏 3 篇 · 统一多模态表征与理解生成一体化 1 篇 · 音频与音乐生成 3 篇 · 扩散架构机理与图像编辑 2 篇 · RGBA 视频与资产生成 1 篇 重点论文标题列表 DUET(阿里巴巴·北京大学·清华大学深圳国际研究生院):两步视频生成质量多样性双赢 UniSpace(美团):8B统一模型扔掉VAE通路 SonicWeave(快手可灵团队·香港中文大学·清华大学深圳国际研究生院):一套权重生成全类音频场景 FullDiT(复旦大学·阿里巴巴 Token Foundry):音乐生成胜过五家商业系统 adaLN-Gaussian(北京大学·百度·UC Berkeley):零初始化才是DiT的真功臣 今日论文速览 1. DUET:两步视频生成质量多样性双赢 DUET: A Diversity-Quality Duet of Distillation Experts for Two-Step Video Generation | 阿里巴巴·北京大学·清华大学深圳国际研究生院 | arXiv:2608.09637 关键词:两步视频生成,少步蒸馏,质量多样性权衡,专家分工,流匹配 前序问题:扩散模型能生成高质量视频,但迭代采样的开销让实际部署很难受。少步蒸馏是主流解法,却暴露出一个绕不开的质量-多样性权衡:轨迹级蒸馏(如 sCM)倾向保住多样性但质量偏弱,分布级蒸馏(如 DMD)质量强但生成结果的结构多样性大幅塌缩。此前的工作大多试图在 loss 层面把两类目标混合调和,结果总是按下一头翘起另一头,且混合目标本身的优化难度还额外增加了训练成本。 本文贡献:面向极端的两步视频生成,提出 DUET,把权衡改造成噪声层面的专家分工:sCM 专家接管高噪声那一步,负责铺开多样的结构布局;DMD 专家接管低噪声那一步,负责精修外观细节。两个专家各自按原生目标独立训练,因此完全绕开了 loss 级组合的优化困难,质量与多样性是联合获得而非互相交换。作者进一步指出剩下的瓶颈在于「接力界面」和高噪声阶段本身,用 RL 引导的专家自适应加以解决,得到 DUET+。 实验效果:在 Wan2.1-T2V-1.3B 骨干上,DUET 把 sCM 的两步质量拉到接近 DMD 的水平,同时几乎完整保留其结构多样性——约为 DMD 的两倍;DUET+ 在保住这一多样性优势的同时进一步提升整体质量。 批判点评:这篇的洞察很值钱:把「质量 vs 多样性」从一个需要折中的标量权衡,重新表述成「不同噪声区间需要不同归纳偏置」的分工问题,从而让两个专家都能按最适合自己的目标训练。这比在 loss 里加权重系数干净得多,也解释了为什么此前的混合方案总在原地打转。局限也很清楚:两步生成需要同时维护两个专家权重,显存与部署复杂度是单模型方案的两倍,论文对这部分成本交代不足;「接力界面」被承认是瓶颈,说明高噪声专家交给低噪声专家的中间状态存在分布不匹配,DUET+ 用 RL 打补丁而非从原理上解决;此外骨干只验证了 1.3B 的 Wan2.1,在 14B 级别模型上噪声分工的最优切分点是否仍在同一位置,完全未知。 2. UniSpace:8B统一模型扔掉VAE通路 UniSpace: Unified Visual Representation and Scalable Multimodal Modeling | 美团 | arXiv:2608.08676 关键词:统一多模态,视觉表征,Patch重参数化,理解生成一体化,MoE 前序问题:语义视觉编码器已成为多模态理解和图像生成语义条件化的核心接口,但它的最终 token 会丢弃细粒度视觉细节,导致像素重建能力很差,因此无法直接用在图像生成、编辑这类对重建敏感的任务上。业界的通行做法是另外挂一条 VAE 通路专门负责重建,代价是架构分裂、两套表征空间难以对齐。 本文贡献:作者先做了一个反直觉的诊断:语义 ViT 的冻结 Transformer 块并非本质上无法保留视觉细节,真正把表征推向语义抽象、让细粒度信息难以从最终 token 恢复的,是原始的 patch 参数化方式。基于此提出 Patch Reparameterization——保留原有语义通路不动,另加一条重建感知的 patch embedding,把细粒度视觉信息送进同一批冻结 ViT 块。由此得到的统一表征既保住多模态理解能力,又能做高保真图像重建,重建-生成权衡曲线更优。作者进一步把这套表征放大成 UniSpace,一个 8B 的 Mixture-of-Transformer-Experts 模型,在同一个视觉空间里完成理解、生成和编辑,完全不需要独立的 VAE 通路。 实验效果:系统级评测显示模型具备可用的文生图能力与指令式图像编辑能力,验证了「重参数化后的预训练 ViT 可以充当可扩展多模态建模的统一视觉接口」这一主张。 批判点评:把矛头指向 patch 参数化而非 Transformer 块本身,这个归因方向是这篇最有价值的部分——它意味着大量「语义编码器保不住细节」的结论可能都是参数化方式的问题,而不是架构的固有缺陷,从而打开了「保留冻结语义骨干、只改输入侧」的低成本改造空间。去掉 VAE 通路对统一模型的架构简化意义很实在。但也要冷静看:论文用「practical text-to-image generation」这类措辞而非硬指标对比,说明生成质量距离专用 T2I 模型仍有明显差距,8B MoTE 的规模也不小;「重建-生成的有利权衡」是相对自身消融而言,缺少与 VAE 方案在同等算力下的正面对照;另外冻结 ViT 的容量上限是否会在更大规模上成为瓶颈,文中没有给出 scaling 证据。 3. SonicWeave:一套权重生成全类音频场景 SonicWeave: Chunk-Routed Mixture-of-Experts for Unified Audio Scene Generation | 快手可灵团队·香港中文大学·清华大学深圳国际研究生院 | arXiv:2608.09571 关键词:统一音频生成,Chunk路由MoE,流匹配,音频场景合成,专家专业化 前序问题:文本条件的通用音频生成正从孤立的语音、音乐、音效合成,走向用单个模型把它们组合成可控、连贯的音频场景。这个统一设定格外棘手:异质成分对共享骨干提出互相冲突的结构要求,而一个复杂混合场景内部还可能包含局部不同甚至相互重叠的内容,需要在同一段音频里做细粒度自适应。现有音频 MoE 大多在领域级别做路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。 本文贡献:提出 SonicWeave,一个面向统一音频场景生成的流匹配模型,核心是带冲突门先验-证据路由机制的 chunk 级 MoE(CPE-MoE)。它按连续的声学 chunk 做路由,把编码结构化文本条件与扩散阶段的全局先验,和来自演化中声学状态的局部证据结合起来;一个学出来的冲突门在局部状态不可靠时倾向采信全局先验,只在某区域明显偏离全局场景语境时才让局部证据主导路由。单套权重即支持语音、音乐、音效、歌声及其细粒度混合。 实验效果:在 TTS、TTA、TTM 三类基准上一致优于受控的 Dense 与 Base-MoE 基线;复杂场景评测进一步显示组合质量提升,路由分析揭示出跨扩散阶段的内容相关专家专业化现象。 批判点评:「按 chunk 路由」这个粒度选择切中了要害:语音的音素、音乐的节拍、音效的事件都是有时间跨度的结构,逐 token 决定专家等于在同一个声学事件内部反复换脑,chunk 级正好对上声学连续性。冲突门的设计也挺聪明——扩散早期局部状态本来就是噪声,此时强行采信局部证据只会引入路由抖动,用全局先验兜住是对的。不足在于对比强度:论文的对照是自己控制的 Dense 与 Base-MoE 基线,而非各领域的 SOTA 专用模型,所以「统一模型是否已经不输专精模型」这个最关键的问题没有回答;chunk 长度作为一个关键超参,其敏感性分析在摘要层面没有体现;此外 MoE 的实际激活参数量与推理开销未交代,工业落地时的性价比无法评估。 4. FullDiT:音乐生成胜过五家商业系统 Beyond Reconstruction: Full-Context Generative DiT for Music Generation | 复旦大学·阿里巴巴 Token Foundry | arXiv:2608.08787 关键词:音乐生成,暴露偏差,条件DiT,RVQ编解码,分类器无关引导 前序问题:混合式音乐生成器把自回归语言模型的长程规划能力,和扩散/流模型渲染器的高保真结合起来。但存在一个被忽视的部署错配:渲染器是用干净的、从目标推导出的 codec token 训练的,上线时却要接收语言模型的不完美预测,这就形成了 codec 接口层面的暴露偏差——训练时没见过的错误 token 分布,在推理时成了常态。 本文贡献:作者不再把渲染当成简单的重建任务,而是把它重新表述为「从一个不完美离散计划出发的全上下文生成」。为此提出 FullDiT:一个条件 DiT,融合八路帧对齐的 RVQ 流与独立编码的歌词、caption,并在完整声学隐序列上做非因果自注意力。训练阶段引入 Error-Matched Distractor Conditioning(EMDC),把每个 codebook 的替换率匹配到教师强制下的 top-1 错误率,并从余弦 KNN 邻域中采样「近似错答」token,同时不改变声学目标。推理阶段用四路 classifier-free guidance(4-CFG)独立缩放 codec、歌词、caption 三类引导增量。 实验效果:匹配消融显示 EMDC 在合成扰动下把 ViSQOL 提升 0.77,且在非并列比较中明显更受偏好;进一步消融验证了全曲上下文与渲染器侧文本条件各自的增益。完整系统在 18 项自动指标中的 15 项上超过五个商业系统,并在 Artificial Analysis 带唱音乐榜单上进入前三。 批判点评:EMDC 是这篇最扎实的一笔:不是随机加噪,而是把干扰率精确对齐到教师强制的真实 top-1 错误率,并从 KNN 邻域取「像是对的错答」,这让训练分布真正逼近推理时会遇到的错误结构,比通用数据增广讲得通得多。渲染器侧也吃歌词和 caption 这一点也很合理——语言模型的 plan 一旦出错,渲染器至少还有文本可以校正。质疑点在于评测:「18 项中的 15 项超过五家商业系统」这类表述缺少商业系统的具体版本与调用时间,商业模型迭代极快,可复现性存疑;ViSQOL 提升 0.77 是在「合成扰动」这一人造条件下测得的,真实语言模型错误分布是否同构未验证;八路 RVQ 加全序列非因果注意力意味着相当高的显存与延迟开销,论文未给出与主流方案的推理成本对照。 5. adaLN-Gaussian:零初始化才是DiT的真功臣 Unveiling the Secret of AdaLN-Zero in Diffusion Transformer | 北京大学·百度·UC Berkeley | arXiv:2608.09438 关键词:扩散Transformer,adaLN-Zero,零初始化,条件化机制,TPAMI 前序问题:扩散 Transformer(DiT)已成为图像生成的主流架构,围绕它的性能改进层出不穷,但社区对它的理解仍然停留在表面。一个典型例子是 adaLN-Zero:所有人都知道它比 adaLN 效果好,也都在用,但到底是哪一部分设计在起作用,一直没人系统回答过。 本文贡献:本文深入拆解 DiT 中的关键条件化机制 adaLN-Zero,把它的性能来源分解为三个候选要素——类似 SE 的结构、零初始化、以及「渐进式」更新顺序,并逐一做受控验证,最终证明零初始化是其中最具决定性的因素。基于这一理解,提出分析导向的初始化策略 adaLN-Gaussian:它既是对上述分析的经验验证,也是一个能稳定改善优化效率的实用初始化方法。另一方面,受 SE 式结构启发,提出改进的条件化机制 SE-adaLN-Zero。 实验效果:遵循 DiT 设置在四个数据集上做了充分实验,尤其在 ImageNet1K 上验证了 adaLN-Gaussian 与 SE-adaLN-Zero 的有效性和泛化性;除类别到图像生成之外,还在文生图任务上评估了两种改进方法的泛化能力。论文已被 IEEE TPAMI 2026 接收。 批判点评:这是今天最「不性感但最有长期价值」的一篇。当整个领域都在往上堆模块时,回头把一个被默认使用了数年的组件拆开做归因,得到的是可迁移的设计原则而不是又一个刷分技巧——「零初始化主导」这个结论对任何做残差式条件注入的架构都有参考意义,adaLN-Gaussian 作为一行初始化改动,落地成本几乎为零。局限在于实验尺度:遵循原始 DiT 设置意味着规模偏小,ImageNet1K 类别到图像生成与今天动辄十亿参数的 T2I/T2V 训练环境差距不小,零初始化的主导地位在大规模、长训练下是否依然成立需要更强证据;文生图上的泛化验证在摘要中只是一笔带过,没有给出具体量级;此外 SE-adaLN-Zero 作为结构改动会带来额外参数与算力,论文未讨论其与收益的性价比。 6. REST:把RL副产物直接当蒸馏监督 RL-Native Distillation: Exploiting Scored Trajectories for Few-Step Image Generation | 上海交通大学·阿里巴巴淘天集团 | arXiv:2608.09226 关键词:少步图像生成,RL蒸馏协同,优势调制,奖励对齐,无CFG推理 前序问题:高效文生图既需要基于强化学习的奖励对齐,也需要少步蒸馏,但这两个流程通常被串行执行:先 RL 对齐、再压缩步数。这不仅推高训练成本,还有一个隐患——压缩过程可能把前一阶段辛苦对齐来的奖励收益又丢掉。 本文贡献:作者提出一个 RL 原生视角:扩散 RL 本身就在生成带奖励分数的有限步轨迹,这些中间状态是天然的蒸馏监督来源,而不是采样过程的一次性副产物。基于此提出 REST(Reward-Enhanced Scored-Trajectory Distillation),一个单阶段的 RL-蒸馏协同训练框架,把一个解耦的学生挂到任意 RL 教师上:学生从教师不断演化的 rollout 轨迹中分段学习,而教师原本的优化过程完全不受干扰。为避免无差别模仿把教师的低奖励行为也一并保留,进一步提出 Advantage-Modulated Distillation(AMD),把 rollout 的优势值转换为基础蒸馏损失上的带符号权重——强化来自优选轨迹的监督,并轻度排斥低奖励轨迹。整个框架轻量且即插即用,不需要额外的图像 rollout、独立蒸馏数据集或对抗训练。 实验效果:在组合式生成、视觉文字渲染、人类偏好对齐三类任务上,REST 使无 CFG 的少步推理能够追平甚至超越其 40 步的 RL 教师,而额外训练成本低于纯 RL 的 25%。在 DrawBench 上 PickScore 比 RTDMD 高 0.82,且只需其五分之一的训练迭代数。 批判点评:这篇的核心洞察属于「看见了别人扔掉的东西」:RL 阶段每一步 rollout 都自带奖励分数和完整中间状态,串行流水线却把它们当垃圾清掉,然后再花一遍算力重新造蒸馏数据——指出这点之后,单阶段协同几乎是自然结论。AMD 用带符号权重区分优劣轨迹也很关键,否则蒸馏会连教师的坏习惯一起继承。落地友好度高:不改教师、不加 rollout、不用对抗训练,额外成本 25% 以内。需要打问号的地方:学生学的是教师「演化中」的轨迹,教师早期还没对齐好时的轨迹质量偏低,论文没说清如何避免学生被早期噪声带偏(是否需要 warmup 或权重退火);「追平甚至超过 40 步教师」中的「超过」很可能来自 AMD 对低奖励轨迹的排斥效应,本质上是奖励模型上的进一步过拟合,是否真正提升人类感知质量存疑;此外三类任务均偏重可自动打分的能力,对开放域美学的影响未评估。 7. EditMod:1K图编辑仅需1.57秒 Model the Edit, Not the Image: Visual Autoregressive Editing from a Source-Centric Perspective | 北京理工大学·浙江大学·腾讯·深圳大学 | arXiv:2608.09057 关键词:视觉自回归,图像编辑,源为中心,多尺度残差,免反演 前序问题:下一尺度视觉自回归模型(VAR)通过由粗到细的高效预测生成高质量图像,已是一条强有力的生成范式,但它在文本引导图像编辑上的潜力基本没被开发。现有的免训练 VAR 编辑方法大多把编辑表述为「以源图为引导或约束的目标条件重新生成」,还往往依赖反演、测试时优化、注意力控制或用户提供的掩码。这种生成为中心的表述没有充分利用 VAR 天然提供的多尺度源表征,还引入了额外计算或人工干预。 本文贡献:作者转向源为中心的 VAR 编辑视角:把编码后的源图像 token 当作主要视觉状态,编辑过程只聚焦于条件诱发的变化量。基于这一视角提出 EditMod——在共享的自回归上下文下,对比源条件预测与目标条件预测,把两者之差视为逐尺度的编辑方向,再把它作为残差更新施加到选定尺度的源 token 上。整条链路不需要反演、不需要测试时优化、也不需要用户掩码。 实验效果:实验显示 EditMod 在源图保真度上处于领先水平,同时保持很强的文本对齐能力;在单张 A100 上完成 1K 分辨率图像的端到端编辑仅需 1.57 秒,且无需任何逐图预处理准备。 批判点评:「建模编辑量而不是重建整张图」这个转向非常对症:编辑任务本来就只有小部分内容需要变,让模型从零重新生成整图,既浪费算力又让未编辑区域无谓漂移。用源条件与目标条件预测之差作为逐尺度编辑方向,思路上和 classifier-free guidance 的差分同源,但落在 VAR 的多尺度 token 上更自然,也顺带解释了为什么能免反演、免掩码。1.57 秒完成 1K 编辑的数字对交互式应用相当有吸引力。局限在于:残差更新施加在「选定尺度」上,哪些尺度该动、动多少,摘要没交代选择准则,很可能是需要调的超参数,直接影响可用性;差分方向对提示词写法的敏感度未讨论——目标提示与源提示措辞差异过大时,差分可能失控;此外 VAR 生态目前的基座模型数量与质量都远不如扩散系,方法再好也受限于骨干天花板。 8. BAG:缓存复用改由门控网络决策 BAG: Budget-Aware Gating for Diffusion Caching | 浙江大学·西湖大学 AGI Lab | arXiv:2608.09231 关键词:扩散缓存,预算感知,门控网络,调度蒸馏,DiT加速 前序问题:扩散缓存是加速 DiT 的轻量手段——在去噪步之间复用中间特征,但现有范式面临一个根本权衡:在线启发式规则缺乏全局预算意识,不知道整体算力还剩多少;静态调度表则缺乏实例自适应能力,也无法灵活适配运行时变化的预算约束。 本文贡献:提出 BAG(Budget-Aware Gating),一种把全局预算节奏控制与动态、实例自适应的特征复用统一起来的缓存策略。它不再依赖手工规则,而是用一个轻量门控网络,在每一步同时以预算状态和局部轨迹反馈为条件,动态决定「执行完整计算」还是「复用缓存特征」。该策略通过离线到在线的调度蒸馏训练得到——把离线搜索出的调度表所包含的决策能力,迁移进一个紧凑的在线门控。 实验效果:在 FLUX.1-dev 与 Wan2.1 上的大量实验表明,BAG 在各个加速档位上一致优于当前最好的缓存方法,并且在不同分辨率、随机种子和引导强度下都保持稳健。代码将开源。 批判点评:把「算还是复用」这个决策交给一个同时看全局预算和局部轨迹的小门控,方向是对的:静态表不知道当前这张图难不难,在线启发式不知道预算还剩多少,两者的盲区正好互补。离线搜索调度表再蒸馏成在线门控,也是一种务实的工程折中——离线搜索能看到全局最优,在线门控只需继承其决策模式。可疑之处在于泛化边界:门控网络是学出来的,训练时的预算区间、分辨率和模型骨干一旦超出,决策是否还成立没有交代;论文强调在不同分辨率、种子、引导强度下稳健,但这些都属于同骨干内的扰动,换到未见过的 DiT 上是否需要重新蒸馏是关键问题。另外门控本身的推理开销虽称轻量,但在高加速档位下相对总算力的占比会被放大,摘要未给出具体数字。 9. CuteTTS:首音延迟直降23.3% CuteTTS: Efficient and High-Quality Speech Synthesis via Autoregressive Modeling of Continuous Latents | 复旦大学·上海创智学院 | arXiv:2608.08638 关键词:零样本TTS,连续自回归,流匹配,引导步蒸馏,低延迟 前序问题:零样本文本转语音已经在支撑交互式助手、个性化媒体和无障碍工具,所有 TTS 系统都要同时满足三件事:忠实的语言渲染、一致的说话人身份、以及低延迟响应。但紧凑的流式系统必须在一个可预测的低码率隐序列里保住足够的声学细节,而迭代式扩散采样与 classifier-free guidance 又会在每个自回归步上把推理成本乘上一遍。 本文贡献:提出 CuteTTS,一个紧凑的连续自回归 TTS 系统:把语义对齐的因果 VAE 隐变量、patch 级自回归、显式说话人条件化与双向流匹配头结合起来。进一步提出 guidance-step distillation,把 classifier-free guidance 与多步求解器一起吸收进单个区间条件化的学生模型,从而在推理时不必再为引导和多步求解重复付费。 实验效果:在 LibriSpeech 与 Seed-TTS-Eval 上,零样本音色克隆的可懂度与说话人相似度具备竞争力;蒸馏使首音延迟相对基础模型降低 23.3%、实时率降低 40.8%,而客观与主观质量保持相当。 批判点评:把 CFG 和多步求解一起蒸进「区间条件化」的单个学生,这一手比单纯做步数蒸馏更实用:交互式 TTS 的痛点是首音延迟,而 CFG 意味着每步都要跑两遍前向,属于纯粹的常数倍开销,能一并吸收掉收益很直接。走连续隐变量而非离散 token,也规避了码本容量对声学细节的硬约束。不足在于对比强度不够:「competitive」这种措辞通常意味着没有在可懂度或相似度上取得优势,仅是持平,而真正的卖点全在效率数字上;23.3% 和 40.8% 都是相对自身基础模型的相对提升,没有给出与主流流式 TTS 的绝对延迟对照,工业选型时价值有限;双向流匹配头与因果 VAE 的组合在流式场景下的前瞻依赖长度也没交代,这直接决定能否真正做到低延迟流式。 10. GameAlpha:透明区域跳算省35%token Alpha as an Efficiency Signal: Visibility-Routed RGBA Image-to-Video Generation | 北京大学·字节跳动·清华大学 | arXiv:2608.09355 关键词:RGBA视频生成,游戏素材,可见性路由,流匹配,DiT加速 前序问题:RGBA 视频把 RGB 外观与 alpha 通道结合,让动画素材能贴到任意背景上,游戏行业用量极大。但高质量游戏 RGBA 动画生成有两个卡点:一是现有 RGBA 视频数据集以写实内容为主,游戏素材覆盖很少;二是传统的先生成再抠像流水线在 RGB 合成之后才估计 alpha,半透明区域常被背景糊掉,导致抠像输出不稳定。近期开始有工作联合建模 RGB 与 alpha,但大多是文本条件的,效率与质量上仍有未解问题。 本文贡献:构建 GameAlpha-2.4K,一个 2.4K 片段的游戏风格 RGBA 视频数据集,用抠像友好的合成、多假设 alpha 恢复和基于合成的质量门筛选制成。在此之上训练一个参考图条件的 RGBA 视频生成器,单次前向同时产出 RGB 帧与 alpha 遮罩。为提升效率,提出 visibility router:在早期阶段就识别出透明 token,跳过它们后续的 DiT 更新;同时用 x_0-lock 让这些 token 沿原始流匹配调度朝自预测终点前进,避免被跳过后偏离轨迹。 实验效果:模型的 FVD 低于传统两阶段流水线;visibility router 在最后两个 DiT 去噪步中跳过 35% 的 token 评估,带来 1.2 倍骨干加速,质量退化可忽略。 批判点评:「把 alpha 当效率信号」这个提法很巧:alpha 通道本身就明确标出了哪些区域是透明的、几乎不含内容,这等于免费拿到一张算力分配图,不需要额外训预测器去猜哪里重要——这是本文最讨巧也最合理的一点。x_0-lock 的补充也必要,否则被跳过的 token 会脱离流匹配轨迹造成边缘伪影。但工业价值需要打折看:1.2 倍加速且仅作用于最后两个去噪步,这个收益相当有限,与今天另外两篇(BAG、DUET)动辄数倍的加速不在一个量级;GameAlpha-2.4K 只有 2.4K 片段,对视频生成而言规模偏小,是否足以支撑通用游戏素材生成存疑;FVD 低于两阶段流水线是个较弱的基线选择,未与近期联合建模 RGBA 的方法正面比较;此外游戏风格数据训出的模型跨美术风格泛化能力完全未讨论。 趋势观察 少步蒸馏从「二选一」走向「按噪声分工」 — 阿里与北大的 DUET 把长期困扰少步蒸馏的质量-多样性权衡拆成了一个分工问题:轨迹级蒸馏(sCM)保多样性、分布级蒸馏(DMD)保质量,此前所有工作都在试图用一个 loss 把两者调和,结果总是牺牲一方。DUET 干脆让 sCM 专家接管高噪声那一步负责铺开结构,DMD 专家接管低噪声那一步负责精修细节,两个专家各按自己的原生目标独立训练,绕开了 loss 组合的优化困难。两步视频生成上质量逼近 DMD、结构多样性保住 sCM 水平(约为 DMD 的两倍)。这是今天最干净的一个「把权衡改造成分工」的范式样本。 推理加速的重心从「压缩步数」转向「花掉的算力值不值」 — 今天有三篇从不同角度攻同一件事。上交与淘天的 REST 指出 RL 对齐与少步蒸馏被串行执行是纯粹的浪费——扩散 RL 本身就在生成带奖励分数的有限步轨迹,那些中间状态是天然的蒸馏监督,不该当采样副产品扔掉;单阶段协同训练后,无 CFG 的少步推理能追平甚至超过 40 步的 RL 教师,额外训练成本不到纯 RL 的 25%。浙大与西湖的 BAG 则戳破缓存策略的两难:在线启发式没有全局预算意识、静态调度又缺乏实例自适应,改用一个轻量门控网络同时看预算状态和局部轨迹反馈来决定「这一步算还是复用」。字节与北大的 GameAlpha 走的是第三条路——不去改调度,而是让 alpha 通道直接充当算力分配图,透明 token 早早识别出来后跳过后续 DiT 更新。三条路线的共同指向是:加速的下一程不在「少走几步」,而在算力分配的精细化——按训练流程、按实例难度、按空间区域,各有各的省法。 统一模型开始拆掉 VAE 这根拐杖 — 美团的 UniSpace 提出一个反直觉的观察:语义 ViT 的冻结 Transformer 块并非天生保不住视觉细节,真正把表征推向语义抽象的是原始的 patch 参数化方式。于是它做 Patch Reparameterization——保留原语义通路,另加一条重建感知的 patch embedding,把细粒度信息喂给同一批冻结 ViT 块,最终把理解、生成、编辑装进同一个视觉空间,8B 的 Mixture-of-Transformer-Experts 全程不需要独立的 VAE 通路。这条路子如果站得住,意味着统一多模态模型的架构可以显著简化:一个预训练 ViT 即可充当通用视觉接口。 音频生成开始追求「一套权重装下所有声音」 — 快手可灵团队与港中文的 SonicWeave 把语音、音乐、音效、歌声以及它们的细粒度混合塞进单个流匹配模型。它的技术判断很具体:现有音频 MoE 大多在领域级别路由,粒度太粗;而 token 级路由又忽略了声学信号固有的局部连续性。SonicWeave 改按连续声学 chunk 路由,并用一个冲突门在局部状态不可靠时倾向全局先验、在区域偏离全局场景时才让局部证据说话。复旦与阿里 Token Foundry 的 FullDiT 则捅破混合式音乐生成的一个部署真相:渲染器用干净的目标 codec token 训练,上线却要吃语言模型的不完美预测,这是典型的暴露偏差;把渲染重新定义为「从不完美离散计划出发的全上下文生成」,并按教师强制下的 top-1 错误率匹配干扰替换率,最终在 18 个自动指标中的 15 项上超过五家商业系统。 扩散架构的「知其所以然」终于开始补课 — 北大与百度的 adaLN-Zero 研究(TPAMI 2026)值得单独一提:DiT 已被用了几年,但 adaLN-Zero 为什么比 adaLN 好,社区一直只有直觉。这篇把候选解释拆成三条——SE 式结构、零初始化、渐进式更新顺序,逐一做消融,最终证明零初始化才是主导因素,并顺势给出 adaLN-Gaussian 初始化与 SE-adaLN-Zero 改进结构。在基座模型迭代如飞的当下,这类回头做机理归因的工作反而更稀缺:它给出的是可迁移的设计原则,而不是又一个刷分技巧。 人工智能炼丹君 整理 | 2026-08-12 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
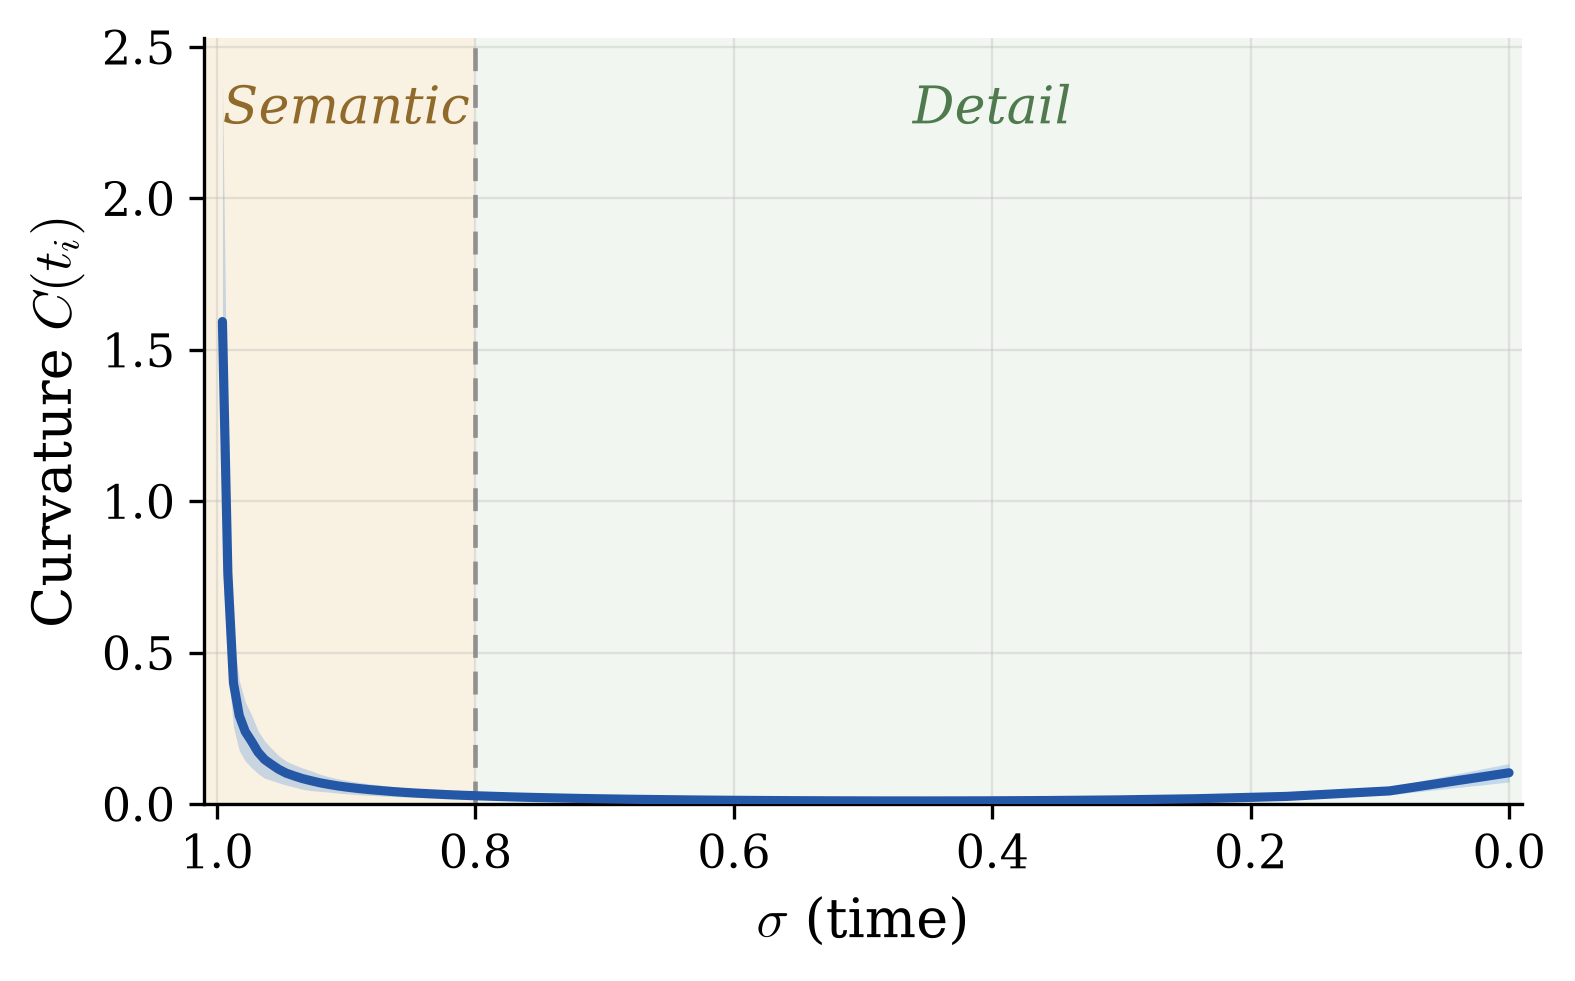
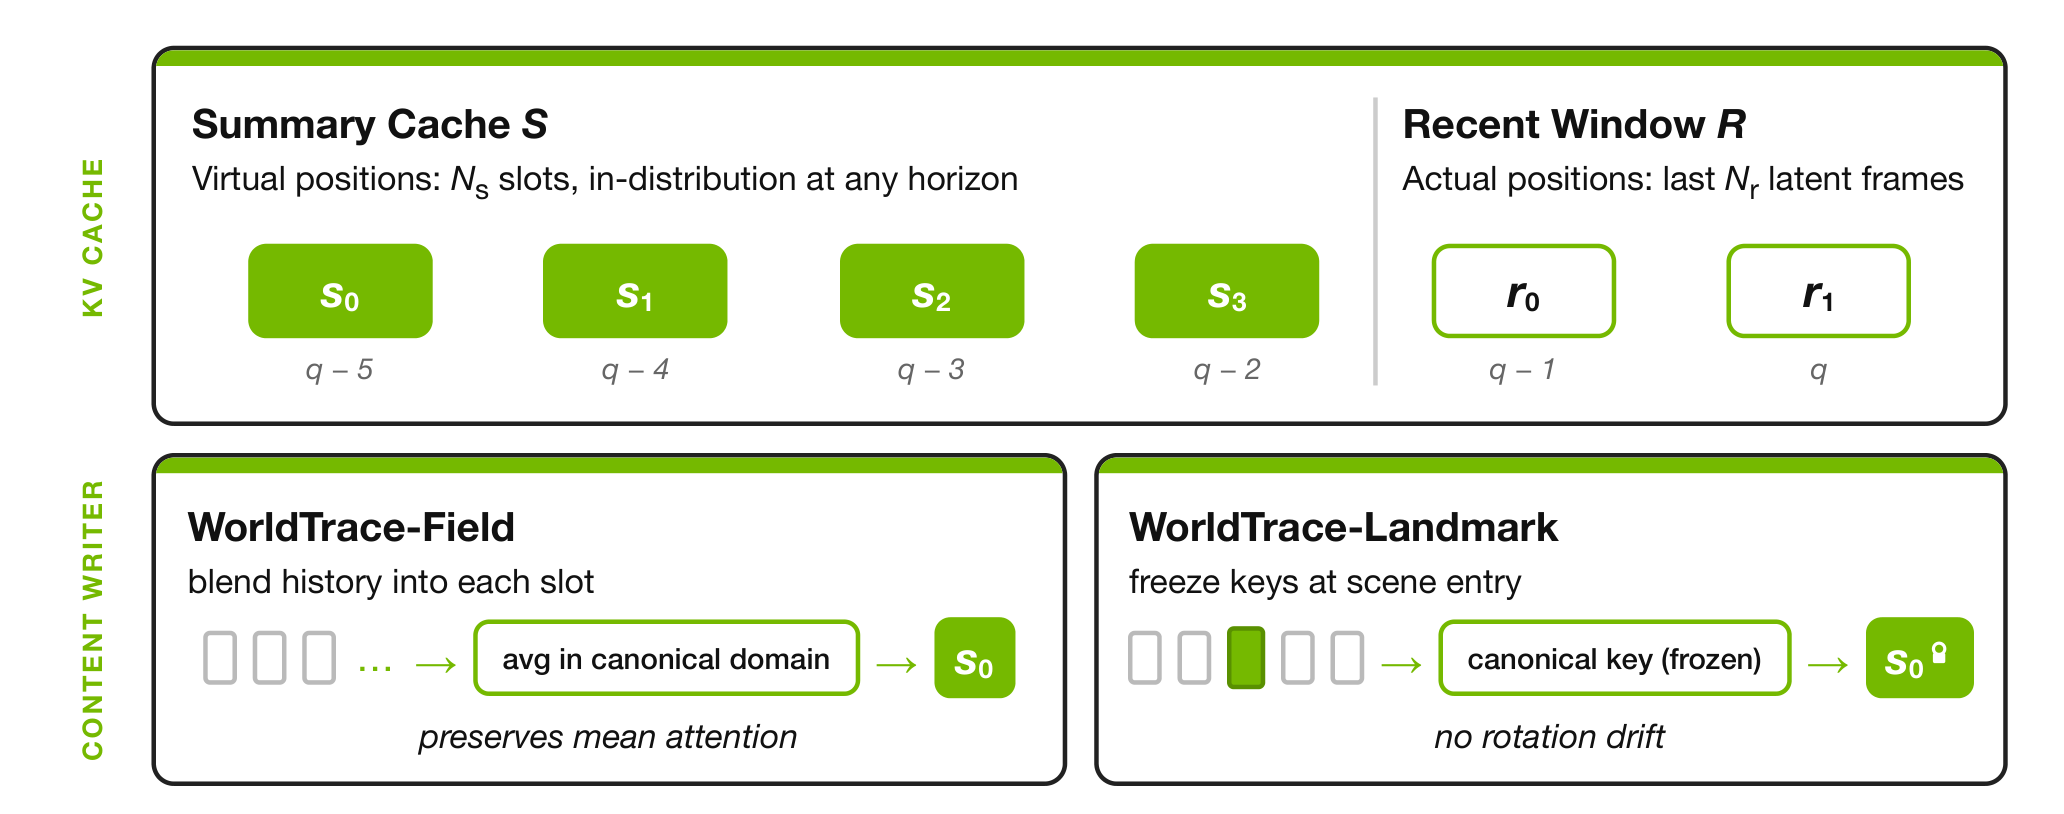
AIGC 每日速读|2026-08-11|NVIDIA免训练治好世界模型失忆WorldTrace 今日 AIGC 论文速览 今日共 10 篇 · 世界模型长时一致性与物理保真 2 篇 · 可控图像生成与区域编辑 4 篇 · 生成效率与免训练适配 2 篇 · 语音与数字人生成 2 篇 重点论文标题列表 WorldTrace(NVIDIA·普林斯顿大学·多伦多大学):免训练治好世界模型失忆 InsertFuse(上海交通大学·上海创智学院·西安交通大学·武汉大学):先训专家再蒸馏成一个 MOSAIK(华为加拿大):砍70%算力质量不掉 ControlRef(中山大学·清华大学·北京理工大学):稀疏布局延迟砍掉八成 HRDiT(兰卡斯特大学·华南理工·NVIDIA AI Tech Centre):现成DiT免训练出高清 今日论文速览 1. WorldTrace:免训练治好世界模型失忆 Addressable Memory for Video World Models | NVIDIA·普林斯顿大学·多伦多大学 | arXiv:2608.07408 关键词:视频世界模型,长时记忆,RoPE外推,KV cache压缩,免训练 前序问题:交互式视频世界模型依赖不断增长的 KV cache 当视觉记忆,来承接已生成的帧。但作者发现,一旦 rollout 超出训练时长,模型就无法可靠地寻址已存内容——因为时间维度的 RoPE 偏移跑到了训练时从未见过的范围之外,注意力检索不到相关视觉信息。更麻烦的是,天真地在 RoPE 旋转后的空间里压缩 cache 会直接破坏记忆,相当于把互不兼容的位置相位平均在一起。 本文贡献:提出免训练的记忆框架 WorldTrace:给每个摘要槽位分配一个互不相同、且落在训练分布内的虚拟位置,让压缩后的记忆保持「可寻址」。在这个可寻址 cache 之上研究两条压缩路线——WorldTrace-Field 压缩历史以维持时序连贯,WorldTrace-Landmark 在检测到的场景转换处保存原样场景轨迹以支持情节式回忆。同时提出 LoopBench,专门评测「绕一大圈之后能否重建先前访问过的场景」。 实验效果:WorldTrace-Field 把时序一致性提升 15.5%;WorldTrace-Landmark 在 LoopBench 上把情节式回忆提升 19.5%。全程无需重新训练,即扩展了视觉持久生成的长度。 批判点评:这篇的价值主要在诊断而非方法:把「世界模型跑长了会失忆」从模糊的「容量不够」精确归因到 RoPE 外推越界加旋转空间压缩相位冲突,并指出必须让虚拟位置落回训练分布内,这个洞察干净且可迁移——长上下文语言模型里的同类问题同样适用。免训练、可直接挂到现成模型上,落地成本几乎为零。局限是它本质在给外推能力打补丁而非根治:虚拟位置复用意味着不同时刻的记忆共享位置编码,冲突在更长 rollout 上迟早重现;Field 与 Landmark 两条路线各优化一个指标(时序连贯 vs 情节回忆),说明还没找到统一解;LoopBench 是作者自建的,绝对难度和外部可比性有待其他团队验证。 2. InsertFuse:先训专家再蒸馏成一个 InsertFuse: A Unified Framework for Multi-Category Reference-Guided Image Insertion | 上海交通大学·上海创智学院·西安交通大学·武汉大学 | arXiv:2608.06490 关键词:图像插入,On-Policy蒸馏,流匹配,区域平衡,参考引导 前序问题:参考引导的图像插入(把一个参考物体自然地放进目标场景)要同时处理人物、服饰、家具、logo 等多种类别,而不同类别的插入行为差异很大。直接联合训练一个通用模型会产生跨类别干扰——学插家具的能力会把插人物的能力带偏;而分别训练多个专用模型又无法统一部署。此外插入区域通常远小于背景,直接做流匹配会让监督信号被背景主导,且对物体尺度敏感。 本文贡献:提出 InsertFuse,核心思路是把「类别专属能力的学习」与「跨类别能力的整合」解耦:先为不同插入类别各训一个专家,再用 Insertion On-Policy Distillation(IOPD)把它们的能力合并进单个学生模型——在学生实际访问到的状态上去查询匹配的那个专家,从而保住类别专属的插入行为,又避免了直接联合训练的跨类别干扰。为改善空间控制,提出 Token 对齐的几何条件(TAGC),把掩码导出的几何线索映射到视觉 token 网格;以及区域平衡流匹配,对插入区域内外的预测误差分别归一化,防止背景主导和尺度依赖的监督失衡。另引入 Reference CFG,在固定场景与几何条件下隔离并强化视觉参考带来的引导,再由 IOPD 把这份增强监督迁移进统一学生。 实验效果:在公开的 AnyInsertion benchmark 和作者自建的多类别测试集上,多数指标达到最优,在多样插入类别上都表现出很强的参考保真度与生成质量。 批判点评:「先训专家、再 on-policy 蒸馏成一个」这条路子在大语言模型里已被验证,搬到图像插入上很对症——插入任务的类别差异确实大到会互相拖累,而 IOPD 在学生自己走到的状态上查专家(而非离线蒸馏固定数据),能避免分布错位,这是关键细节。区域平衡流匹配也点出一个容易被忽视的工程真相:插入区域只占画面一小块,不做归一化,损失基本被背景吃掉。不足在于成本:要先训 N 个专家再蒸馏,整体训练开销远高于单模型方案,论文没交代专家数量和总算力,实用性判断打折;「多数指标最优」的措辞意味着有指标不占优,具体哪些没说;此外自建测试集与公开 benchmark 混合汇报,容易掩盖在标准集上的真实位次。 3. MOSAIK:砍70%算力质量不掉 MOSAIK: Multi-Patch Content-Aware Spatial Allocation of Image Tokens for Efficient Generation | 华为加拿大 | arXiv:2608.05450 关键词:像素空间扩散,异构patch,推理加速,token预算,华为 前序问题:像素空间扩散模型避开了潜空间扩散的重建天花板,但 token 数量高得多,在自注意力的二次复杂度下生成成本高昂。已有的效率方法通过在选定的去噪步使用更大 patch 来减少 token,但每一步都在整张图上用同一个 patch 尺寸,忽略了不同区域被粗化时的保真损失其实差别很大。 本文贡献:提出 MOSAIK,一个「损伤引导」的框架,让 patch 尺寸同时随区域和去噪步变化。改造 PixelDiT 骨干使其能生成任意异构的 patch 布局,并用一个轻量预测器基于中间去噪特征估计每个区域被粗化会造成多大保真损失。在给定 token 预算下,损伤引导的布局预测器把细 patch 分给敏感区域、粗 patch 分给其余区域。 实验效果:在 FLOPs 减少 70%、token 数减少 83% 的同时,GenEval 与全算力 PixelDiT 持平,DPG-Bench 仅下降 1.0 分。与包括时序 patch 调度、特征缓存在内的多种效率范式相比,在中等预算下极具竞争力,在算力极度受限的场景下持续超越这些基线。 批判点评:「不同区域被粗化的代价不一样」这个观察太朴素了,以至于之前的 patch 调度工作集体忽略——把逐步的时间维调度扩展到空间维,并且用一个学出来的损伤预测器而非手工启发式来分配预算,思路正确且数字漂亮:砍 70% FLOPs 而 GenEval 持平,这个性价比在效率方向里属于第一梯队,尤其在算力受限区间超越特征缓存类方法,说明它不是靠预算宽松堆出来的。风险在于:异构 patch 布局需要改造骨干(PixelDiT),无法像特征缓存那样零成本挂到现成模型;损伤预测器本身要跑,在极小预算下它的开销占比会上升;此外评测集中在 GenEval/DPG 这类文图对齐指标,异构 patch 边界在高频纹理和小字上是否留下可见接缝,摘要没有交代。 4. ControlRef:稀疏布局延迟砍掉八成 ControlRef: Efficient Layout-Guided Multi-Instance Generation via Anchored 4D-RoPE | 中山大学·清华大学·北京理工大学 | arXiv:2608.06878 关键词:布局引导生成,多实例合成,4D-RoPE,MM-DiT,推理加速 前序问题:布局引导的多实例生成对多模态扩散 Transformer(MM-DiT)的可控合成很关键,但要把这个能力整合进统一架构一直很难。此前框架依赖冗余的全分辨率画布填充加 Shifted-RoPE 来管理多张参考图:这套机制在稀疏布局下把计算开销急剧放大,又破坏了关键的低频 RoPE 特征,形成严重的空间-频率折损,把绝对空间对应关系搞模糊。 本文贡献:提出 ControlRef。用统一实例-布局控制(UILC)注意力掩码严格解耦实例间的语义交互,强制精确的区域绑定。为进一步促进区域级空间对齐,提出 Anchored 4D-RoPE:把 token 直接锚定到它们的绝对几何中心——先把参考图预对齐到对应边界框的分辨率,再把布局 token 和参考 token 都物理锚定到绝对几何中心,并让参考沿 z 轴堆叠,从而原生保留空间先验,无需有损位移就缓解了空间-频率折损。 实验效果:在视觉保真度和定位准确率上达到最优,同时把稀疏布局下的推理延迟削减 80% 以上,稠密场景下的显存开销降低 50%。 批判点评:这篇把「Shifted-RoPE 用位移换对齐」这个隐性代价揭示得很清楚——位移破坏低频分量,而低频恰恰承载绝对空间信息,于是控制精度和算力两头同时受损。改成把 token 物理锚定到绝对几何中心、参考沿 z 轴堆叠(这也是 4D 的来源),是从坐标系层面而非加约束层面解决问题,延迟降 80%、显存降 50% 属于工程上很实在的收益。需要留意的是:稀疏布局的 80% 提速本质来自不再做全分辨率填充,收益高度依赖布局稀疏程度,稠密场景下只剩 50% 显存收益,宣传口径要打折;把参考预对齐到边界框分辨率意味着参考图会被重采样,小物体的细节保真如何没有交代;此外方法与 MM-DiT 的位置编码强耦合,迁移到其他架构的成本未知。 5. HRDiT:现成DiT免训练出高清 HRDiT: Training-Free High-Resolution Image Generation with Off-the-Shelf Diffusion Transformer Models (ECCV 2026) | 兰卡斯特大学·华南理工·NVIDIA AI Tech Centre | arXiv:2608.07003 关键词:免训练,高分辨率生成,Diffusion Transformer,空间错乱,ECCV2026 前序问题:免训练的文本到高分辨率图像生成正获得越来越多关注,但已有研究主要集中在把现成的 U-Net 扩散模型适配到高分辨率;对现成 Diffusion Transformer(DiT)的适配进展有限——尽管 DiT 在有限分辨率下的文生图能力本来更强。 本文贡献:指出两个特别阻碍现成 DiT 免训练做高分辨率合成的关键挑战——空间错乱(spatial disorder)与生成时间过长,并针对性提出一套专门适配现成 DiT 的方法。代码已公开。 实验效果:大量实验验证了方法的有效性。论文已被 ECCV 2026 接收。 批判点评:问题定位很到位:社区做免训练超高分辨率的技巧大多是 U-Net 时代的遗产,而主力基座早已换成 DiT,这个空档确实值得补;免训练、直接用现成权重、代码开源,落地门槛几乎为零,ECCV 2026 接收也算一层同行背书。但这条摘要是今天十篇里写得最含糊的:只说「有两个挑战」和「提出一种新方法」,具体机制、能撑到多高分辨率、加速比多少、与 ScaleCrafter/DemoFusion 这类前作差多少,一个数字都没给。即使实验部分扎实,这种写法也会让读者在信息筛选阶段先流失一批——对一篇主打「免训练即插即用」的工作来说,是很可惜的自我设限。 6. MaskFlow:掩码写进流匹配目标 MaskFlow: Precise, Consistent and Seamless Regional Image Editing | 商汤研究院·北京航空航天大学·南洋理工大学 | arXiv:2608.06929 关键词:区域图像编辑,流匹配,掩码条件,边界融合,商汤 前序问题:区域图像编辑因为空间可控性受到关注。但即便基于指令和基于掩码参考的方法都能做到不错的语义对齐,可靠的区域控制仍然困难——编辑必须被准确定位,并且与被保留的上下文自然融合,而现有方法常在边界留下痕迹或污染背景。 本文贡献:提出训练框架 MaskFlow,同时追求精确定位、一致的背景保持和无缝的边界过渡。关键做法是把掩码直接纳入概率路径和流匹配目标,让可编辑区域内的生成与区域外的源保持协同优化,而不是事后拼接。另提出 Soft-Poisson 去缝合模块,在训练和采样两个阶段都对预测的向量场做精修,改善编辑前景与保留背景的平滑融合。同时设计数据合成管线构建 MEData——面向区域图像编辑训练的掩码数据集。 实验效果:在自然场景和信息图(infographic)图像上的实验显示,定量与定性评测均相对竞争方法取得一致提升。 批判点评:把掩码写进概率路径和流匹配目标、而不是当成后处理的贴回操作,这是方法论上的正解——边界不自然的根源就是训练目标里从来没有「区域内外要协同」这一条。Soft-Poisson 在训练和采样两侧都介入也考虑得比较周全;选信息图当评测场景很实用,因为文字和线条对缝合痕迹最不宽容。不足在于它是训练框架而非免训练插件,接入成本比同类高;效果描述停留在「一致提升」,缺具体数字和基线对比,而区域编辑的差异往往只体现在边界几十个像素上,这类主观性强的改进尤其需要量化和用户研究支撑;MEData 由合成管线构造,与真实用户涂抹掩码的分布是否一致也需要验证。 7. EmoWorld:情感拆成三路分别调 EmoWorld: A Decoupled Affective Field for Controllable Emotional Video Generation | 香港科技大学(广州)等 | arXiv:2608.06231 关键词:情感视频生成,可控生成,冻结DiT,残差操控,Wan2.2 前序问题:情感决定观众如何解读一个场景,但现有视频生成器把全局氛围、承载情感的语义线索、以及情绪的时间推进这三件事全都揉在同一条文本条件里,导致无法分别控制——想调暗氛围就连带改了画面内容,想加一个悲伤的道具又连带改了整体色调。 本文贡献:提出 EmoWorld,在冻结的流匹配视频扩散 Transformer(Video DiT)内部解耦这三个因素。一次性准备阶段从「几何保持的中性全景图」与「情感编辑后的全景图」中提取逐层的情感方向和一个可复用的线索库。推理时:视觉氛围操控(VAS)把氛围方向注入隐藏状态;语义情感操控(SAS)为语义线索单独隔离出一个可独立缩放的 prompt 残差;时间情感操控(TAS)在去噪时间与视频时间两个维度上插值端点残差场。全程不更新生成器参数。 实验效果:在 Wan2.2 上,VAS 把目标情绪对齐度提升 19%、同时把时序波动代理指标降低 48%;SAS 把目标情绪对齐度提升 37%、检测到的承载情感线索增加 36%;TAS 相对最强基线把过渡单调性提升 15%。覆盖 27 个情绪类别的文生视频与图生视频设定,可跨多个 Video-DiT 骨干移植,并支持相机条件下的构图。 批判点评:把「情感」这个含混的条件拆成氛围、语义线索、时间推进三路分别注入,是这篇最漂亮的地方——它把一个说不清的美学需求变成了三个可分别缩放的旋钮,而且完全不动生成器权重、能跨骨干移植,工程友好度很高;用几何保持的中性/情感全景图对来抽取情感方向,也是个巧妙的构造。要谨慎的是评测指标的自定义程度偏高:「时序波动代理」「过渡单调性」都是作者自拟的量,19%/37%/48% 这些百分比缺少公认基线的对照,跨论文可比性差;情绪这类主观维度最终仍需人类评测,摘要未提及用户研究;此外方法依赖一次性准备阶段产出的线索库,换主题域或换骨干后是否需要重建,成本没有交代。 8. GAUGE:方程对了加速度还是错 GAUGE: A Measurement-Grounded Benchmark for Physical Fidelity in Simulation Engines and Video World Models | 上海人工智能实验室·香港大学·上海交通大学·浙江大学 | arXiv:2608.05948 关键词:物理保真度,视频世界模型,物理引擎,诊断基准,上海AI Lab 前序问题:物理引擎支撑着具身智能的大规模训练与评估,而生成式视频世界模型正在成为未来状态与交互的隐式模拟器。但现有的物理保真度评估往往各自孤立进行,且严重依赖感知相似度或人工判断,几乎无法告诉你到底是哪条物理原理、哪个参数被违反了。 本文贡献:提出 GAUGE,一个以真实世界为基准的诊断性 benchmark,联合评估数值模拟器与生成式视频世界模型对真实物理的复现与偏离。包含 22 个受控任务族,覆盖刚体、柔性线缆、织物和体积可变形物体;以真实世界轨迹为基准,配套标定过的物理元数据、不确定性标注和任务专属可观测量,涵盖碰撞、摩擦、动量传递、振荡、自接触、形变等基本物理过程。 实验效果:用广义轨迹误差在 14 个任务族上评测 Isaac Sim、Genesis 与 Newton,并在 5 个刚体任务上评测 6 个图生视频模型的物理定律一致性与推断参数的时序稳定性。结果显示没有任何一个物理引擎在全部任务上保真,最大偏差出现在冲击性接触、织物快速运动和体积形变;更值得警惕的是,视频世界模型能产出「方程形式符合预期」的轨迹,但恢复出的加速度、动量传递和振荡时序全是错的。 批判点评:把物理引擎和生成式视频模型放进同一套以真实轨迹标定的尺子下衡量,这个设计本身就是贡献——此前两个社区各说各话,一边比轨迹误差一边比感知相似度,根本无法对话。最有价值的结论是「方程形式对但加速度错」:这精确刻画了视频模型的物理是表层拟合而非机制正确,对所有把视频世界模型当具身智能模拟器用的团队都是一记警钟,而这种可归因到具体物理量的诊断,是感知相似度指标永远给不出的。局限在于覆盖不平衡:物理引擎评了 14 个任务族,视频模型只评了 5 个刚体任务,柔性和形变这些最难的场景恰恰没测到生成模型;真实轨迹的标定精度与不确定性标注本身也会引入误差上限;22 个任务族的构造和评分细节能否被外部团队稳定复现,要等数据与代码放出后才能判断。 9. SemBridge:语义token只在训练时用 SemBridge: Semantic Token Anchoring for Continuous-Latent Autoregressive Speech Generation | 西北工业大学·Soul AI Lab | arXiv:2608.07462 关键词:自回归语音生成,连续潜表示,语义token监督,零样本TTS,歌声合成 前序问题:连续潜表示的自回归语音生成通过避免量化损失、保留更丰富的声学信息,成为离散 token 建模之外一条有前景的路线。但连续声学目标并不把语言结构暴露成显式的 token 级预测目标,结果自回归语言模型只能通过预测声学来间接获得语言结构,这会损害生成语音的内容保真度——说白了就是音色和韵律很好,但字容易念错。 本文贡献:提出 SemBridge,一个仅在训练阶段生效的语义 token 锚定框架。用离散语义 token 直接监督自回归 LM 的状态,并采用语义对齐的声学 VAE,把连续目标空间组织在同一个语义参照系之下。语义监督只在训练时使用,推理阶段完全保持连续,因此不引入量化损失。在零样本文本转语音(TTS)和乐谱条件的歌声合成(SVS)两个任务上评估。 实验效果:在多个基准上,SemBridge 改善了以词错误率和字错误率(WER/CER)衡量的内容准确率,同时保持有竞争力的说话人相似度和感知质量。结果表明,对自回归状态施加显式语义 token 监督,是连续语音生成的一个有效且通用的方向。模型代码与 checkpoint 将开源。 批判点评:「训练时用离散语义 token 当拐杖、推理时完全撤掉」这个设计非常讨巧——它精准命中连续潜表示路线的软肋(音质好但内容易错),又不把量化损失带回推理阶段,属于两头好处都要的正确姿势,而且同时在 TTS 和歌声合成上验证,说明不是针对单一任务的技巧。不足是收益描述偏保守:内容准确率提升、说话人相似度和感知质量「保持有竞争力」,这个措辞通常意味着后两项略有折损,具体折多少要看正文;语义 token 的质量高度依赖所用的语义编码器,换一个编码器结论是否稳定没有交代;此外 16 位作者的大团队工作却只给出相对提升而无绝对 WER 数字,可比性打了折扣。 10. SubtleTalk:眉毛眨眼终于不再呆滞 SubtleTalk: Generating Controllable Weakly-correlated Facial Dynamics for 3D Talking Heads via Residual Flow Matching | 上海交通大学·腾讯 | arXiv:2608.06408 关键词:3D说话人,弱相关动态,残差流匹配,Valence-Arousal,腾讯 前序问题:音频驱动的 3D 面部动画要从语音合成真实且时序连贯的运动。尽管唇形同步已有显著进展,但眉毛运动、眨眼、头部动作这些「弱相关动态」——对照片级真实感恰恰至关重要——仍然难以忠实建模,常常表现得僵死或不自然地重复。作者归因于三点:一是弱相关动态的条件信息不足;二是确定性回归难以捕捉多样的运动模式;三是上半脸伪标签不可靠、数据集多样性有限造成的数据瓶颈。 本文贡献:提出 SubtleTalk,通过多条件建模与残差流匹配生成自然可控的弱相关面部动态。第一,针对单靠语音引导不足,引入可解释的控制信号——韵律、区域强度、Valence-Arousal(效价-唤醒度),显式刻画弱相关动态的时机、幅度和情感变化。第二,针对确定性回归表达力有限,在稳定的语音驱动运动先验之上构建残差流匹配,让模型捕捉超出确定性预测的随机偏差。第三,为缓解数据瓶颈,构建 SubtleTalk-Face 数据集,约 3900 个身份、74 小时数据,通过简单可扩展的伪标注管线构建,改进了上半脸追踪并带有帧级 VA 标注。 实验效果:大量实验表明,该方法在显著提升弱相关面部动态的真实感和多样性的同时,保持了准确的唇形同步。 批判点评:问题诊断分层很清楚:条件不足、回归表达力不足、数据不足,三条各配一个对策,而不是笼统地上一个更大的模型。「弱相关动态」这个提法本身就抓住了数字人恐怖谷的真正来源——唇形对了但眉眼呆滞,观众立刻觉得假;用残差流匹配在确定性先验之上叠随机偏差,是承认这类动作本质多模态、不该被回归到均值,方向正确;3900 身份、74 小时并带帧级 VA 标注的数据集也是实打实的贡献。局限是上半脸标注仍来自伪标注管线,而上半脸恰恰是原问题里「伪标签不可靠」的部分,这在方法论上有一点自我循环的味道;效果只给了「显著提升真实感和多样性」的定性说法,而多样性和真实感之间通常是权衡(动得多容易动得怪),缺少量化取舍曲线;此外三路控制信号的调参空间不小,实际使用的易用性有待验证。 趋势观察 长时一致性的病根被重新定位到「位置编码的可寻址性」 — NVIDIA 与普林斯顿的 WorldTrace 指出,视频世界模型跑超训练时长后失忆,真正原因不是 KV cache 装不下,而是 RoPE 的时间偏移跑出了训练分布,模型根本「找不到」存进去的内容;更糟的是在 RoPE 旋转后的空间里直接压缩,等于把相位不兼容的记忆平均成糊状。给每个摘要槽位分配一个落在分布内的虚拟位置,免训练就把时序一致性提了 15.5%、情节回忆提了 19.5%。这是今天最典型的「诊断比方法更值钱」。 生成效率的战场从「少走几步」转到「每一块像素值不值得花算力」 — 华为加拿大的 MOSAIK 指出,此前的 patch 调度都是在时间维上做手脚——某几个去噪步换大 patch,但整张图仍用同一个尺寸,完全忽略了不同区域被粗化时保真损失差别巨大。它训了一个轻量预测器估计每个区域的「损伤程度」,把细 patch 分给敏感区、粗 patch 分给其余,FLOPs 砍 70%、token 砍 83% 而 GenEval 与全算力持平、DPG 只掉 1.0 分,并且在算力极度受限时持续超越特征缓存类方法。空间维的自适应预算分配,是这条路上被漏掉的一整个维度。 免训练与训练后处理,仍然是投入产出比最高的一档工作 — HRDiT(ECCV 2026)把免训练高分辨率生成从 U-Net 时代搬到现成 DiT 上,只需解决空间错乱和生成耗时两个卡点;WorldTrace 完全不动权重就修好长时记忆;EmoWorld 在冻结的 Video DiT 上做三路情感操控,27 类情绪、跨多个骨干可移植,全程不更新生成器参数。当基座模型迭代速度远快于论文周期时,「不碰权重」正在成为一种务实的方法论选择。 可控生成的瓶颈从「像不像」转向「位置对不对、别处别动」 — 中山大学与清华的 ControlRef 发现前作用全分辨率画布填充加 Shifted-RoPE 管多张参考图,既在稀疏布局下浪费大量算力,又破坏低频 RoPE 特征、模糊了绝对空间对应;改成把 token 锚定到绝对几何中心的 Anchored 4D-RoPE,稀疏布局延迟砍掉 80% 以上、稠密场景显存省一半。商汤的 MaskFlow 把掩码直接写进概率路径和流匹配目标,从训练目标层面保证「区域内生成、区域外保源」;上交的 InsertFuse 则用区域平衡流匹配,对插入区域内外分别归一化误差,防止小目标的监督被背景吃掉。三篇都在说同一件事:控制不是往外加约束,而是改坐标系和目标函数。 评测正在从「打分」走向「诊断违反了哪条物理定律」 — 上海 AI Lab 联合港大、上交、浙大的 GAUGE 用真实世界轨迹做基准,22 个受控任务族覆盖刚体、柔性线缆、织物和体积可变形物,同时评物理引擎(Isaac Sim、Genesis、Newton)和 6 个图生视频模型,结论相当刺眼:没有一个引擎在全部任务上物理保真;而视频世界模型能生成「方程形式看起来对」的轨迹,但加速度、动量传递和振荡时序全是错的。这种可归因到具体物理量的评测,比再多一个感知相似度分数有用得多。 人工智能炼丹君 整理 | 2026-08-11 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-07|Meta实测视觉懒惰生成数据只留5%反而更强 今日 AIGC 论文速览 今日共 10 篇 · 统一多模态预训练与Tokenizer 2 篇 · 统一音视频生成 3 篇 · 生成后训练与奖励对齐 3 篇 · 自回归与长视频生成 2 篇 重点论文标题列表 MM-Pretraining Physics(Meta FAIR·Reality Labs·牛津大学):生成数据只留5%反而更强 Vorch-Omni(Vorch Team):一个模型吃下30种音视频配置 Vorch-Streamer(Vorch Team·同济大学·哈工大深圳·上海交大):27.12FPS边说边生成数字人 Vorch-Director(Vorch Team·浙江大学):22个镜头分钟级不掉线 KVAE(Kandinsky Lab):音图视三件套PSNR多涨1dB 今日论文速览 1. MM-Pretraining Physics:生成数据只留5%反而更强 Towards Physics of Multimodal Pretraining: Knowledge Flow, Modality Synergy, Early Unification, and Recipes | Meta FAIR·Reality Labs·牛津大学 | arXiv:2608.05000 关键词:统一多模态预训练,视觉懒惰,MoE,数据配方,Meta FAIR 前序问题:统一多模态预训练已经成为共识路线,但语言、视觉理解、视觉生成三种能力在联合训练时到底怎么互相传递知识、什么时候协同什么时候打架、视觉数据该在训练的哪一刻加入,业界基本靠经验和直觉,公开的对照实验很少。 本文贡献:用严格的单变量控制实验系统拆解统一预训练,给出四条结论:一是知识流动高度不对称,语言是万能助推器、视觉理解是生成的强先验,而生成几乎不反哺前两者;二是数据复杂度决定模态是协同还是竞争,共享注意力与归一化、拆开前馈层的架构最有利于协同,且换视觉 tokenizer 结论不变;三是必须早期统一、同步联训,晚接视觉会触发作者命名的「视觉懒惰」;四是把这些结论合成非对称数据配方 L70/U25/G5(语言 70%、理解 25%、生成 5%)。 实验效果:在 13.5B MoE(256 专家、每 token 激活 16 个、其中 2 个模态专属,激活参数 1.5B)上用 2T token 做单变量对照:非对称配方相比均衡配方 L50/U25/G25,语言准确率 54.31% 对 52.86%,视觉理解均值 43.08 对 41.42,GenEval 从 0.467 升到 0.482、DPG 从 0.676 升到 0.689——生成 token 少了五倍,文图对齐反而更好,5 万张图的 FID 5.234 与均衡配方的 5.131 基本持平。视觉懒惰有四路机械证据:语言预热从 0B 拉到 800B token 后,视觉 FFN 的训练态与推理态激活幅度、图像包裹 token 的嵌入范数、推理时落在图像 token 上的注意力占比全线下滑。 批判点评:这类「控制变量做到底」的实证研究比又一个新架构更稀缺,尤其「生成数据只给 5%、生成指标反而更好」直接冲击了「想让模型会画就多喂图」的直觉,而视觉懒惰给「强 LLM 接视觉后仍然看图犯低级错误」提供了可测量的解释。局限也明显:结论建立在 Meta 自有数据与 RAE 编码器体系上,2T token 的对照跑一次成本极高,外部团队几乎无法复现;L70/U25/G5 是在这套设定下搜出来的,换数据分布未必照搬;GenEval 0.482 本身离商用文生图还有距离,说明配方优化的是预训练起点而非最终生成力。 2. Vorch-Omni:一个模型吃下30种音视频配置 Vorch-Omni: Multi-Task Orchestration of Sight and Sound | Vorch Team | arXiv:2608.05803 关键词:统一音视频生成,任意条件到任意输出,LTX-2.3,流匹配DiT,多任务 前序问题:文生视频、参考图生成、视频续写、指令编辑、视频配音这些能力今天大多各自训一个模型。一旦把目标视频、源视频、参考图、参考音频塞进同一条序列,模型就分不清哪段该生成、哪段要原样保留、哪段只提供身份或风格;加上音频既可能是条件又可能是输出,任务空间会成倍膨胀。 本文贡献:把所有任务统一成「任意条件到任意输出」的一次条件去噪:每个任务由视频目标、视频条件、音频目标、音频条件四个集合描述,token 级条件掩码决定谁保持干净、谁被去噪,任务标识区分目标/源/主体参考/音频参考/编辑条件,位置类型再区分「与目标共享连续时间轴」(如续写)和「独立参考网格」。视觉条件走两条互补通路——视觉语言模型读采样帧加文本指令给语义,视频 VAE 把完整条件编码成干净 latent 保结构。底座是单个 LTX-2.3 音视频流匹配 DiT(48 层,视频流 32 头×128 维、音频流 32 头×64 维),新任务只改配置不改结构。 实验效果:同一套权重覆盖 10 类以上任务、30 多种条件—输出组合,包括文生视频、文生音视频、图像与参考驱动生成、时间续写、音频驱动生成、视频转换以及单模态和跨模态编辑。人评部分组织 527 组样本、11361 条维度级判断与 Wan 2.7 盲测:81.4% 的判断认为两者相当,Good 与 Bad 各占 7.7% 和 8.0%,总体净胜率 -1.9%;但在最考验统一能力的维度上净胜率为正——音频指令遵循 +7.1%、参考一致性 +6.6%、音画同步 +5.9%、音频质量 +3.3%。 批判点评:把任务差异全部下沉到「token 角色 + 位置类型」的配置层、而不是每个任务加一个分支,是目前统一音视频模型里比较干净的一种抽象,作者也没有粉饰总体净胜率是负的这一点。但代价同样清楚:底座是别人的 LTX-2.3,全参数微调 5 万步,单卡 batch 只有 1;总体 -1.9% 意味着「统一」眼下换来的是特定维度的优势而非全面超越;作者自己也承认长时程一致性、精细局部编辑和多语言多说话人语音仍未解决。Vorch Team 未公开所属机构,权重与代码也没给出时间表。 3. Vorch-Streamer:27.12FPS边说边生成数字人 Vorch-Streamer: Extending Human Audio-Visual Generation to Real-Time Long-Form Streaming | Vorch Team·同济大学·哈工大深圳·上海交大 | arXiv:2608.05663 关键词:实时流式生成,数字人,Self Forcing,DMD蒸馏,语音规划token 前序问题:实时数字人要求边生成边播放,模型只能看历史不能看未来。把预训练的双向音视频扩散模型改成因果流式有两个坎:一是自回归复用自己生成的块会累积曝光偏差,几十秒后身份漂移、画面糊掉;二是给定一整段要说的话,因果生成器在只有局部上下文时并不知道当前这一块该说到哪一句。 本文贡献:在 22B 的 LTX2.3 音视频底座上做三阶段后训练。先用同一个底座合成 8 万条 12–21 秒的数字人音视频语料,保证监督信号与初始化同源;再以样本级混合 Teacher Forcing 与 Diffusion Forcing 训出 20 步因果短流式模型;最后做长时程 Self Forcing,让因果学生在完整 12–21 秒时域上自我 rollout,冻结的原双向模型作为 real-score 教师做 DMD 蒸馏,把双向模型的画质迁移到因果长轨迹上,同时把去噪压到 4 步。语音进度用外部语言模型预测 25 Hz 的离散「说话规划 token」——与 LTX 音频 latent 同频率,因此每个因果块都能拿到属于自己那一秒的语音内容。 实验效果:768×512、24 FPS 设定下,单张 H200 上端到端 DiT 吞吐 27.12 FPS,是评测中唯一越过 24 FPS 实时播放线的原生 T2AV 方法,且不需要外部音频或参考首帧。约两分钟的连续 rollout 在 0/30/60/90 秒采样帧上仍保持身份与场景一致,音唇同步 Sync-C/Sync-D、词错率、VBench2 身份与人体结构指标均有竞争力。推理用 3+1 因果窗口(三个常驻前缀块加最近一块)。训练侧第二阶段 64 张 H200 跑 6000 步,第三阶段 32 张 H200 跑 1000 步。 批判点评:「实时」这次是有明确定义的:24 FPS 播放线、单卡、四步去噪、有界上下文,比笼统说加速可信得多,25 Hz 说话规划 token 也确实解决了因果生成器不知道该说哪句的具体问题。但 27.12 FPS 建立在 H200 和 768×512 这个不算高的分辨率上,换消费级显卡或上 1080p 结论就不成立;训练语料是底座自己合成的 8 万条,风格和多样性都受限于教师,真人视频上的泛化没有验证;两分钟的 rollout 也还不是「无限长」。 4. Vorch-Director:22个镜头分钟级不掉线 Vorch-Director: Interactive World Story Model via Noise-Aware Error Rectification | Vorch Team·浙江大学 | arXiv:2608.05776 关键词:长视频续写,曝光偏差,噪声感知残差,多镜头故事,ST-Bench 前序问题:分钟级音视频靠自回归续写实现:把长视频切段,第 t 段以前面已生成的画面和声音为条件。但训练时喂的是干净的真值历史,推理时喂的是模型自己带着漂移、模糊和音画错位的输出,误差一段段滚雪球,最终身份跑偏、画面变平、声画不同步。已有做法把预测残差当作合成噪声注入历史来缩小这个落差,但都用一个与噪声水平无关的固定强度。 本文贡献:作者观察到残差修正是否有效,关键取决于残差是在流匹配的哪个噪声水平上产生的。于是把每条残差连同它产生时的噪声水平 σ 一起存下来,训练某个 σ 步时只采样同一噪声区间的残差并缩放到该区间,让注入的错误和去噪过程真正对齐;这样既保留了 teacher forcing 的训练效率,又造出接近推理分布的历史。配套设计包括始终不加噪的干净锚定窗口(clean sink),以及区分历史视频、参考图像、目标视频的任务嵌入,支持多镜头、多主体、参考引导的长时音视频生成。 实验效果:在 30 个用例、每例约 10 个镜头的多镜头故事基准 ST-Bench 上,用统一评测器重跑全部方法(不混用已发表数字),四项跨镜头一致性指标全面领先,ViCLIP 达 0.7887 而最强基线只有 0.5900,两项长程指标 ARC 与 Reappear 同样领先;对比对象包括 StoryDiffusion+Wan、StoryMem、HoloCine、Memento。另在 200 例的 UnityShots 上跑了 T2V 与 R2V 两种设定,并自建带同步语音、音乐和音效的长音视频基准,每例连续 22 个镜头达到分钟级,配套提出质量漂移和锚定相对一致性两个长程退化指标。 批判点评:「残差要按噪声水平配对注入」是个很具体也很容易被忽略的细节,作者还老老实实用同一评测器重跑所有基线,避免了各家用各自设定报数字的常见问题,新增的长程漂移指标也补上了平均分掩盖退化的缺口。但基线的画质与文本一致性其实并不输,领先主要集中在跨镜头一致性这一类指标上;ViCLIP 0.7887 对 0.5900 的巨大差距有多少来自方法本身、多少来自 LTX-2 底座与基线不同,论文没有拆开;自建基准由自己定义、自己评测,说服力要等第三方复现。 5. KVAE:音图视三件套PSNR多涨1dB KVAE: Family of Tokenizers for Multimodal Generative Models | Kandinsky Lab | arXiv:2608.05798 关键词:视觉tokenizer,VAE,音频编解码,因果压缩,开源 前序问题:潜空间扩散的天花板一半压在 tokenizer 上:压缩率、通道数、因果性直接决定生成模型的学习速度和最终画质。但开源社区里 tokenizer 的训练细节、选型方法和设计取舍几乎都藏在大模型报告的角落,后来者只能反复踩坑。 本文贡献:一次性放出覆盖三种模态的 KVAE 全家桶并开源:KVAE-Audio 是 48 kHz 全带宽连续音频 tokenizer,latent 帧率 50 Hz、64 通道;KVAE-3D 是两个因果视频 tokenizer,压缩率分别为 4×16×16(64 通道)和 4×8×8(16 通道);KVAE-2D 是空间 8 倍压缩、32 通道的图像模型。视频侧刻意做成无注意力的纯 Conv3D 结构,配合缓存机制可以处理任意长序列,归一化用空间 RMSNorm 以便推理时调整分段大小,上下采样把时间和空间操作拆成先后两步。编码器解码器故意不对称:4×8×8 的解码器约为编码器的 1.3 倍,4×16×16 直接做到 5.3 倍,把容量押在需要生成能力的解码侧。 实验效果:在 MCL-JCV 720p 重建评测上,同压缩率分组内平均比 Wan-2.1(PSNR 34.3)、Wan-2.2(34.2)和 HunyuanVideo 高出 1 dB 以上 PSNR,LPIPS 损失可以忽略。生成侧用统一的 2B CrossDiT(Qwen-2.5VL 文本编码器、流匹配损失、同一批数亿图文数据和超参)只换 tokenizer 做对照:KVAE-4×16×16 与指标完全一致,相比 Wan-2.2 让出一点视觉观感换来更好的提示词遵循,对 HunyuanVideo-1.5 则在全部类别上被更多人选中;有意思的是 KVAE-4×8×8 出现客观指标与人评打架的情况——PSNR 不占优,盲测却名列前茅。整体对标 Wan-2.2、HunyuanVideo-1.5、FLUX.2、MovieGen、StableAudio、MMAudio,代码已在 GitHub 公开。 批判点评:肯把训练细节、选型方法和消融一起交出来的 tokenizer 报告非常少,这份等于给中小团队省掉一轮昂贵的试错,「客观指标与人评打架」的坦白也比一味报 PSNR 有价值。但要注意重建指标只在 MCL-JCV 一个数据集上测,生成对照又只用 2B 模型和数亿量级图文数据,能否外推到十亿级视频数据和更大生成骨干是未知数;1 dB PSNR 的领先在下游生成里究竟折算成多少可感知收益,论文自己的人评已经说明关系并不线性。 6. Latent Reward Register:寄存器读奖励省33倍GPU时 Latent Reward Registers for Diffusion Preference Alignment | 快手可灵Kling Team·中科大 | arXiv:2608.03929 关键词:偏好对齐,latent奖励模型,寄存器token,on-policy蒸馏,可灵 前序问题:扩散模型对齐人类偏好,通常只在最终生成图上算一个稀疏的终点奖励,几十步去噪要共享这一个分数,时序信用分配极其困难。想改成稠密奖励,又绕不开把中间 latent 解码回像素空间的高昂代价。 本文贡献:提出 Latent Reward Register:在冻结的 DiT 输入序列前面挂一串可学习、无位置的寄存器 token(实验用 K=32),让它们从中间带噪 latent 里直接读出终点偏好。关键在于这是一条独立读出通路,不改动生成器的隐藏状态和速度场,因此拿到的是贯穿整个去噪过程、可微分的稠密奖励。基于它给出两种用法:训练侧的 RG-OPD 沿 on-policy 轨迹蒸馏奖励引导的更新,绕开标准策略梯度里昂贵的完整 rollout;推理侧的 RGS 用量级匹配的奖励梯度直接引导采样轨迹,一个参数都不用改。 实验效果:在 ImageReward、HPDv2、HPDv3、GenAI-Bench 合计 54170 对样本上,把 latent 前向加噪到高噪声区 u=0.8 打分,寄存器在所有 latent 奖励模型中成对偏好准确率最高。训练侧 SD3-Medium 上 RG-OPD 的 HPSv3 达 11.57,高于 AlignProp 的 11.20、ReFL 的 10.84 和 Flow-GRPO 的 10.26,MUSIQ 74.9、CLIP-IQA 0.726 同时领先,GPU 时最多省到原来的三十三分之一;FLUX.1-dev 上 HPSv3 12.38 同样第一。推理侧 RGS 在免训练方法里刷新 SOTA,SD3-Medium 上 HPSv3 10.70 对 DNO 的 8.85、Demon 的 9.09,且 MUSIQ 与 CLIP-IQA 一并提升而非以画质换分数。代码与权重已开源。 批判点评:「不动生成器、只挂一串寄存器 token 去读奖励」是个很轻的接口设计,33 倍 GPU 时的差距对预算有限的团队几乎是能不能做在线对齐的分水岭,而且训练和免训练两条路复用同一套读出器。需要警惕的是奖励是从生成器自己的特征里读出来的,两者共享盲区时容易一起自我强化,论文报的 MUSIQ 与 CLIP-IQA 都是无参考指标,扛不扛得住长时间优化下的奖励攻击没有给出曲线;实验也集中在 SD3-Medium 和 FLUX.1-dev 两个文生图骨干,视频扩散上还是空白。 7. SURE:让奖励先说自己有多不确定 Sample-Adaptive Latent Rewards for Uncertainty-Guided Diffusion Post-Training | 中国电信TeleAI·上海交大 | arXiv:2608.06125 关键词:latent奖励,不确定度,奖励攻击,扩散后训练,TeleAI 前序问题:latent 奖励模型能在不解码回像素的前提下监督扩散模型,效率很高,但它们只吐一个标量分数。生成器无从判断这次反馈到底可不可信,一旦在模型本就没把握的样本上照单全收,优化方向就会跑偏,进而演变成奖励攻击。 本文贡献:让奖励模型同时输出「打多少分」和「这个分有多不确定」。SURE-LRM 为每个带噪 latent 预测一个高斯效用:均值是奖励分数,方差是预测的不确定度,且完全从成对偏好中学出来,不需要额外人工标注。SURE-REFL 再把这份不确定度用起来——在选定的去噪转移点上查询冻结的 SURE-LRM,把 detach 后的方差换算成同一转移点内样本之间的可信度权重,每个加权奖励只沿本地转移回传。整条链路留在 latent 空间,既不需要像素解码,也不需要展开完整去噪图。 实验效果:偏好预测上跨三个骨干的均值从 DiNa-LRM 的 70.51 提升到 72.14,FLUX.1-dev 上单点最大提升 2.30。不确定度确实有信息量:排错的样本残差方差平均高 24.26%,用方差识别排序错误的 AUROC 为 0.6941,只保留方差最低的一半样本可把成对准确率从 79.40% 抬到 90.10%。视频侧 VisionRewardDB 72.31%、T2V Ranking 71.70%,均为最好。图像后训练在三个生成器、九个骨干—指标组合里拿下八项第一;视频用 Wan2.1-480P-T2V-14B 后训练,VBench 质量、语义、总分均为评测中最高。作者还给出对照曲线:DiNa-LRM-REFL 的优化奖励持续上升而独立的 HPSv3 已经开始下跌(典型奖励攻击),SURE-REFL 两条曲线则能同步更久。 批判点评:把「奖励可不可信」显式建模出来,比事后加正则更对症,方差—错误率的诊断也做得实在。但不确定度是无监督学出来的,AUROC 0.6941 说明它只是弱信号,离可靠的置信度校准还有距离;作者自己也承认「保留低方差一半准确率涨到 90.10%」这组样本训练时见过,属于分布内诊断而非留出校准。更根本的是,可信度只在同一转移点内做相对比较,如果整个时间步的奖励模型集体偏了,加权也救不回来。 8. LC-GRPO:动态度从12.5救回45.8 LC-GRPO: Bridging Train-Inference Gap for Flow-Based GRPO with Langevin Correction | 普林斯顿大学·加州大学圣地亚哥分校 | arXiv:2608.05600 关键词:Flow-GRPO,Langevin修正,训练推理错配,奖励攻击,强化学习 前序问题:流匹配模型推理时解确定性 ODE,而在线强化学习需要随机 rollout 来探索,于是现有 GRPO 训练时把 ODE 换成 SDE。连续时间下两者边缘分布相同,但有限步离散化后差别很大:探索噪声一大,SDE rollout 就发糊,拿这些糊掉的样本算奖励去训练,和最终 ODE 采样器生成的东西对不上号。 本文贡献:每一步 rollout 先走一步与推理对齐的 ODE Euler,再补一步针对该时刻边缘分布的随机 Langevin 修正。修正需要的 score 直接从流速度里换算出来,不用额外训练 score 模型;修正后的转移仍是各向同性高斯,似然可解析,能直接喂给策略优化。理论上作者证明:在合适条件下一步 Langevin 修正能降低不完美 ODE Euler 步的 Wasserstein 误差;在随机性水平匹配时,该转移比反向 SDE 的标准 Euler–Maruyama 离散更准确。 实验效果:SD3.5-Medium 上文字渲染 OCR 奖励做到 0.960,高于 Flow-GRPO 的 0.914 和 CPS 的 0.935,且 ImageReward 1.00、CLIP 0.291 等旁路质量指标不掉;人类偏好对齐 HPS-v2.1 达 0.393 对 0.381。FLUX.1-Dev 上 HPS-v2.1 0.384、PickScore 23.28 均第一。最刺眼的是视频:HunyuanVideo 用 VideoAlign 视觉质量做奖励,DanceGRPO 把 VBench 动态程度从原模型的 52.8 压到 12.5(画面几乎不动来骗高分),LC-GRPO 保住 45.8,同时 VideoAlign 视觉质量从 -0.205 提到 0.063、VBench 总分 79.10。计算上并不占便宜:Langevin 每步两次前向,作者让基线跑同样和两倍的 rollout 步数取更好结果。 批判点评:指出「训练用 SDE、推理用 ODE」这个人人默认却没人细究的错配,还给了 Wasserstein 误差的理论支撑,而不是纯经验 trick,视频那组动态程度 12.5 对 45.8 更是把奖励攻击拍在明面上——很多 GRPO 的涨分其实是靠画面变静态换来的。要留意每步两次前向的开销是实打实的,作者靠给基线加倍步数来对齐算力,但这不完全等价于同等 wall-clock;实验只覆盖 512×512 分辨率和 HPS、CLIP、OCR 这几类可打分奖励,更主观的美学或叙事奖励是否同样受益尚不清楚。 9. In-Context Forcing:上下文加噪反而提速82% In-Context Forcing: Uncovering Context Effects in Autoregressive Video Diffusion | 上海科技大学·腾讯优图·浙江大学 | arXiv:2608.05237 关键词:自回归视频扩散,噪声上下文,跨帧并行,推理加速,Self Forcing 前序问题:少步自回归视频扩散在生成当前帧的每一个去噪步时,都拿前面已经彻底去噪的干净帧当上下文。干净帧泄露了太多局部细节,模型顺手抄过来就行,结果时序语义被削弱、画面越生成越静止。而如果简单地给上下文加同样强度的噪声,引导又不够,时序一致性会崩。 本文贡献:借「扩散即掩码」的视角重新设计上下文:让上下文帧带上递减的噪声水平——离得远的帧掩得少、紧挨着的帧掩得多,形成渐进式自回归范式,既保住时序一致性又留出帧间动态。更实际的收益是,一旦不再严格依赖「前面必须是干净帧」,跨帧就能并行去噪,推理不再是一条串行长链。训练上以 Wan2.1-T2V-14B 为教师、其因果版 1.3B 为学生,batch 64 跑 1900 步。 实验效果:VBench 上视觉保真度和推理速度双双超过现有方法。逐帧设定下吞吐从 Self Forcing 的 8.9 FPS 提到 16.2 FPS,相对提速 82%,总推理时间减少 45.1%;即便在本已优化过的分块设定下也还能再省 9.3% 时间。30 秒长视频差距最明显:动态程度 86.40 对 Rolling Forcing 的 40.63——后者训练测试不一致的问题会随着滚动窗口反复传播,越长越静止。盲测 A/B 用户研究中相对 Wan2.1、CausVid、Self Forcing 三个基线均获偏好。 批判点评:「给上下文加噪反而更好」违反直觉但解释得通:干净帧提供的是模型可以偷懒复制的捷径。更漂亮的是解开干净帧依赖后顺带解锁跨帧并行,质量和速度不再是二选一。不过 82% 提速是在逐帧这个本身效率最差的设定下取得的,切到实际常用的分块设定就只剩 9.3%,标题数字有挑好看的成分;学生模型只有 1.3B,是否能迁移到 14B 级别未验证;动态程度高也不等于运动合理,86.40 里有多少是有意义的运动仍需人眼确认。 10. Diff-VF:免训练把短视频拉长4倍 Diff-VF: Training-free High-quality Long Video Generation via Diffusion Model | 上海交大·上海人工智能实验室 | arXiv:2608.05976 关键词:免训练长视频,窗口融合,噪声初始化,VBench-Long,即插即用 前序问题:现有视频扩散模型基本都用 10 秒以内的短视频训练,直接外推到长视频就会崩:要么长程语义漂移,要么为了保一致性把画面拍成几乎静止。而重新训练长视频模型既缺数据也缺算力。 本文贡献:提出免训练、即插即用、与骨干无关的 Diff-VF,全部操作只在噪声 latent 上做,因此不挑空间时间建模方式。三招配合:混合噪声初始化用第一段噪声锚定全局语义、后续段追加噪声补充内容多样性;加权窗口采样给每个窗口内的帧按到窗口中心的距离分配权重,让重叠区平滑过渡而不是简单平均出接缝;时间扩展采样把视频按固定间隔抽成若干等距子片段分别去噪再还原顺序,用随时间步变化的融合建立长程依赖。此外用跳跃残差引导把框架扩展到长视频增强,在保真与真实感之间做时间步相关的平衡。 实验效果:在 LaVie 上做 VBench-Long 评测,相比基座模型(主体一致性 0.8546、动态程度 0.9722)和免训练基线,Diff-VF 主体一致性升到 0.9164、动态程度 0.7208,高于 FreeNoise 的 0.6958 和 FreeLong 的 0.5625;整体一致性 0.2795 与人物动作 0.9580 均为最好,运动平滑度 0.9529 也居首。换到 HunyuanVideo 同样有效,说明对 2D+1D 与 3D 注意力两种结构都适用,生成长度是基座原生输出的 4 倍。对比对象包括 FreeNoise、FreeLong 和 RIFLEx。 批判点评:一行权重都不改就把短视频骨干拉长 4 倍,这类方法的部署成本几乎为零,权重函数和等距采样的设计也确实比简单平均更讲究,作者跨两种注意力结构验证了通用性。但要看清代价:基座原本 0.9722 的动态程度被压到 0.7208,只是压得比 FreeLong 的 0.5625 少而已,「一致性—动态性」的跷跷板并没有被打破,只是挪了个位置;评测停在 LaVie 和 HunyuanVideo,没碰 Wan、CogVideoX 这些主流骨干;4 倍长度对分钟级叙事而言仍然偏短。 趋势观察 统一多模态预训练开始有可复现的经验定律 — Meta 用 13.5B MoE、2T token 做单变量对照,得出语言 70%、理解 25%、生成 5% 的非对称配方,生成 token 少五倍反而把 GenEval 从 0.467 抬到 0.482;早期统一还是晚期对齐也不再是口味问题,晚接视觉会留下可测量的「视觉懒惰」。 音视频不再是先出画面再配音,而是同一条序列里的角色分配 — Vorch 三连发把目标、源、参考、历史统一成 token 角色与位置类型:Omni 一套权重覆盖 30 多种条件—输出组合,Director 用噪声配对的残差注入把 22 镜头的分钟级故事撑住,Streamer 在单张 H200 上把文本直出音视频推到 27.12 FPS。 奖励模型集体搬进 latent 空间,并开始交代自己的可信度 — 可灵的 Latent Reward Register 在冻结 DiT 上挂 32 个寄存器 token 直接读奖励,GPU 时最多省 33 倍;TeleAI 的 SURE 让奖励同时输出方差,把不确定的反馈自动降权。稠密、可微、带置信度的中间奖励,正在取代只看最终成图的稀疏打分。 强化学习和自回归都在补同一个洞:训练与推理不一致 — LC-GRPO 用 Langevin 修正让 rollout 与推理时的 ODE 采样对齐,把 DanceGRPO 压到 12.5 的 VBench 动态程度救回 45.8;In-Context Forcing 让上下文带递减噪声以匹配测试分布,30 秒长视频动态程度 86.40 对 Rolling Forcing 的 40.63。两者都说明:很多所谓的涨分,只是模型学会了让画面别动。 Tokenizer 和免训练技巧仍是被低估的杠杆 — Kandinsky Lab 把音频、图像、视频三套 tokenizer 连同训练细节与选型方法一起开源,重建 PSNR 平均比 Wan-2.2、HunyuanVideo 高 1 dB 以上;Diff-VF 不动一行权重,仅靠噪声初始化、加权窗口和等距采样就把短视频骨干拉长 4 倍。不是每个提升都需要重训一个大模型。 人工智能炼丹君 整理 | 2026-08-07 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-08-06|京东22B音画同修让百年老片复活OmniVR 今日 AIGC 论文速览 今日共 10 篇 · 音视频联合生成与修复 2 篇 · 实时与交互视频创作 2 篇 · 多模态Token高效压缩 2 篇 · 生成后训练与条件对齐 2 篇 · 评测与专业可控生成 2 篇 重点论文标题列表 OmniVR(中科大·京东探索研究院):22B让百年老片音画一起复活 JoyAI-Video-Edit(京东Joy Future Academy):16B单卡30FPS实时剪视频 ContextMaster(清华·南京大学·快手可灵·上科大·港科大):固定预算多镜头创作跑16.74FPS OmniPack(西北工业大学·北大·阿里·清华):无训练6.8%算力保住92.9% STEP-OPD(上海交大·阿里):蒸馏学生越过教师得分0.961 今日论文速览 1. OmniVR:22B让百年老片音画一起复活 OmniVR: Joint Video-Audio Conditional Generation for Restoring Degraded Historical Films | 中科大·京东探索研究院 | arXiv:2608.04224 关键词:音视频联合修复,历史影像,LTX-2,多模态DiT,京东 前序问题:历史影像往往同时存在模糊、噪声、闪烁、曝光不足,以及嘶声、削波、掉音和带宽缺失。现有修复器通常把视频与音频拆开处理,不仅留下单模态质量短板,还可能破坏口型、动作和声音之间的同步。 本文贡献:提出首个音视频联合生成式老片修复模型 OmniVR。系统从 22B 参数 LTX-2 音视频骨干出发,把低质音频和视频编码成联合条件,在统一多模态 DiT 中同步去噪;以联合退化管线模拟真实老片损伤,用近零初始化通道拼接与提示词退火把 T2AV 平滑改造成 AV2AV,再以首帧锚定、模态损失重加权和波形监督支持跨 121 帧窗口的长视频修复。 实验效果:在 200 段真实历史片组成的 OmniVRBench 上,真实轨 MUSIQ 达 61.87,显著高于次优 RealBasicVSR 的 52.38;DNSMOS 从退化输入的 2.04 提升至 2.43,FAD 从 15.93 降至 8.32。12 名标注者给出 80.0% 综合偏好。模型输出 1920×1088,作者还报告在独立 RTN 老片基准的六项无参考视觉指标上全部第一。 批判点评:把“修画面”和“修声音”变成一次联合条件生成,方向比串联两个修复器更完整,指标和人评也有说服力。但 22B 骨干以 rank-384 LoRA 在 64 张 H200 上训练约 5 天,成本很高;强生成先验可能补出原片不存在的纹理与颜色,历史档案、司法取证等场景仍需要真实性约束。代码和权重目前只是承诺公开。 2. JoyAI-Video-Edit:16B单卡30FPS实时剪视频 JoyAI-Video-Edit: Real-Time Open-Ended Video Editing with Autoregressive Diffusion | 京东Joy Future Academy | arXiv:2608.03974 关键词:实时视频编辑,自回归扩散,两步蒸馏,720p,京东 前序问题:直播和视频通话中的编辑必须边接收边输出,不能偷看未来帧,也不能让显存和计算随视频时长不断增长。把离线编辑器简单切成小段会产生边界跳变,自回归地反复使用生成历史又会累积色偏、身份漂移和背景幻觉。 本文贡献:提出 16B 自回归扩散编辑框架:MLLM 条件编码器理解指令和参考,因果 VAE 与分块双向、跨块因果注意力负责流式输出,滑动窗口加首块全局 sink 把历史状态限制在固定预算。Source-Anchored DMD 将多步扩散蒸馏为两步,并用当前源视频块约束教师目标;长程自回归蒸馏则在分段 rollout 上直接学习累积误差。 实验效果:结合两步生成、固定历史 KV 缓存、FP8 量化和优化 VAE 管线,完整系统在单张 NVIDIA B200 上实现端到端 720p 约 30 FPS。自动指标和人评均显著超过现有流式编辑器,在短视频与长视频上可与强离线系统竞争;代码已经公开。 批判点评:这是今日最硬的工业数字:16B 模型把开放式编辑真正推到实时帧率,而且处理时无需预知视频总长度。但单卡指的是昂贵的 B200,30 FPS 不能外推到消费显卡;两步扩散和 FP8 的细节损失、长达数小时的稳定性以及输入输出延迟分布,还需要独立复现。 3. ContextMaster:固定预算多镜头创作跑16.74FPS ContextMaster: Interactive Multi-Shot Video Creation via Fixed-Budget Sparse Context Routing | 清华·南京大学·快手可灵·上科大·港科大 | arXiv:2608.04956 关键词:多镜头视频,交互创作,稀疏路由,上下文缓存,可灵 前序问题:真实视频创作会在多轮中交替生成新镜头、引用人物或场景、编辑已有素材,并持续继承历史。若每个去噪步都密集读取不断增长的上下文,延迟会随会话变长;若只保留短窗口,又会忘掉早期角色与约束。 本文贡献:提出交互式多镜头视频创作 IMVC 与统一模型 ContextMaster。角色感知 RoPE 区分参考图、历史镜头、源视频和待生成目标;可缓存的干净上下文只预填一次,块稀疏路由在固定预算内检索相关历史,ConstraintSink 强制保留参考和逐帧编辑约束。两阶段特权上下文蒸馏先用稠密教师做一致性蒸馏,再用分布匹配修复少步 rollout 的细节。 实验效果:在单张 H200、匹配分辨率与帧数的设置下,五镜头任务平均达到 16.74 FPS;跨镜头一致性由强基线的 0.808 提升到 0.836,并在文本生成、参考生成和视频编辑三类任务中取得最强综合表现。固定 6-FE 读取预算接近质量与速度最佳点。 批判点评:这项工作把多镜头创作从一次性提示升级为有状态工作流,并让每轮上下文读取保持定额,产品形态很清晰。但 16.74 FPS 仍依赖 H200;路由器漏掉关键旧镜头会造成不可逆遗忘,角色一致性也不等于剧情因果一致。训练阶段还使用 64 张 H200,复现门槛不低。 4. OmniPack:无训练6.8%算力保住92.9% OmniPack: Unified Token Compression for Efficient Omni-modal Large Language Models | 西北工业大学·北大·阿里·清华 | arXiv:2608.03812 关键词:全模态大模型,Token压缩,免训练,音视频理解,推理加速 前序问题:全模态大模型同时接收长视频与音频时,视觉和声音 token 数远超文本。现有压缩要么在进入 LLM 前过早丢掉分散在长时间轴上的证据,要么进入 LLM 后只听文本指令,没有充分利用已经对齐的音视频交互。 本文贡献:提出免训练两阶段压缩框架 OmniPack。LLM 前按模态重要性、全局覆盖和相似度合并结构冗余,把被删除信息回收到代表 token;多模态充分交互后,再用文本问题引导和音视频协作做第二次语义压缩。不同阶段分别处理“结构重复”和“任务相关性”,无需改权重。 实验效果:在 Qwen2.5-Omni-7B 上仅用原始 16.7% FLOPs 即保留 98.0% 性能;极限设置只用 6.8% FLOPs 仍保留 92.9%。15%/7.5% 两阶段保留率下,FLOPs 降低 10 倍、prefill 加速 4.5 倍,同时保留 95.6% 性能,并跨三种骨干、五项基准保持最佳效率折中。 批判点评:无需训练且跨 Qwen 与 MiniCPM 骨干有效,工程接入成本很低;把“先保全局结构、后按问题精炼”拆开也比统一打分更合理。不过结果主要来自 H20 上的 prefill,端到端对话延迟和 KV 缓存收益未完全等同;极低预算仍损失约 7% 综合性能,稀有短暂事件可能最先被压掉。 5. STEP-OPD:蒸馏学生越过教师得分0.961 STEP-OPD: Rethinking Output Targets and Internal Dynamics in On-Policy Distillation for Diffusion Models | 上海交大·阿里 | arXiv:2608.04887 关键词:扩散蒸馏,On-policy,超越教师,表示对齐,图像生成 前序问题:扩散模型的 on-policy 蒸馏通常只让学生在自己的去噪轨迹上拟合教师速度,理论最优点就是“和教师一样”,无法主动超过教师;只看最终输出还会放任各 Transformer Block 的内部表示以错误方式相互抵消。 本文贡献:提出 STEP-OPD:把任务教师相对共享基础模型的速度差视为能力提升方向,将缩放后的差值继续加到教师目标上,构造“教师之外”的输出外推目标;同时不直接硬对齐隐藏状态,而是匹配相邻 Block 表示变化的方向和幅度,让学生学习能力在网络内部如何逐层形成。 实验效果:在组合对齐、文字渲染与人类偏好三组能力上统一超过标准 DiffusionOPD,并使 GenEval 从 0.927 提升到 0.961;统一学生在三类能力上分别超过对应的单任务教师,证明多教师能力整合不必以教师上限为终点。 批判点评:“教师减基础模型”的差向量能否稳定代表可继续外推的能力,是很有启发性的假设,内部变化对齐也补上了只看终点的盲区。但外推系数依赖任务调参,走得太远可能放大教师偏差;目前只验证图像生成,扩展到视频等更长序列后,中间层监督的显存和计算成本会更突出。 6. TD-V2A:帧间差分让视频配音FAD降至0.53 Visual Representation Matters: Exploiting Temporal Differences in Video-to-Audio Generation | 清华·南洋理工等 | arXiv:2608.04902 关键词:视频配音,帧间差分,音频扩散,时间对齐,视觉表征 前序问题:视频配音区别于看图配音的核心不是多看几张静态图,而是捕捉帧间运动变化。现有方法常外挂音视频对比模型、声学结构预测器或多模态大模型,系统复杂,且可能把真正决定声音时机的低层运动细节压掉。 本文贡献:提出 TD-V2A,直接把相邻帧差分作为额外视觉条件。作者比较像素帧差与编码后特征差,发现编码前差分保留的细粒度运动更有效;训练时以文本到音频预训练、原始视频条件、差分增强条件三阶段持续学习,采样时用退火差分引导在早期先确定全局声音动态,后期逐渐回到原始视觉语义。 实验效果:在约 1.5 万段 VGGSound 测试片上,FAD 达 0.53,优于 MMAudio 的 0.81;IS 达 16.9、ImageBind Score 达 33.8,均明显高于对比方法,时间对齐准确率 89.1。它甚至超过需要额外训练的 CAVP 音视频表示,且没有新增预测网络。 批判点评:把“视频比图片多出来的信息”直接定义为帧差,简单而有效,指标也说明低层运动不应过早被语义编码器抹掉。但逐帧差分对镜头切换、抖动和光照闪烁同样敏感,可能把无关变化误当声源;其时间对齐 89.1 仍略低于专门以对齐目标训练的 Diff-Foley 89.9。 7. CAPE-T2V:训练推理两头对齐提示词 CAPE-T2V: Captioner-Anchored Prompt Enhancement toward Two-Sided Conditioning Alignment in Text-to-Video Generation | 复旦·快手可灵 | arXiv:2608.03046 关键词:文生视频,提示增强,训练推理对齐,Caption,可灵 前序问题:视频 DiT 训练时看到的是详尽视频 caption,线上却由 Prompt Enhancer 把用户短句改写后再喂给模型。即使双方使用同一字段模板,细节选择、组织方式、粒度和措辞仍不同,形成残余 PE-Caption 分布缺口。 本文贡献:提出两步 Captioner-Anchored 对齐:先用外部视频描述器产生统一目标,把简短描述、详细描述和伪用户提示都训练成同一种 Anchored PE 输出;再让这个已经冻结的 PE 重写视频训练 caption 并微调 DiT,部署时仍由同一个 PE 改写用户提示,使训练侧与推理侧真正共享同一文本算子。 实验效果:在 Wan2.2 与 LTX-2.3、StoryEval/VBench-2.0/T2V-CompBench 的六个组合上全部超过只做 schema 对齐的基线。Wan2.2 分别提升 1.6、1.12、0.30 分,LTX-2.3 提升 1.4、0.92、0.65 分;caption 到推理改写的 MMD² 从 0.0764 降至 0.0682。 批判点评:工作指出“字段相同不等于分布相同”,并把 Prompt Enhancer 正式视作生成模型接口,诊断很贴近真实部署。但绝对增益多数只有 0.3–1.6 分,StoryEval 又使用 GPT-5.5 判定;一旦线上 PE 更新,就要重新改写训练 caption 并适配 DiT,维护成本仍然存在。 8. Two-Stage Token Pruning:只留10%视频Token还涨7分 Adaptive Two-Stage Visual Token Pruning for Efficient Inference in Video-Language Models | Amazon | arXiv:2608.03112 关键词:视频语言模型,Token剪枝,免训练,自适应预算,Amazon 前序问题:视频语言模型每帧可产生数百视觉 token,数分钟视频很快进入万 token 区间。现有图像剪枝方法既忽略跨帧重复,又对所有视频使用固定保留率;静态访谈和高速运动显然不该被压成相同预算。 本文贡献:提出完全后处理的两阶段自适应剪枝:先在时间轴选择差异最大的代表帧,再在保留帧内做 token 级裁剪。第二阶段对 token 相关矩阵做特征值分解,用谱衰减速度估计当前视频冗余度,并据此动态决定保留比例,无需训练或微调原模型。 实验效果:在三种 VLM、五项视频基准上持续增益;平均仅保留 10% token 时,VideoDC 准确率达到 76.75%,比同预算 DivPrune 的 68.47% 高 8.28 分,论文摘要按跨设置概括为约 +7%;同时 TFLOPs 降低约 95%,其他问答基准基本保持。 批判点评:把“删哪些帧”和“每帧删多少 token”分开,并让谱结构决定预算,符合视频冗余的实际差异。代价是特征值分解本身有额外开销,当前实验以短视频理解基准为主;突发但关键的一帧或小目标,仍可能在两轮剪枝中被不可逆丢失。 9. OmniEdit-Bench:五赛道揭穿视频编辑假高分 OmniEdit-Bench: A Comprehensive Benchmark for Instruction-based Video Editing | 港大·阿里通义万相·浙大·北大 | arXiv:2608.05049 关键词:视频编辑评测,音频编辑,时间编辑,推理编辑,通义万相 前序问题:很多视频编辑评测沿用图像编辑任务,只看逐帧空间变化;模型即使没有执行指令,只要保留原视频的高画质和一致性,也可能得到高分。音频、时间操作、参考条件和隐式推理因此长期缺席。 本文贡献:构建覆盖空间 240、时间 200、参考 200、音频 100、推理 50 个案例的五赛道基准,并区分显式与隐式指令。评测把质量拆成准确性、保留度、真实感和一致性,再以准确率作为门控缩放后三项,避免“看起来很好但改错了”获得虚高总分。 实验效果:商业与开源模型整体都远未过关:KlingV3-Omni 综合最高也仅 38.3/100,Seedance 2.0 为 37.3;时间赛道最好 Wan2.7-Edit 只有 29.0,推理赛道最好 Seedance 2.0 也只有 29.8。商业模型在空间编辑领先,但优势在音频、时间和推理任务明显收窄。 批判点评:把准确性设为其他质量分的前提,能有效纠正原视频先验造成的假高分;五赛道也比图像式评测更接近真实需求。不过大量评分仍依赖 VLM,门控权重是人为设计;部分商业模型因功能或版权限制没有覆盖全部赛道,横向平均并非完全同条件。 10. CSGen:2.4万样本守住血管道路裂缝 CSGen: A Multi-Domain Curvilinear Structure Generation Model via Hierarchical Multimodal Diffusion | ACM MM 2026·海南大学·广东海洋大学 | arXiv:2608.04655 关键词:可控生成,曲线结构,拓扑保持,专业数据,ACM MM 前序问题:血管、道路、叶脉和裂缝只占图像极少像素,却要求细长分支持续连通。通用扩散模型更擅长生成大物体,普通 MSE 又被背景像素主导,容易把这些稀疏结构画断或偏离控制图。 本文贡献:提出基于 SD3.5 的层次多模态扩散模型 CSGen,并汇集 24678 个样本,覆盖血管、冠脉、混凝土裂缝、叶脉和道路五域及七类标注。分阶段注入 CLIP 拓扑属性与 T5 场景描述,先锁定结构再补环境;稀疏感知损失按等效直径提高细小脆弱分支的权重。 实验效果:相同提示下 FID 达 98.525,优于 SD3.5-ControlNet 的 131.256;完整模型将拓扑 clDice 从基线 0.628 提升到 0.766。合成数据用于下游分割时,道路域 mIoU 最高增加 4.73 分,说明生成结果不只视觉像真,也能补充结构学习。 批判点评:这是 ACM MM 2026 已接收工作,数据、代码和结构指标较完整,说明专业生成不能只看通用审美分。但五个领域仍共享相对简单的二值拓扑先验,跨域统一性有限;合成图提升分割不等于临床或基础设施诊断可靠,专业场景还需真实分布验证。 趋势观察 音视频联合模型开始从内容生成反向进入修复 — OmniVR 直接复用 22B 音视频生成骨干,同时恢复老片画面、声音与同步关系;统一生成先验正在吞并过去彼此独立的增强管线。 视频编辑从固定短片走向实时、有状态和开放时长 — JoyAI 用两步自回归扩散在单 B200 达到 720p 约 30 FPS,ContextMaster 则以固定预算上下文支撑多轮多镜头创作,视频模型正从一次生成器变成持续工作的创作系统。 Token压缩从固定比例升级为内容与问题共同决定 — OmniPack 先保全局音视频结构、再按问题做语义精炼,Amazon 两阶段方案先删重复帧、再按谱冗余决定每帧预算;高效推理正在告别一刀切剪枝。 生成后训练不再满足于复刻教师或单边修补接口 — STEP-OPD 沿教师相对基础模型的能力方向继续外推,CAPE-T2V 则让同一个 Prompt Enhancer 同时定义训练与推理文本分布,优化目标从局部模仿转向端到端系统对齐。 视频能力评测开始补齐时间、声音与隐式推理 — OmniEdit-Bench 的五赛道显示最强商业编辑模型综合仍不足 40 分;TD-V2A 也证明只看语义无法评价配音,时间差分与同步指标将成为音视频系统的基本维度。 人工智能炼丹君 整理 | 2026-08-06 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-07-03|北航ETH免训练让FLUX画图提速25倍MrFlow 今日 AIGC 论文速览 今日共 5 篇 · 文生图生成加速与效率 2 篇 · 可控图生视频 1 篇 · 生成安全与对齐 1 篇 · 多模态视觉推理与评测 1 篇 重点论文标题列表 MrFlow(北航·ETH苏黎世):免训练多分辨率提速25倍 GEAR(北大·腾讯混元):端到端联训VQ与自回归 TrajLoc(Amazon·特拉维夫大学):注意力高斯热图控多物体 SAGE(中佛罗里达大学):揭穿安全对齐高效用假象 PixelEyes(武汉大学·UC Merced):解耦推理与感知精准定位 今日论文速览 1. MrFlow:免训练多分辨率提速25倍 Multi-Resolution Flow Matching: Training-Free Diffusion Acceleration via Staged Sampling | 北航·ETH苏黎世 | arXiv:2607.01642 关键词:文生图,流匹配,免训练加速,多分辨率,超分辨率 前序问题:文生图扩散/流匹配质量随规模提升而算力暴涨(Qwen-Image-20B 单张 1024² 在 A100 上采样达 47 秒);已有免训练多分辨率加速在潜空间做上采样并选择性修改局部,常带来明显模糊或伪影。 本文贡献:提出 MrFlow——面向预训练流匹配模型的免训练多分辨率加速:分阶段「低分辨率快速生成主结构 → 像素空间用轻量预训练 GAN 超分 → 注入低强度噪声做高频重采样 → 高分辨率精修细节」,利用图像在不同分辨率下的结构一致与细节差异实现由粗到细的高效生成,无需任何训练或运行时动态识别,且可与时间步蒸馏正交叠加。 实验效果:在 FLUX.1-dev 与 Qwen-Image 上端到端加速达 10×,OneIG 指标较加速前差距控制在 1% 以内,显著超越其他免训练加速策略;叠加预训练蒸馏权重后进一步冲到 25× 加速。 批判点评:把「先低分辨率出结构、再像素超分、最后高分辨率精修」串成免训练流水线,几乎零训练成本换来 10-25× 提速、还能与蒸馏正交叠加,对 FLUX/Qwen-Image 这类主流模型即插即用,工程性价比极高。但收益依赖轻量 GAN 超分网络质量(论文也承认 Real-ESRGAN 最平衡),像素超分对强纹理/文字细节可能引入偏差、需高分辨率步纠正,极端 25× 场景仍要借蒸馏权重、并非纯免训练。 2. GEAR:端到端联训VQ与自回归 GEAR: Guided End-to-End AutoRegression for Image Synthesis | 北大·腾讯混元 | arXiv:2606.32039 关键词:自回归生成,VQ tokenizer,表征对齐,端到端训练,ImageNet 前序问题:视觉生成通常两阶段训练——先训 tokenizer 做重建再冻结,再在其离散索引/连续潜上训生成器;这种解耦让 tokenizer 完全不知道生成器「什么好建模」,且 VQ 索引不可微、直通估计(STE)会崩,梯度无法回传到 tokenizer。 本文贡献:提出 GEAR,端到端联合训练 VQ tokenizer 与自回归(AR)生成器,用表征对齐引导。关键是对码本分配做「双读出」:硬 one-hot 分支用下一 token 预测训练 AR,可微软分支携带表征对齐损失、只回传去引导 tokenizer——让 AR 主动把 tokenizer 推向自己更易预测的索引分布,把对齐负担从 tokenizer 转移到 AR(与扩散侧「让潜变量本身更语义」的做法正相反)。 实验效果:相比强基线 LlamaGen-REPA,ImageNet gFID 收敛最高提速 10×,学到明显更好的 patch 级、空间连贯特征,并可泛化到多种量化器(VQVAE/LFQ/IBQ)与文生图任务。 批判点评:用「双读出」优雅绕开 VQ 不可微、把表征对齐负担从 tokenizer 挪到 AR,是对两阶段范式的一次范式级反思,收敛提速 10× 且跨量化器/文生图泛化,北大+腾讯混元背景也更接近落地。但端到端联训的稳定性与显存开销、软分支对齐目标的设计敏感度,以及在更大分辨率/更大码本下能否延续优势仍待验证。 3. TrajLoc:注意力高斯热图控多物体 TrajLoc: Trajectory-Attention Localization for Multi-Object Motion Control | Amazon·特拉维夫大学 | arXiv:2607.00861 关键词:图生视频,多物体控制,轨迹控制,交叉注意力,身份保持 前序问题:图生视频(I2V)里控制多物体运动,既要保各自身份、又要遵循不同目标轨迹;已有方法把多条轨迹揉进共享的稠密条件信号,物体越多、路径交叉遮挡时对象级对应越难保持。 本文贡献:提出 TrajLoc,为每个物体施加严格的逐对象空间约束、彼此隔离:直接在注意力层里把每个物体 token 的交叉注意力权重替换为「以其每帧目标位置为中心的高斯热图」;同一套逐对象 token 接口通过可学习嵌入携带轨迹与深度,并以编码首帧外观替代物体 token 来保持身份一致。 实验效果:在含最多 20 个同时受控物体及分布外真实场景的六个数据集上,视觉保真与轨迹遵循度一致提升;应用于 CogVideoX-5B 与 Wan2.1-14B 两种异构骨干,较最强基线平均 +4.3 dB PSNR、轨迹终点误差降低 51%。 批判点评:用「把交叉注意力权重直接换成高斯热图」实现逐物体硬空间约束,简洁、可跨 CogVideoX/Wan2.1 骨干迁移,20 物体拥挤场景下轨迹终点误差降 51% 很实在。但高斯热图是相对刚性的先验,对形变大/尺度剧变或非刚体运动可能过约束,深度与轨迹共用一套 token 的表达上限、以及热图中心定位对细粒度交互(接触/穿插)的处理仍待观察。 4. SAGE:揭穿安全对齐高效用假象 The Illusion of High Utility in Safety Alignment of Text-to-Image Diffusion Models | 中佛罗里达大学 | arXiv:2607.00402 关键词:文生图,安全对齐,语义坍缩,几何正则,TIFA 前序问题:文生图安全对齐要压制有害生成同时保住良性提示的效用,但现有「高安全+高效用」的结论多建立在 FID/CLIPScore 等粗粒度全局指标上,对细粒度语义正确性不敏感,制造了「高效用假象」。 本文贡献:用结构化评测(TIFA 问答式忠实度)戳穿假象——安全对齐模型在物体数量、属性、关系上语义保真明显下滑;进而定位根因为文本编码器嵌入空间的「语义坍缩」(嵌入分布收缩+提示间相似结构扭曲),且与结构化效用损失强相关。据此提出结构感知几何正则(SAGE),在对齐时显式保住嵌入分布展度与提示间关系结构。 实验效果:SAGE 恢复了结构化效用(TIFA 较此前 SOTA +5.0%),同时保持强安全性能与有竞争力的粗粒度效用分数(已被 ECCV 2026 接收)。 批判点评:从「粗指标掩盖语义退化」这一反直觉观察出发、用嵌入几何正则对症「语义坍缩」,视角犀利、从诊断到方案闭环完整,TIFA +5.0% 也证明可恢复细粒度效用。但方案聚焦文本编码器嵌入几何、对更深层去噪网络诱发的语义损失覆盖有限,安全与效用的权衡在更强攻击/更广有害概念下能否稳住、以及 TIFA 之外评测的一致性仍需扩验。 5. PixelEyes:解耦推理与感知精准定位 PixelEyes: Decoupling Perception and Reasoning for Pinpoint Visual Evidence Seeking | 武汉大学·UC Merced | arXiv:2607.00115 关键词:多轮视觉推理,MLLM,指代分割,视觉搜索,评测基准 前序问题:多轮视觉推理里,MLLM 反复定位失败导致轨迹又长又冗余;根因是推理与感知纠缠在同一模型内——边推理边定位,定位不准又触发更多推理轮次、把轨迹撑大。 本文贡献:提出 PixelEyes,把推理与感知显式解耦:推理器只决定「找什么」,专用感知工具回答「在哪」。含两招——(1) 掩码引导视觉搜索:调用指代分割模型给出掩码级精确定位,免去推理器补偿粗糙 grounding;(2) 语义区域广度优先搜索(BFS):把探索组织为对语义区域的 BFS,消除反复裁剪错误子区域造成的冗余回路。并通过重合成专家轨迹构建 PixelEyes-6K 数据集,另建零提示视觉搜索基准 Pinpoint-Bench(含实例级掩码/框,区分定位失败与推理失败)。 实验效果:近期 SOTA 的 MLLM 与视觉推理智能体在 Pinpoint-Bench 上仍留有很大提升空间,印证其质量与难度;代码与模型已开源。 批判点评:把「推理定位纠缠」拆成「推理器+分割感知工具」两件事、再用语义区域 BFS 剪掉冗余回路,思路清晰且直击多轮视觉搜索的实际痛点,配套 Pinpoint-Bench 也补齐了「定位 vs 推理」失败区分的评测缺口。但方案依赖外部指代分割模型精度、分割错误会直接卡住定位,BFS 在超大图/极多语义区域下的开销,以及它属视觉理解/grounding 而非生成、与生成一体化的结合仍需后续工作。 趋势观察 免训练加速把文生图推向实时 — MrFlow 用分阶段多分辨率+像素超分免训练冲到 10-25×,加速正从「靠蒸馏训练」转向「零训练即插即用」,让 FLUX/Qwen-Image 这类大模型的推理成本快速下探。 端到端联训打破生成的两阶段范式 — GEAR 用双读出让 AR 反过来引导 tokenizer,把「先训 tokenizer 再训生成器」的解耦范式改成端到端联合优化,ImageNet 收敛提速 10×,范式级重构正在自回归生成里发生。 可控生成从单目标走向多物体精细约束 — TrajLoc 在注意力层用逐物体高斯热图硬约束最多 20 个物体的轨迹与身份,可控视频生成的粒度从「整体运动」细化到「每个实例的路径」。 生成安全开始正视效用的真实代价 — SAGE 揭穿安全对齐「高效用假象」,用结构化评测与嵌入几何正则守住细粒度语义,安全研究从「粗指标达标」转向「细粒度效用可验证」。 视觉智能体靠解耦感知与评测基准补短板 — PixelEyes 把推理与感知解耦、配套 Pinpoint-Bench,多轮视觉搜索开始用专用感知工具+可区分失败类型的基准来定位瓶颈。 人工智能炼丹君 整理 | 2026-07-03 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-29|生数科技minWM开源实时交互视频世界模型 今日 AIGC 论文速览 今日共 8 篇 · 视频世界模型 3 篇 · 流式视频生成 1 篇 · 音视频联合生成 1 篇 · 可控图像生成与数据 2 篇 · 大模型记忆与微调 1 篇 重点论文标题列表 minWM:实时交互视频世界模型全栈开源 NAVA:原生音视频对齐联合生成6.3B Gamma-World:多智能体生成式世界模型 AdaState:流式视频生成自演化锚点 YoCausal:视频生成因果性认知基准 今日论文速览 1. minWM:实时交互视频世界模型全栈开源 minWM: A Full-Stack Open-Source Framework for Real-Time Interactive Video World Models | 生数科技, 清华大学 | arXiv:2605.30263 关键词:视频世界模型·实时交互·自回归蒸馏·开源·生数科技 前序问题:视频扩散基础模型已能高质量出片,但把它变成实时交互视频世界模型仍然难:交互世界模型需要可控、因果、低延迟的 rollout,实践上要打通数据构造、可控微调、自回归训练、少步蒸馏、流式推理整条链路,而开源社区一直缺一套能跑通的端到端 recipe 本文贡献:minWM:全栈开源框架,把现成的双向 T2V/TI2V 视频基础模型转成「相机可控 + 少步自回归」的世界模型。先对双向扩散做相机控制微调,再用 Causal Forcing / Causal Forcing++ 流程(AR diffusion 训练 + causal ODE/consistency 蒸馏 + 非对称 DMD)蒸成少步自回归生成器做低延迟 rollout。框架模块化、架构可扩展:在 Wan2.1-T2V-1.3B(cross-attention 条件注入)和 HY1.5-TI2V-8B(MMDiT)上分别实例化,还能把 HY-WorldPlay 等已有世界模型适配到新数据分布、训练配方与延迟目标 实验效果:不止放出可运行脚本、checkpoint、文档和推理代码,还给出相机轨迹质量、可控性训练步数、最小 batch size 等实战 ablation——是这个方向少见的「能跑起来、可复现、可扩展」的实时交互视频世界模型配方 (github.com/shengshu-ai/minWM) 批判点评:「全栈开源 + 跨两种主流架构(Wan2.1 cross-attn / HY1.5 MMDiT)实例化 + 可适配已有世界模型」三点让它成为这个方向稀缺的工程基建,对想做实时交互视频的团队意义重大。但框架 / recipe 类工作的核心价值在工程完整度而非单点创新;Causal Forcing++ 与非对称 DMD 联训的稳定性、长 rollout 的累积漂移控制还可以披露更多 2. NAVA:原生音视频对齐联合生成6.3B Native Audio-Visual Alignment for Generation | 百度 ERNIE | arXiv:2605.30073 关键词:音视频联合生成·原生对齐·MMDiT·音色可控·百度 前序问题:联合音视频生成要做到时序同步 + 语义连贯,但现有开源方案要么走「双塔 + 后验对齐」(弱化细粒度音视频协同演化),要么走「三模态全统一」(把语义条件和底层同步耦死在一起)——两条路线都有结构性缺陷 本文贡献:NAVA:context-conditioned 的原生音视频对齐框架。先在专用交互空间建立音视频对应关系,再用外部 context 条件化联合去噪。用 Align-then-Fuse MMDiT 架构实例化,从「模态感知的音视频对齐」平滑过渡到「模态共享的联合去噪」;并提出 Timbre-in-Context Conditioning,把参考音色线索关联到对应语音片段,实现可控语音音色 实验效果:在 Verse-Bench 和 Seed-TTS 上配合用户研究表明:仅用 6.3B 参数即取得更优视频质量、精确的音视频同步、有竞争力的音频质量,以及更强的参考音色可控性 批判点评:「先对齐后融合」而非「一上来全统一」的设计直击双塔 / 三模态两条路线的痛点,6.3B 拿下多项指标性价比很高;Timbre-in-Context 把音色可控做进 context 是干净的设计。但「专用交互空间 + 联合去噪」的两阶段是否引入额外训练复杂度、对更长音视频的扩展性仍需观察 3. Gamma-World:多智能体生成式世界模型 Gamma-World: Generative Multi-Agent World Modeling Beyond Two Players | NVIDIA, 清华大学 | arXiv:2605.28816 关键词:多智能体·世界模型·RoPE·稀疏注意力·NVIDIA 前序问题:交互式视频世界模型大多聚焦单 agent(从单一控制信号生成未来观测),但很多生成环境需要多 agent 同时在共享空间行动(多玩家 / 机器人 / 具身体)。扩到多 agent 需要原则性设计:各 agent 独立可控、排列对称、推理高效,同时跨时间和视角保持一致 本文贡献:生成式多智能体世界模型。提出 Simplex Rotary Agent Encoding:3D RoPE 的无参扩展,把 agent 表示成旋转角空间里正单纯形的顶点,给每个 agent 不同相位又保持排列等价——无需学习 per-slot 身份或固定排序即可扩展 agent 身份;提出 Sparse Hub Attention:用可学习 hub token 中介跨 agent 交互,把跨 agent 注意力从二次降到线性。再把全上下文扩散 teacher 蒸成因果 student,带 KV cache 顺序生成时间块,实现 24FPS 的动作响应生成 实验效果:多人虚拟环境实验中,在视频保真度、动作可控性、agent 间一致性上超越 slot-based 和 dense-attention 基线,且无需额外训练即可从 2 玩家泛化到 4 玩家 批判点评:「用正单纯形顶点的旋转相位编码 agent 身份」是极优雅的无参设计——天然排列对称又可扩展;Sparse Hub Attention 把多 agent 注意力线性化是务实工程;从 2 人零样本泛化到 4 人很有说服力。但 hub token 数量与 agent 数的可扩展上限、长时序多 agent 一致性的退化曲线需要更大规模验证 4. AdaState:流式视频生成自演化锚点 AdaState: Self-Evolving Anchors for Streaming Video Generation | 弗吉尼亚理工 Virginia Tech | arXiv:2605.30349 关键词:流式视频生成·自回归扩散·自演化锚点·KV cache·时间相对 前序问题:自回归视频扩散逐块生成、每块条件于已生成内容,但模型结构性地「锚定在第一帧」:首帧 KV 占据注意力 cache 的特权位置、作为整段主场景参考。作为最干净无误差的位置,这个锚点吸走过多注意力,压制视频动态、把场景构图锁死在初始视角,结果是「时间上很浅」的视频——运动、镜头、场景推进都被静态一致性压制 本文贡献:用「自适应 state」替换静态锚点——一个隐 latent,模型每块和内容一起去噪但从不渲染。模型不再参考冻结的首帧,而是每步通过同时关注「前一 state + 当前内容」自己生成场景锚点,产出随生成内容演化的参考。不同于编码绝对时间的标准视频生成,本方法把时间当相对量:每个生成步看到相同的位置结构、state transition 每块都相同。这给生成过程引入了递归——去噪即 transition 函数,KV cache 即载体,无需任何外部模块 实验效果:实验表明自适应 state 大幅改善视频动态,让生成视频内出现更丰富的运动和更自然的场景推进 批判点评:「首帧 KV 锚点偷走注意力 → 视频时间上变浅」的诊断非常精准,用「可去噪但不渲染的隐 state」做自演化锚点是优雅的零外部模块方案,把时间从绝对改成相对的视角很有启发。但「丰富运动」与「时序一致性」本就是 trade-off,自演化锚点会不会牺牲长程一致性需要定量;缺与显式 memory / anchor 方法的正面对比 5. YoCausal:视频生成因果性认知基准 YoCausal: How Far is Video Generation from World Model? A Causality Perspective | 上海 AI Lab, 阳明交大 NYCU | arXiv:2605.30346 关键词:视频生成·世界模型·因果性·评测基准·上海AILab 前序问题:视频扩散模型(VDM)正走向世界模型,关键问题是:它们真懂因果,还是只过拟合统计时序模式?现有基准大多依赖合成数据,受 sim-to-real gap 限制真实世界泛化 本文贡献:YoCausal:受认知科学「违反预期(VoE)」范式启发的两级基准。零成本地把真实世界视频时序反转,作为天然反事实样本,建立可任意扩展的评测协议。Level 1 提出 Reverse Surprise Index (RSI),用去噪 loss 量化「时间箭头」感知;Level 2 提出 Causality Cognition Index (CCI),用 VLM 把数据分层成因果 / 非因果子集,把真正的因果推理从时序偏置中解耦 实验效果:评测 13 个 SOTA VDM 发现:感知到时间箭头并不意味着理解因果,且相对人类级因果认知仍存在显著差距 批判点评:「时序反转真实视频做零成本反事实」是极聪明的基准构造,RSI / CCI 两级指标把「时间感知」与「因果认知」分层解耦的思路很清晰,给「视频生成→世界模型」泼了必要的冷水。但用去噪 loss 衡量「惊讶度」是否完全等价于因果理解仍可争议;VLM 分层本身的可靠性会传导到 CCI 的结论 6. GenClaw:代码驱动的智能体图像生成 GenClaw: Code-Driven Agentic Image Generation | 中山大学 | arXiv:2605.30248 关键词:图像生成·智能体·代码驱动·可控生成·中山大学 前序问题:图像生成已从「文本条件像素合成」走向「具备视觉理解 + 工具调用的多模态 agent」,但现有 agent 仍受制于底层黑盒图像模型——工作流困在「为优化生成反复改 prompt」的循环里,没有直接操控画布的机制。LLM 作为精确视觉构建「画笔」的潜力基本未被开发 本文贡献:GenClaw:代码驱动的智能体图像生成范式,让 agent 像人类艺术家一样创作——先构思、再起草、最后上色。agent 先通过搜索和推理构建概念知识与上下文;再用代码(SVG / HTML / Three.js)渲染可执行的视觉草图;最后用图像生成模型补充纹理、材质、真实感。代码在此作为可控的中间画布,桥接语言推理与像素合成,把程序逻辑与生成模型的视觉表现力无缝整合 实验效果:把图像生成从黑盒范式转成类似真实人类创作的分阶段过程,朝着高度可控、可解释的视觉生成系统迈出一步 批判点评:「代码作中间画布」是把可控性问题转译成「可执行草图」的聪明思路——SVG / HTML / Three.js 草图天然结构化、可精确编辑,比反复改 prompt 强太多;构思-起草-上色的拟人流程也很有叙事性。但代码草图能表达的视觉复杂度有上限(精细写实场景难用 SVG 起草),最终仍依赖底层生成模型的「上色」能力;端到端延迟和失败率需要量化 7. GPIC:28万亿像素许可级图像语料 GPIC: A Giant Permissive Image Corpus for Visual Generation | 斯坦福 李飞飞团队 | arXiv:2605.30341 关键词:图像语料·视觉生成·许可数据集·flow matching·斯坦福 前序问题:研究可扩展的视觉生成方法需要大、可获取、稳定的数据集,但开放且许可清晰的大规模图像语料长期稀缺 本文贡献:GPIC:约 28 万亿像素的巨型许可图像语料。由 SOTA 视觉语言模型为多样互联网图像生成 caption,含 1 亿训练 + 20 万验证 + 100 万测试样本。所有图像均「研究 + 商用」许可宽松,经安全过滤、去重,集中托管于 Hugging Face。提供生成建模的 benchmark 协议,并给出像素空间 flow matching 的参考 baseline 实验效果:数据集、benchmark、模型全部开放(stanford-vision-lab/gpic);为视觉生成提供「大规模 + 许可清晰 + 稳定可复现」的公共底座 批判点评:「许可宽松 + 商用可用 + 安全去重 + 集中托管」直击当前生成数据集的版权 / 可复现痛点——这种基础设施工作对整个社区的长尾价值很高,28 万亿像素 + 完整 benchmark + baseline 让它即插即用。但「VLM 自动 caption」的质量上限会限制可训出的文本对齐能力;与 LAION 类已有大语料的去重重叠和质量差异需要更透明 8. Parametric Memory Law:LoRA参数记忆的幂律定律 How LoRA Remembers? A Parametric Memory Law for LLM Finetuning | 浙江大学, 阿里 | arXiv:2605.30260 关键词:LoRA·参数记忆·幂律·LLM微调·浙大 前序问题:LLM 需持续学习更新知识,LoRA 被广泛用于记忆更新,但现有研究多靠定性下游评测,对「精确参数记忆」的定量容量极限和底层动力学几乎没探索 本文贡献:用 LoRA 作为受控的记忆容量探针,在 latent 空间系统量化精确参数记忆。提出 Parametric Memory Law:把 loss 下降 ΔL 与有效参数量、序列长度联系起来的稳健幂律。token 级细粒度分析揭示确定性相变——证明预测概率 p>0.5 是 greedy decoding 下逐字召回的充分条件。据此提出 MemFT:阈值引导的优化策略,把训练预算动态重分配到次阈值 token 实验效果:实证表明 MemFT 能提升记忆保真度和效率;为「LoRA 到底记住多少、怎么记」给出可量化的定律而非定性结论 (github.com/zjunlp/ParametricMemoryLaw) 批判点评:「用 LoRA 当记忆容量探针 + 找出幂律 + p>0.5 相变的充分条件」是把模糊的「记忆能力」做成可量化科学定律的扎实工作,MemFT 把定律反哺成实际训练策略形成漂亮闭环。但幂律的普适性需要跨更多模型规模 / 任务验证;「逐字召回」的记忆与「泛化知识」的记忆是两回事,定律对后者的适用边界要谨慎 趋势观察 视频生成正在「世界模型化」:从出片段走向实时交互、多智能体、可因果 — minWM 把双向 T2V/TI2V 蒸成相机可控的少步自回归世界模型并全栈开源;Gamma-World 用单纯形旋转编码 + 稀疏 hub 注意力把世界模型从单 agent 扩到多 agent(2→4 人零样本泛化、24FPS);YoCausal 用时序反转真实视频做反事实基准,量出 13 个 SOTA VDM 距离「真懂因果」仍有显著差距——视频生成的下一站从「画面好」转向「能交互、有因果、多主体」 自回归流式视频生成开始解决「时间太浅」的结构病 — AdaState 诊断出首帧 KV 锚点偷走注意力、把场景锁死在初始视角,改用「可去噪但不渲染的自演化隐 state」做相对时间锚点,显著改善运动和场景推进——流式视频生成从「保一致」转向「敢动起来」 音视频联合生成走向「先对齐后融合」的原生范式 — NAVA 指出双塔后验对齐弱化协同、三模态全统一耦合语义与同步两条路都有缺陷,提出 Align-then-Fuse MMDiT 先在交互空间建音视频对应、再 context 条件化联合去噪,6.3B 拿下多项 SOTA + 可控音色——音视频生成的架构共识正在形成 图像生成的可控性升级:代码做中间画布、许可数据做底座 — GenClaw 用 SVG/HTML/Three.js 可执行草图作中间画布,把「反复改 prompt」换成「构思-起草-上色」的拟人可控流程;GPIC 放出 28 万亿像素、研究+商用许可宽松、安全去重的图像语料 + benchmark + flow matching baseline——可控生成的「方法」和「数据底座」被同时推进 大模型记忆与微调走向「可量化定律」 — How LoRA Remembers 用 LoRA 当记忆探针,给出 loss 下降 ΔL 与有效参数 / 序列长度的 Parametric Memory Law,发现 p>0.5 是逐字召回的充分条件,并据此提出阈值引导的 MemFT——把「LoRA 记多少」从定性评测推到可解析的幂律 人工智能炼丹君 整理 | 2026-05-29 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-28|北大OSP-Next视频生成跨硬件加速 今日 AIGC 论文速览 今日共 11 篇 · 视频生成全栈加速 4 篇 · 视频生成新能力 2 篇 · 音频统一生成 2 篇 · 语音合成与编辑 2 篇 · 扩散模型对齐 1 篇 重点论文标题列表 OSP-Next:稀疏+量化+RL全栈视频生成1.64x PARE:视频DiT结构剪枝+动态路由 ⚡ Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Dasheng AudioGen:首个文生混合音频场景统一模型 今日论文速览 1. OSP-Next:稀疏+量化+RL全栈视频生成1.64x OSP-Next: Efficient High-Quality Video Generation with Sparse Sequence Parallelism, HiF8 Quantization, and Reinforcement Learning | 北大袁粒组, 华为 | arXiv:2605.28691 关键词:视频生成·稀疏注意力·序列并行·HiF8·北大袁粒组 ⚠️ 前序问题:Diffusion Transformer 在视频生成上已经能出好东西,但 full attention 二次开销死死压住效率。前人方案各做一段(稀疏 / 量化 / 蒸馏),缺一套能同时打通通信、计算、精度的端到端方案——尤其在「多卡序列并行」上和「跨国产硬件」上 本文贡献:OSP-Next:把稀疏注意力 + 序列并行 + 量化 + RL 后训练全栈打通的高效 T2V 框架。Skiparse-2D Attention 在空间维做 token-wise + group-wise 稀疏并保留 FlashAttention 兼容;提出 Sparse Sequence Parallelism (SSP) 用一次 All-to-All 切换稀疏模式,相比 Ulysses SP 通信量降低 75%;HiF8 量化支持 8-bit 联合训练 + 稀疏 fine-tune;Mix-GRPO 后训练弥补稀疏模型的质量回退 实验效果:VBench 总分 83.73% 超越 Wan2.1 基线;5 秒 720P/768P 设置下,H200 单 GPU 加速 1.64×,8 GPU 加速 1.52×;OSP-Next-HiF8 仅掉 0.4% 分数即可在国产昇腾 Ascend 950PR 上拿到 1.69× 和 2.27× 加速——是少见的同时验证国际/国产硬件的视频生成加速方案 批判点评:「稀疏注意力 + 序列并行 + 量化 + RL」四件套全栈打通,每一件单独不算新,但 SSP 把通信量直接打掉 75% 是非常硬的工程数字;跨 H200 + 昇腾的双硬件验证为国产硬件视频生成提供了稀缺的实证。但 Skiparse-2D 是 fixed pattern,对极复杂运动场景的可适配性需要看;Mix-GRPO 与 SSP 联训的稳定性细节披露还可以更多 2. PARE:视频DiT结构剪枝+动态路由 PARE: Pruning and Adaptive Routing for Efficient Video Generation | 港中文 CUHK, 上海 AI Lab, 悉尼大学 | arXiv:2605.27336 关键词:视频 DiT·结构剪枝·动态路由·Wan2.1-14B·上海 AI Lab ⚠️ 前序问题:Video DiT 又宽(block 宽)又深(架构深)又要多步采样,部署成本极高。前人通过压宽/压深/压步数减成本,但都 commit 到固定架构——不能针对单个输入或不同去噪阶段动态调整 本文贡献:PARE:把宽度剪枝和深度自适应路由联合做。宽度上观察到 attention head 自然分化为空间 vs 时序角色,设计区分两类的 importance scoring 避免「运动关键的 temporal head」被过早剪掉;深度上训轻量 router 以 denoising timestep + 视觉内容为条件,动态选择每步执行哪些 block——实现「按输入动态计算」而非静态删除。两阶段 progressive pipeline 先用蒸馏修复宽度剪枝的质量损失,再联合优化 student + router 解耦学习目标 实验效果:在 Wan2.1-14B 上对 I2V 和 T2V 都大幅降低每步算力且保住 VBench 各维度质量;与 step 蒸馏天然可组合进一步加速——把「静态剪枝」时代翻篇成「动态路由按需算」 批判点评:「区分空间/时序 head 重要性 + denoising-step 条件的 block router」两个洞察都直击 Video DiT 的结构性冗余。动态路由实现「按输入按 timestep 算」是 efficient video gen 的下一阶段方向。但 router 本身的训练稳定性、推理时的额外 overhead、以及与 OSP-Next 类静态稀疏组合后的边际收益需要更细 ablation 3. Quantized Keys Steal Attention:KV缓存量化的Jensen偏差校正 Quantized Keys Steal Attention: Bias Correction for KV-Cache Compression in Video Diffusion | 慕尼黑工大 TUM, Tensordyne | arXiv:2605.26266 关键词:视频扩散·KV cache·INT2 量化·Jensen 偏差·长视频 ⚠️ 前序问题:chunk-wise 自回归视频扩散依赖前序 chunk 的 KV cache 避免重复计算,但视频越长 cache 越大,量化 KV 到低 bit 又会显著掉画质。掉画质的根因是什么?以前没人说清楚 本文贡献:首次明确指出根因:softmax 注意力中 exp 的凸性让量化噪声系统性放大「被 cache 的 keys」对注意力的贡献——作者命名为 Jensen bias(量化的 keys 会偷走当前 chunk 的注意力质量)。给出 per-attention-score 的解析修正项,在 expectation 上消除该 bias,只用量化 step size 和 query norm 即可在线算;用二阶 Taylor 近似让额外计算开销可忽略、无需额外显存 实验效果:在 MAGI-1 / SkyReels-V2 / HY-WorldPlay 三个长视频模型上 INT2 量化即可恢复大部分掉的质量、接近 BF16;用 50% 更少显存的 INT2 反而能超过 INT4——长视频 KV cache 压缩拿到新的帕累托前沿 批判点评:把「量化掉画质」从经验问题改写成「Jensen 偏差」这一可解析的统计现象是真正的科学贡献——一行公式校正、零额外显存就拿到 INT2 ≈ BF16 的质量。这种「找根因 + 闭式解」的工作含金量高。但局限在 chunk-wise AR 视频扩散,对非 AR 的全局扩散 KV 压缩不直接适用;与 SmoothQuant 等激活/权重路线的组合策略还可探索 4. SVDQuant-GPTQ:W4A4量化Wan2.2-I2V省内存59.3% Timestep-Aware SVDQuant-GPTQ for W4A4 Quantization of Wan2.2-I2V | 华中科技大学 HUST | arXiv:2605.27003 关键词:W4A4 量化·Wan2.2·MoE DiT·SVDQuant·华中科大 ⚠️ 前序问题:把大型视频 DiT 推到 W4A4 量化可以省一大块显存,但两道坎卡死:(1) 稀疏的「大幅激活 outlier」;(2) 不同去噪 timestep 的激活分布漂移很大。这两个问题在 Wan2.2-I2V 双专家 MoE DiT(高噪/低噪两个 expert 量化敏感度完全不同)下被进一步放大——单一全局校准策略根本拿不下 本文贡献:Timestep-Aware SVDQuant-GPTQ:(1) SVDQuant-based 低秩 outlier 补偿处理激活大幅 outlier;(2) GPTQ 重建感知残差权重量化;(3) timestep-bin-wise 逐层激活 clipping-ratio 搜索,对每个 MoE expert 独立完成。三件套合起来就是「按 expert + 按 timestep」精细化校准的 PTQ 框架 实验效果:在 OpenS2V-Eval 上相对 BF16 把峰值 GPU 内存降 59.3%,VBench 平均分仅掉 0.9%,Imaging Quality 仅掉 2.3%——证明「expert + timestep 双感知校准」是 MoE 视频 DiT 量化高保真的必要条件 批判点评:把 MoE DiT 量化从「全局校准」拉到「按 expert + 按 timestep」是正确的颗粒度切分——双专家的量化敏感度本来就不同,强行全局必然掉点。59.3% 内存降 + <1% 质量损是漂亮的工业数字。但 PTQ 路线天然依赖 calibration set 质量,长视频/复杂运动的覆盖度需要追踪;与昨天 RT-Lynx 类激活稀疏的组合潜力值得探索 5. Dasheng AudioGen:首个文生混合音频场景统一模型 Dasheng AudioGen: A Unified Model for Generating Coherent Audio Scenes from Text | 小米, 上海交大 | arXiv:2605.27838 关键词:音频场景生成·multi-view caption·flow matching·小米·DiT ⚠️ 前序问题:音频生成长期被「按域切分」——语音、音乐、音效各有独立模型——做不到从一句描述生成「同时包含人声 + 背景音乐 + 环境音效」的连贯混合音频场景。两大障碍:缺真实混合音频的细粒度监督;声学表示难以同时承载多个并发音频组件 本文贡献:Dasheng AudioGen:首个统一生成混合音频场景的端到端框架。两个核心:(i) structured multi-view captions——把复杂声学场景显式解耦成互补的描述视图,让每个音频层都有细粒度控制;(ii) 高维统一「语义-声学」表示作为共享 latent,注入语义先验加速跨模态训练收敛,同时高维特征空间提供解耦并发声音组件的容量。在此基础上一个简单的 flow-matching DiT 就能跑出端到端高质量音频场景生成 实验效果:在混合音频类别接近真实录音质量,单类型生成(speech/music/SFX)也与专用模型打平——首次把「视觉生成里图文统一」的思路真正落到音频场景上;配套建立音频场景生成的综合评测 pipeline 批判点评:「structured multi-view captions + 高维语义-声学统一 latent」是非常对症的两个设计——把音频域的「描述粒度」和「表示容量」都拉到能容纳混合场景的层次。flow-matching DiT 的工程极简性也很好。但 multi-view caption 的自动构造成本/质量、高维 latent 增加的 DiT 训练开销,以及与商用 ElevenLabs Sound Effect / Stable Audio 2 的端到端对比都需要更细评测 6. HarmoVid:视频肖像重打光和谐化稳定不闪烁 HarmoVid: Relightful Video Portrait Harmonization | Adobe Research, UNC | arXiv:2605.28811 关键词:视频肖像·relight 和谐化·deflicker·alpha mask·Adobe ⚠️ 前序问题:把人物前景视频和谐到目标背景场景(同步阴影、色调、光照强度——relightful harmonization)的硬伤是:视频域没法采集「同一动作不同光照」的成对标注数据。最直接的方案——「按帧调用图像和谐模型」——会带来严重时序抖动(flicker) 本文贡献:HarmoVid 给出整套视频和谐化方案:(i) 全新的 lighting deflickering 模型稳定全局和局部光照 flicker,把「逐帧 image-harmonization」的输出升级成可监督的 paired 视频数据;(ii) 视频扩散模型在 deflickered 真实 + 合成视频上学习;(iii) asymmetric alpha mask conditioning 让模型从真实视频里学到干净的边界 实验效果:在时序连贯、自然度、边界干净度、物理合理光照行为多个维度超越此前所有 image-based 和 video-based 和谐化方法;relighting 表现力也保住——人物视频合成 / 后期合成的标准工业链路被显著升级 批判点评:用「先 deflicker 再训练」绕开「无成对数据」的死结是非常聪明的——deflicker 把单帧图像和谐输出转化成可用监督,是真正的杠杆点。asymmetric alpha mask 也很实用。但 deflicker 模型本身的失败模式(强光/复杂阴影)会传导到下游;与 Adobe 自家的商业级合成工具的真实对比需要更细评测 7. SmartDirector:多关键帧条件电影级视频叙事控制 SmartDirector: Keyframe-Conditioned Cinematic Video Generation with Narrative Pacing Control | 国内视频生成团队 | arXiv:2605.27891 关键词:电影级视频·多关键帧·叙事节奏·两阶段·Director-Gen/SR ⚠️ 前序问题:视频的「叙事质量」决定感知价值,但现有视频生成方法主要靠 text prompt 或首尾帧这类稀疏 condition——对叙事结构和时序节奏的精确控制非常有限,导出不了真正「有 pacing 的电影感视频」 本文贡献:SmartDirector:以多关键帧增强视频生成的叙事能力。支持单镜头、多镜头叙事合成、视频延展三类场景。两阶段:(i) Director-Gen 在低分辨率上以关键帧为条件生成;(ii) Director-SR 利用高分辨率关键帧作为语义锚点把细粒度细节补回来。配套数据管线从电影中精选单镜头/多镜头序列以支撑多关键帧训练 实验效果:在多个评测上大幅超越 SOTA,把视频生成从「按 prompt 出 5 秒片段」升级到「按多关键帧出有节奏的多镜头序列」——电影级视频生成的可控性接近真实创作工作流 批判点评:「多关键帧 + 两阶段先粗后细」直击「电影级叙事控制」的实际痛点——单 prompt / 首尾帧确实远远不够。两阶段把分辨率 vs 叙事控制解耦是合理设计。但「关键帧」的获取成本(人工/AI辅助)和叙事节奏的可量化评测仍是模糊地带;多镜头切换的时空一致性细节需要更深 ablation 8. LoSATok:1280维语义压缩到128维统一audio LoSATok: Low-dimensional Semantic-Acoustic Tokenizer for Cross-Domain Audio Understanding and Generation | 清华深圳, 面壁智能 | arXiv:2605.27840 关键词:audio tokenizer·128 维·语义瓶颈·清华深圳·面壁 ⚠️ 前序问题:音频 tokenizer 是统一「音频理解」和「音频生成」的根基。理解需要高层语义;生成需要语义 + 声学细节。现有统一 tokenizer 在高维连续 latent 里同时编码——这增加了 DiT 生成端的建模负担 本文贡献:LoSATok:观察到 1280 维语义 encoder 特征是可压缩的,引入 Semantic Bottleneck 压到 128 维,并用 time-relation loss 保时序特征一致性;再用「双层级语义监督」同时利用高维/低维语义信号——让 tokenizer 在紧凑 latent 空间里同时承载语义和声学细节 实验效果:在 speech / music / 通用 audio 上 SemBo 保住强低维语义容量,LoSATok 与多个语义表示比较 understanding 性能仍有竞争力;在 DiT 端的 speech / music / audio 生成上一致改进——证明「低维 audio 表示也能同时支撑理解与生成」 批判点评:把「audio 统一 tokenizer」的维度从 1280 砍到 128 是非常硬的容量压缩——若真的不掉理解还能提升生成,那就解掉了「audio 统一表示卡 DiT」的关键梗。time-relation loss + 双层级语义监督是合理工程。但 128 维下声学细节的极限(音乐复杂混音、长 reverb)需要更细测试;与 Dasheng AudioGen 高维路线的端到端比较是行业级议题 9. CosyEdit2:GRPO语音编辑反哺零样本TTS CosyEdit2: Speech-Editing-Oriented Reinforcement Learning Unlocks Better Zero-Shot TTS | 南开大学 | arXiv:2605.25930 关键词:语音编辑·GRPO·zero-shot TTS·南开大学·post-training ⚠️ 前序问题:语音编辑和 zero-shot TTS 同源于「prompt 驱动的语音生成」,但语音编辑对「与周围未编辑内容的局部声学一致性」要求严苛得多。SFT 让 TTS 模型获得编辑能力的路线被卡在「成对编辑数据不完美 + 优化信号粗粒度」 本文贡献:CosyEdit2:建立「先 SFT 初始化 → 再 editing-oriented GRPO 后训练」的两阶段框架。GRPO 阶段在「无目标语音」的数据上做,把语音编辑当作 RL 任务优化,让模型从粗粒度匹配走向精细局部声学一致 实验效果:不仅在语音编辑上显著提升,还反哺 zero-shot TTS 能力——揭示「编辑任务 ↔ 合成任务」之间隐藏的相互增益;GRPO 在 audio 域被验证是有效的 post-training 范式 批判点评:把 GRPO 引入 audio 域、并用「编辑反哺合成」这个新角度证明两个任务的深层互助,是非常聪明的科学故事。无目标语音的 RL 设计也比依赖成对数据更可扩展。但 GRPO 的 reward 设计细节、跨语种/多说话人鲁棒性、以及对 prosody 细节的影响需要更系统评测 10. PilotTTS:高德200K小时开源TTS竞品级 PilotTTS: A Disciplined Modular Recipe for Competitive Speech Synthesis | 高德 AMAP | arXiv:2605.27258 关键词:TTS·200K 小时·开源·Q-Former·高德 AMAP ⚠️ 前序问题:SOTA TTS 系统通常需要数百万小时专有数据 + 多阶段复杂架构——这对资源受限的研究团队是几乎跨不过去的门槛。开源社区想自己训出竞品级 TTS 一直缺成熟 recipe 本文贡献:PilotTTS:高德 AMAP 用「最小化架构 + 严格数据工程」做出竞品级轻量自回归 TTS。仅用 200K 小时数据 + 全开源工具处理。两大贡献:(i) 可复现的多阶段数据处理 pipeline(质量评估 + 标签标注 + 过滤);(ii) Q-Former conditioning 紧凑模型架构,通过 cross-sample paired training 解耦说话人身份与说话风格。统一框架支持 zero-shot voice cloning / 11 类情感合成 / 4 类副语言合成 / 14 种中文方言 实验效果:在 Seed-TTS Eval 上 test-en WER 1.50%(最低)、test-zh CER 0.87%;两个测试集说话人相似度都最高(0.862 / 0.815)——超越使用大得多数据集训出来的系统。完整 data pipeline + 预训练权重 + 代码全开源 (AMAPVOICE/PilotTTS) 批判点评:「200K 小时 + 开源工具 + 极简架构」做出超越百万小时专有数据系统的 TTS——是非常有信号量的开源胜利,对中小团队意义重大。Q-Former 解耦说话人/风格的设计也是 clean。但 PilotTTS 主打数据工程而非架构创新,复现门槛仍在「数据处理 pipeline 的工程细节」;与昨天 LongCat-Avatar 类「audio + 视频联合」的下一步集成是开放问题 11. LAIR:扩散模型从成对偏好升级到列表对齐 Beyond Pairwise Preferences: Listwise Reward-Aware Alignment for Diffusion Models | 斯坦福, 加州理工 Caltech | arXiv:2605.26491 关键词:diffusion 对齐·listwise preference·advantage-weighted·Stanford·Ermon ⚠️ 前序问题:preference optimization 已成 RLHF 之外对齐 T2I 扩散的高效替代,但现有方法基本都把监督降到 binary pairwise——这在「同 prompt 有多张候选 + 有连续 reward 分数」时严重浪费信息(一个 winner-loser 标签远远没用上 reward 分布) 本文贡献:Diffusion LAIR:reward-aware listwise preference optimization。每个 prompt 把候选组的 reward 分数转成中心化 advantage 权重,再优化「advantage-weighted regression」目标——目标定义在 implicit reward(当前模型 vs 固定参考模型的 denoising-loss 改进量)上,配二次惩罚正则隐式 reward 幅度。结果是同时用所有候选而非选 pair,并保持保守。LAIR 目标在 implicit-reward 空间有 bounded closed-form 最优解,把正则强度 → 偏好更新幅度的关系写清楚 实验效果:在 SD1.5 / SDXL 上对 T2I 生成 / 组合生成 / 图像编辑 benchmark 都超越 strong pairwise preference optimization baseline;为 diffusion 对齐提供「更接近 RLHF reward 信息密度但不需在线 RL」的中间路线 批判点评:把 DPO 类 pairwise 升级到 listwise + 给出 closed-form 最优解的清晰表述是教科书级的方法工作——既保留 offline 偏好优化的稳定性,又用上了 reward score 的全部信息。但 listwise 数据采集成本高于 pairwise(要 N 张同 prompt 候选 + reward 分),实际落地的数据可得性是隐藏成本;与 in-context 在线 RL(GRPO 类)的端到端比较略浅 趋势观察 视频生成进入「全栈加速」时代:稀疏 + 量化 + 并行 + 路由 + RL 多管齐下 — OSP-Next 把稀疏注意力 + Sparse Sequence Parallelism(通信 -75%)+ HiF8 量化 + Mix-GRPO 一锅端,跨 H200 / 昇腾双硬件分别 1.64× / 2.27× 加速;PARE 联合宽度剪枝 + 动态深度路由,在 Wan2.1-14B 上按输入按 timestep 动态算;SVDQuant-GPTQ 把 Wan2.2 双专家 MoE DiT 推到 W4A4 显存降 59.3%——视频生成的工业部署正在被「全栈加速」改写 长视频 KV cache 压缩出现「找根因 + 闭式解」类突破 — Quantized Keys Steal Attention 首次把「量化 KV 掉画质」从经验现象写成 Jensen bias(exp 凸性放大 cache key 贡献)的可解析统计现象,一行公式校正零额外显存,让 MAGI-1 / SkyReels-V2 / HY-WorldPlay 在 INT2 上接近 BF16——把 chunk-wise AR 长视频的 KV 压缩从「玄学调参」推到「有理论的工程」 音频生成统一化:从「按域切分」走向「一句描述出混合场景」 — Dasheng AudioGen 是首个能从一句描述同时生成 speech + music + SFX 混合连贯场景的统一模型,关键是 structured multi-view captions + 高维语义-声学统一 latent;LoSATok 反过来把 1280 维语义压到 128 维统一 tokenizer 反哺 DiT 生成;CosyEdit2 在 audio 域用 GRPO 把「编辑」反哺「TTS」——audio 正在重走视觉「统一模型」的同一条路 视频生成的「叙事控制」与「视频后期」继续拓宽到工业链路 — SmartDirector 把视频生成从「按 prompt 出 5 秒片段」升级到「多关键帧 + 两阶段先粗后细」做电影级叙事节奏控制;HarmoVid 用 deflicker 模型破解「视频和谐化无成对数据」的死结,把视频肖像 relight 和谐化做到工业级稳定——视频生成的可控性从「内容」深入到「节奏」和「后期合成」 开源 TTS / 对齐方法补齐 audio + diffusion 的「最后一公里」 — 高德 PilotTTS 用 200K 小时 + 开源工具 + Q-Former 极简架构做出超越百万小时专有系统的开源 TTS(Seed-TTS Eval 第一);Diffusion LAIR 把 T2I 对齐从 pairwise 升级到 listwise,给出 implicit-reward 的 closed-form 最优解——开源社区在 audio 合成 + diffusion 对齐这两个长期被闭源霸占的方向同时迈出了「竞品级 + 理论级」的双台阶 人工智能炼丹君 整理 | 2026-05-28 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-26|百度ERNIE-Image开源8B DiT追平闭源 今日 AIGC 论文速览 今日共 11 篇 · 国产开源文生图基础模型 1 篇 · 音视频联合生成与编辑 3 篇 · 视频生成训练范式革新 2 篇 · few-step 蒸馏与自回归视频蒸馏 2 篇 · 推理时自适应与视频编辑 3 篇 重点论文标题列表 ERNIE-Image:百度8B DiT开源逼近闭源SOTA Baton:首引语义蓝图驱动音视频联合生成 ⚡ SpongeBob:首个端到端音视频联合编辑Sync+30% StreamChar:长时流式角色音视频实时生成 PixelWizard:原生2K/4K视频生成10倍加速 今日论文速览 1. ERNIE-Image:百度8B DiT开源逼近闭源SOTA ERNIE-Image Technical Report | 百度 Baidu ERNIE Team | arXiv:2605.25347 关键词:ERNIE-Image·百度·8B DiT·MT-DMD 蒸馏·industrial-grade ⚠️ 前序问题:开源文生图模型与闭源顶级系统在指令跟随、文字渲染、美学质量上仍有明显差距。差距主要来自两件事:预训练数据噪声大且长尾概念覆盖差;后训练人类偏好对齐的稳定性不足,蒸馏期间还会出现 capability drift(蒸馏前能做的事,蒸馏后做不到了) 本文贡献:ERNIE-Image:8B 单流 DiT 架构开源文生图基础模型。预训练用 bottom-up 数据管线(细粒度分类 + 富 caption + 美学评估 + 分层采样)压噪同时保长尾;后训练 top-down 高需求场景 + 多样化 prompt + 稳定化 DPO;ERNIE-Image-Turbo 实现 8-NFE 高效生成,配套 MT-DMD 蒸馏算法缓解 capability drift。配套发布 industrial-grade ERNIE-Image-Aes 美学模型和 ERNIE-Image-Aes-1K benchmark(首个针对真实场景的美学评测基准) 实验效果:开源模型中达到 leading 表现,在指令跟随/文字渲染/美学三项接近顶级闭源商业模型;模型权重和美学评测资源全部开源,覆盖完整工业流水线(包括 Prompt Enhancer 把简短意图扩展为结构化视觉描述) 批判点评:「8B DiT + bottom-up 预训练 + top-down 后训练 + 稳定 DPO + Turbo 蒸馏」是教科书级的工业开源大模型训法,单独哪一项都不算新颖,但全部端到端打通、配套基础设施 + 评测开源是最大贡献。但闭源 SOTA(GPT-Image / Imagen 4 / Midjourney v7)的差距具体几何缺乏精确量化对比,且 industrial-grade aesthetic model 的偏好可能强烈反映中文用户审美,国际场景适用性需观察 2. Baton:首引语义蓝图驱动音视频联合生成 Baton: Explicit Semantic Blueprints for Joint Video-Audio Generation | 复旦大学, 腾讯混元 | arXiv:2605.25195 关键词:音视频联合生成·explicit planning·VA-Planner·腾讯混元·Relative RoPE ⚠️ 前序问题:开源扩散模型做音视频联合生成时,两个模态的去噪轨迹各自为政,导致音画不同步、长时一致性差。根因:现有方法用现成 encoder 的粗粒度 text embedding 引导音/视频去噪——这丢掉了细粒度语义,更关键的是缺少一个跨模态的「长 horizon 共享规划」 本文贡献:提出 Baton:首个引入 explicit semantic planning 的音视频联合生成框架。VA-Planner(带双语义对齐塔的多模态 LLM)让可学习 query 同时 cross-attend 视频和音频特征,吐出一对语义对齐的音/视频 planned token(关键帧级蓝图);这些 plan token 通过 cross-attention 注入扩散 backbone,与粗 text embedding 互补;进一步提出 Relative Semantic RoPE 把 planned token 和 latent 映射到共享时空坐标系,让 latent 准确 attend 到对应语义线索 实验效果:在标准音视频联合生成 benchmark 上定性定量都显著超过基线;首次把「先规划后渲染」的范式从单模态扩散扩展到跨模态联合扩散——和昨天 Bernini「MLLM 规划 + DiT 渲染」是同向延续 批判点评:「explicit semantic planning」做跨模态联合生成是非常对的方向——粗 text embedding 当指挥棒本来就太宽松。VA-Planner + Relative Semantic RoPE 解决了「plan 怎么对齐 latent」的工程关键。但 VA-Planner 多了一次 MLLM 推理,端到端时延和显存对比单 DiT 联合扩散需要进一步说明;planned token 颗粒度是 keyframe-level 而非 frame-level,复杂动作对齐上限仍受限 3. SpongeBob:首个端到端音视频联合编辑Sync+30% SpongeBob: Sync-Aware Harmonious Audio-Visual Generative Editing | 中科大 USTC | arXiv:2605.25193 关键词:音视频联合编辑·端到端·Sync-Aware·Context-Aware·USTC ⚠️ 前序问题:物理世界的视觉和声音本就耦合,但现有视频编辑全部是「视觉编完,再单独配音/换音」的解耦 pipeline,没有双向模态交互。结果是:(i) 音画不同步;(ii) 改动后的画面和保留下来的原音之间出现语义冲突(看到打字键盘却继续是说话声) 本文贡献:SpongeBob:首个端到端音视频联合编辑框架,带双向 cross-modal 交互。Sync-Aware Mechanism 通过双向注意力 + 时序对齐 + 空间约束让视觉编辑跟声音事件对齐;Context-Aware Module 用声/像 context attention 防止编辑后语义冲突;Sync-Preserving Training and Guidance(SPTG)在保持画质的同时强化对齐。配套构建可扩展数据管线 + subject-level 大规模数据集 + SpongeBob-Bench 评测 实验效果:Sync-C(音画同步指标)+30%、Ctx-F1(上下文一致性)+12.5%,显著超越现有 baseline;首次把「音视频编辑」推到 explicit joint 范式,让「改了画也改对应音」成为可能 批判点评:把音视频编辑从「解耦串行」改成「联合并行」是必要的下一步,Sync-Aware + Context-Aware 双模块设计简洁;但训练数据规模和评测集都依赖作者自建,第三方复现成本高;编辑场景的覆盖(替换/插入/删除)和真实创作工作流的对接深度还需后续验证 4. StreamChar:长时流式角色音视频实时生成 StreamChar: Long-Horizon Streaming Character Audio-Video Generation with Decoupled Orchestration | 阿里通义实验室 | arXiv:2605.25659 关键词:流式生成·角色动画·decoupled orchestration·阿里通义·sink-chunk memory ⚠️ 前序问题:实时流式的角色音视频联合生成要同时满足:(1) 说出指定 transcript;(2) 跨 chunk 保持视觉身份;(3) 严格的播放预算(低延迟)。三个目标相互掣肘——逐 chunk 的自回归生成会累积 transcript-audio 错位和视觉漂移;为低延迟而做的 few-step 蒸馏又会牺牲空间多样性和时序质量 本文贡献:StreamChar:把「长 horizon 规划」与「短窗音视频去噪」解耦的流式框架。LLM 编排器(orchestrator)用 transcript 和历史上下文产出帧对齐的音频条件;joint audio-video DiT 做局部双向去噪并带 reference + motion-frame conditioning;两阶段蒸馏先压缩 sampler 再用 online chunk rollout 微调 student;progress-aware pointer 在 rollout 训练时把部分 transcript 与生成音频对齐;sink-chunk memory 提供持久视觉 anchor 缓解长 horizon 漂移 实验效果:把流式 character animation 这个被低延迟严重压制的方向推到「长 horizon + 严格时延 + 身份稳定」可同时满足;解耦式架构让 LLM 做规划、扩散 backbone 做细节生成成为长视频流式生成的可行新范式 批判点评:把「orchestrator vs denoiser」解耦解决了流式 + 长时生成两难,sink-chunk memory + progress pointer 是非常针对性的工程设计。但 LLM orchestrator 引入额外推理路径,对端到端时延的真实贡献需要更细评测;joint audio-video DiT 蒸馏后的 student 与教师模型 audio-visual coherence 的差距上限值得跟踪 5. PixelWizard:原生2K/4K视频生成10倍加速 PixelWizard: Towards Efficient High-Fidelity Video Generation at Ultra-Large Spatial Resolution | 港科大广州, 小米 | arXiv:2605.25801 关键词:高分辨率视频·原生 2K/4K·10× 加速·分层 anchor·小米 ⚠️ 前序问题:高分辨率视频生成有两个相互耦合的瓶颈:(1) token 序列爆炸让优化偏向局部纹理而牺牲全局连贯(结构坍塌);(2) 训练成本巨大、推理延迟严重。简单堆分辨率根本不可持续 本文贡献:PixelWizard 把全局结构建模和细粒度细节合成分层解耦:先建立一个紧凑的时空 anchor 浓缩稠密结构先验,再以此引导高分辨率细节生成,缓解局部优化偏置;引入 Noise-Span Aligned Shortcut Training 让模型可以「大步」遍历生成轨迹(突破推理瓶颈);Exponential Index-Biased Sampling + Adaptive Noise-Span Calibration 把优化与高分辨率网格的偏移噪声 schedule 对齐,实现 robust few-step 推理且无需蒸馏的开销 实验效果:原生 2K/4K 视频生成加速 >10×,同时保证视觉质量;不依赖蒸馏(避免 capability drift),是高分辨率视频生成的「全栈式」效率优化方案 批判点评:分层 anchor + shortcut training 思路很正——直接面对「token 爆炸」根因。10× 加速 + 不蒸馏的组合非常吸引人;但与最新蒸馏路线(如 DMD2/Causal Distill)的端到端对比缺失,结构 anchor 是否能跨场景(人物运动/复杂相机)稳定泛化需要更细评测 6. Paris 2.0:首个去中心化预训练视频生成FVD减半 Paris 2.0: A Decentralized Diffusion Model for Video Generation | Bagel Network | arXiv:2605.26064 关键词:去中心化训练·DDM·视频生成预训练·FVD 2×·Bagel ⚠️ 前序问题:训视频生成模型几乎都要 monolithic GPU 大集群,开源社区无法独立完成时序连贯的视频生成预训练。前作 Paris 1.0 证明了图像生成可以分布式训练(去中心化扩散 DDM),但「时序连贯的视频生成」在 decentralized 训练范式下仍是 open problem 本文贡献:Paris 2.0:首个通过去中心化(decentralized)计算完成预训练的视频生成模型。训练 recipe 基于 Paris 1.0 的开源 DDM 扩展到视频领域,关闭了「分布式训视频」最后一块短板。同 compute budget 下与 monolithic 模型在相同数据上对照评估 实验效果:在 low-resolution 文生视频训练上,相同总算力预算下相比 monolithic baseline,FVD 从 561.04 降到 279.01(~2.0× 提升),CLIP 文本-视频相似度与美学分数双双提升。证明 decentralized 训练不仅可行而且能反超 monolithic——开源社区独立训视频基础模型门槛被显著拉低 批判点评:「分布式 GPU 也能训视频生成」是范式级的工程突破——把视频生成预训练的算力门槛从「必须有大集群」拉到「能聚起多组消费级 GPU」。同算力预算下反超 monolithic 是惊喜数字。但还停留在 low-resolution 段位,高分辨率长视频下分布式通信开销是否仍能 hold 住,是后续最大悬念 7. RTDMD:4步生成同时蒸馏对齐刷新SOTA Reinforcing Few-step Generators via Reward-Tilted Distribution Matching | Sea AI Lab, 港科大 | arXiv:2605.26108 关键词:few-step 扩散·蒸馏·RLHF·GRPO·FLUX.2 ⚠️ 前序问题:few-step 扩散蒸馏已能让图像生成又快又好,但和人类偏好对齐还是难——直接套 RLHF 会破坏蒸馏后的分布稳定性,难以兼得「步数少 + 画质高 + 对齐人类偏好」 本文贡献:RTDMD(Reward-Tilted Distribution Matching Distillation):两阶段统一蒸馏与 RL 对齐。理论上证明 minimizing KL 到「reward-tilted teacher」自然分解为分布匹配 + reward maximization 两项。Stage1:AC-DMD(Ambient-Consistent DMD)做子区间分布匹配 + consistency 正则化,让 fake score 模型追上漂移的 generator;Stage2:混合 policy gradient——GRPO-style estimator 处理随机中间步 + direct reward backprop 处理确定性 final step;进一步用 step-subset GRPO(SubGRPO)降方差 实验效果:在 SD3 / SD3.5 / FLUX.2 上仅 4 步推理就刷新 preference / aesthetic / compositional 三类指标 SOTA,超越此前所有 few-step 文生图方法,代码模型开源 批判点评:把蒸馏和 RL 对齐写成同一个 KL 优化问题在理论上很优雅,工程实现 AC-DMD + 混合 policy gradient + SubGRPO 三件套也都是合理设计;但 GRPO 在 4 步采样下的方差估计仍可能高,跨更多底模(SD3.5 / FLUX 之外)的稳定性需要更多验证 8. AFD:on-policy黑盒蒸馏自回归视频 On-Policy Adversarial Flow Distillation for Autoregressive Video Generation | 新加坡国立大学 NUS | arXiv:2605.26105 关键词:自回归视频·黑盒蒸馏·on-policy·flow-matching·Bradley-Terry ⚠️ 前序问题:自回归视频生成器对流式、长 horizon、交互应用非常有吸引力,但把强黑盒 teacher 蒸馏成 causal student 极其困难:student 必须在自己 rollout 分布下学习,而实际 teacher 通常只暴露 prompt-conditioned 完成的视频,结构/容量/时序设计/采样 schedule 都不同。这让 SFT 是 off-policy 的、score-based 蒸馏不适用、直接对抗模仿对去噪步级 credit assignment 又太稀疏 本文贡献:AFD(Adversarial Flow Distillation):异构黑盒视频蒸馏的 on-policy 框架。同 prompt 同时 query teacher 和 rollout 当前 student;训 prompt-paired Bradley-Terry discriminator 估计 clean-sample 教师-学生差异;把 on-policy advantage 转成 forward-process flow-matching 更新到 student 自己的 noised state 上。这套设计让 student 拿到稠密 velocity-field 监督,且无需 teacher score / latent / 去噪轨迹 / step alignment / reverse-chain RL 实验效果:把「自回归视频生成 + 黑盒强 teacher」蒸馏从死局拉到可行——这恰是流式视频 + 大闭源 teacher 时代的最关键工程问题。on-policy 学习避免分布漂移,flow-matching 转换提供稠密信号,是 RTDMD 在「自回归视频」侧的对偶贡献 批判点评:把「黑盒、异构、自回归视频」三个最难维度同时解决,思路非常对——on-policy + 对抗 + flow-matching 转换是当前最合理的组合。但 Bradley-Terry discriminator 在视频域的样本效率与训练稳定性、以及面对真正巨大闭源 teacher(如商用 Sora / Veo 级别)的 query 成本,是工程落地的真实门槛 9. TT-SAC:talking-head推理时自适应免训练 Test-Time Self-Adaptive Conditioning for Stable Audio-Driven Talking-Head Generation | 格里菲斯大学 Griffith | arXiv:2605.25488 关键词:talking-head·推理时自适应·免训练·feedback loop·身份保持 ⚠️ 前序问题:音频驱动 talking-head(AniTalker / FLOAT / Sonic 等)当前主流是:一张静态参考图条件整段视频生成。但静态身份条件 vs 动态面部运动天然错配,导致 identity drift、时序不一致、感知质量下降 本文贡献:TT-SAC(Test-Time Self-Adaptive Conditioning):完全 parameter-free 的推理时框架,让预训练 talking-head 模型在生成过程中自适应调整 conditioning,不需要重训、不需要梯度、不需要任何额外监督。把 generator 与 encoder 组成 feedback loop:generator 输出再被 encoder 编码,构造与时序动力学对齐的精修 conditioning;单步自适应即近似 self-consistent equilibrium,稳定跨时长的身份与运动 实验效果:把 talking-head 的「静态参考图」假设彻底打破——同一组预训练权重,仅靠推理时 feedback loop 即可显著缓解 identity drift 和时序退化;零训练成本即可升级现有 talking-head 模型,是非常实用的 plug-in 改造 批判点评:把 generator-encoder feedback 当作 implicit fixed-point 迭代是聪明的——既廉价又对预训练模型友好。但 single adaptation step 是否真能稳定逼近 self-consistent equilibrium 取决于具体模型,对发生面部大幅度运动或镜头切换时的鲁棒性需要更细评测;feedback 单步 vs 多步的边际收益曲线也值得展开 10. RVEDiT:MLLM注入Token让DiT分粒度推理编辑 Reasoning to Align: Implicit Reasoning in Diffusion Transformers for Video Editing | 华为 | arXiv:2605.24674 关键词:视频编辑·DiT·MLLM Token·分粒度路由·华为 ⚠️ 前序问题:指令视频编辑需要按自然语言改源视频,同时保留无关内容、保持时序一致。但现有 DiT 编辑器有两个结构性缺陷:(1) 条件信号不分粒度灌入所有 transformer block,单一 token 流既要编码全局意图又要编码细粒度证据;(2) cross-attention 模式只受 pixel-level 重建间接监督,内部推理过程完全不受约束 本文贡献:RVEDiT:implicit Reasoning Video Editing DiT。两个互补组件:(i) Granularity-Routed Token Conditioning——从 MLLM 蒸馏出 learnable editing token 路由到浅层 block,深层 block 留给原生视觉/文本 token,自然形成 coarse-to-fine 编辑过程;(ii) Reference-Anchored Attention Alignment——训练时用参数共享 reference 分支,最大化编辑/参考分支注意力特征的互信息,正则化内部推理但推理时零额外开销 实验效果:在标准指令视频编辑 benchmark 上一致超过 SOTA,对 localized 和 compositional 编辑提升最大;引入 MLLM 推理但部署时单分支,性价比高 批判点评:「分粒度路由 conditioning + reference 互信息对齐」两个手段都直击 DiT 编辑器的结构性病灶,思路非常清晰。但 MLLM 提供的 editing token 是离线蒸馏,可能不能捕捉新颖指令;reference 分支在训练时翻倍显存,长视频上的可扩展性需评测 11. Squeeze-MLLM:MLLM+VAE双条件根治主体生成贴图 Squeezing Capacity from Multimodal Large Language Models for Subject-driven Generation | 多伦多大学 U of T | arXiv:2605.26111 关键词:Subject-driven·MLLM·VAE 身份·DLA·copy-paste ⚠️ 前序问题:subject-driven 生成(保留参考主体身份 + 跟随文字指令)此前主流是 text 和 reference 各编各的——这天然削弱跨模态推理,并导致典型的 copy-paste artifact(参考图被原样贴上去)。最近 MLLM + diffusion 框架改善了指令跟随,但忽略了身份保持 本文贡献:把 diffusion model condition 在 MLLM 上(让 text 和 reference 联合编码),同时用 VAE 做 identity conditioning;新设 Dual Layer Aggregation (DLA) 模块聚合 MLLM 多层级特征做最优 conditioning;用多阶段去噪策略在推理时渐进式平衡 MLLM 提供的语义和 VAE 提供的细节身份 实验效果:把多模态理解和身份保持调和得很好,缓解了 copy-paste 问题,人类偏好评测上 subject-driven 生成超越现有方法;项目页面开放 批判点评:「MLLM 编联合语义 + VAE 守身份细节」的双通道是非常合理的分工——比纯 MLLM/纯 reference encoder 都更接近问题本质。DLA + 多阶段去噪是工程上的细致打磨;但 VAE 通道也可能引入贴图倾向(VAE 重建本身就有 identity 偏置),与最新 IP-Adapter / OmniGen 等的端到端对比是否在所有场景占优需要更细评测 趋势观察 国产开源文生图基础模型加速对标闭源 SOTA — 百度 ERNIE-Image 8B 单流 DiT 系统化打通预训练 bottom-up 数据 + 后训练 top-down + 稳定 DPO + Turbo 蒸馏 + 工业 aesthetic 评测全栈,且模型/数据全部开源——开源阵营在指令跟随/文字渲染/美学三项已逼近 GPT-Image/Imagen/Midjourney 等闭源顶级系统 音视频联合生成进入「规划 + 流式 + 编辑」三角范式 — Baton 用 VA-Planner(多模态 LLM)吐出音/视频共享语义蓝图驱动联合扩散;SpongeBob 通过双向 cross-modal 交互做端到端音视频联合编辑;StreamChar 用 LLM orchestrator 解耦长 horizon 规划与短窗去噪做流式角色音视频——音视频从「各编各的」彻底走向「联合规划 + 联合渲染」 视频生成同时突破两个壁垒:分辨率天花板与训练算力门槛 — PixelWizard 把全局 anchor 与细节合成分层解耦,加上 Noise-Span Aligned Shortcut Training,原生 2K/4K 视频生成提速 10× 且不蒸馏;Paris 2.0 首次完成 decentralized 视频生成预训练,同算力下 FVD 从 561→279(2×)反超 monolithic baseline——视频生成的「分辨率天花板」被工程化突破,「训练必须大集群」被打破 few-step 蒸馏从图像扩散扩展到自回归视频生成 — RTDMD 把蒸馏和 RL 对齐写成同一 KL 优化(4 步刷 SD3/FLUX.2 SOTA);AFD 把 on-policy 对抗 + flow-matching 转换组合用于黑盒异构 teacher 蒸馏 causal 视频 student——证明「步数少 + 画质高 + 对齐人类偏好 + 流式自回归」可以同时拿到,且不依赖白盒 teacher score / 轨迹访问 推理时自适应/编辑成为零训练能力升级标配 — TT-SAC 让 talking-head 模型在推理时通过 generator-encoder feedback loop 自适应 conditioning(免训练、免梯度);RVEDiT 把 MLLM 推理 token 路由到 DiT 浅层 block 形成 coarse-to-fine 编辑;Squeeze-MLLM 用 MLLM+VAE 双通道在推理时渐进平衡语义与身份——「不重训也能拿到新能力」正在成为生成模型的标准升级路径 人工智能炼丹君 整理 | 2026-05-26 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 每日速读|2026-05-18|14B视频对齐单步训练Flash-GRPO 今日 AIGC 论文速览 今日共 7 篇 · 视频扩散对齐与定制 2 篇 · 图像生成几何与少步推理 2 篇 · 多镜头视频与实体一致性 1 篇 · 3D 重建与世界模型 2 篇 重点论文标题列表 Flash-GRPO:14B 视频对齐单步训练即超全轨迹 Spherical-FM:球面插值贴合潜空间路径 ⚡ Sphere-Latent-Enc:解耦图像编码器与球面去噪 EntityBench:多镜头视频实体一致性基准 FashionChameleon:单卡 23.8 FPS 实时换装 今日论文速览 1. Flash-GRPO:14B 视频对齐单步训练即超全轨迹 Flash-GRPO: Efficient Alignment for Video Diffusion via One-Step Policy Optimization | 浙江大学, 京东 | arXiv:2605.15980 关键词:视频扩散·GRPO 对齐·单步训练·时间步分组·14B 大模型 ⚠️ 前序问题:GRPO 已成为对齐视频扩散模型与人类偏好的关键工具,但训练 14B 视频扩散模型动辄需要数百 GPU 天;现有效率方法靠在时间步上做滑动窗口子采样,根本上破坏了优化稳定性,且无法逼近全轨迹训练的对齐质量 本文贡献:提出 Flash-GRPO 单步训练框架:(1) Iso-Temporal Grouping 通过 prompt 内部的时间一致性消除时间步混淆方差,把策略表现与时间步难度解耦;(2) Temporal Gradient Rectification 中和不同时间步的尺度因子,防止梯度幅值跨时间步剧烈漂移;最终单步 GRPO 即可超越全轨迹训练的对齐质量 实验效果:在 1.3B 到 14B 视频扩散模型上验证:训练显著加速、稳定性优于全轨迹基线,对齐质量达到 SOTA,让 14B 视频对齐从「数百 GPU 天」级实验变得可负担 批判点评:把视频 GRPO 的瓶颈精准定位到「时间步混淆 + 梯度尺度漂移」并各个击破,工程上极具实用性;但单步训练对教师 reward 噪声的鲁棒性、与 Causal Forcing 类少步 AR 视频的兼容性还需进一步验证 2. Spherical-FM:球面插值贴合潜空间路径 Aligning Latent Geometry for Spherical Flow Matching in Image Generation | Virginia Tech, fal | arXiv:2605.15193 关键词:Flow Matching·球面几何·潜空间·slerp·图像生成 ⚠️ 前序问题:潜空间 flow matching 通常在高斯噪声与 VAE 潜在变量之间走线性路径,但两端点都集中在薄薄的球壳上,欧式弦线在每一步都「离开了壳」——即使预处理对齐了半径,路径仍然不在真实的数据流形上 本文贡献:把每个潜在 token 分解为「径向 + 角度」两个分量,用 swap 探针证明感知和语义内容主要由方向承载、径向贡献远小于此;据此把数据潜变量投影到固定 token 半径,用高斯噪声的径向投影作为球面先验,冻结 encoder 微调 decoder,并把线性插值替换为球面插值(slerp)——测速目标因此在构造上变成纯角度,路径全程贴在球面上 实验效果:在多种图像 tokenizer 下一致改善 ImageNet-256 的类条件 FID;扩散网络结构无需改动、不引入辅助 encoder 或表征对齐目标,是一条极简但有效的几何修复路径 批判点评:回到流形几何本身解决「半径漂移」问题,理论清晰、实现极简——这是少有的「几乎零代码改动就涨点」的范式工作;但球面假设是否对所有 VAE 潜空间都成立、对 video latent 这种时空联合分布是否仍适用,还需更广验证 3. Sphere-Latent-Enc:解耦图像编码器与球面去噪 Efficient Image Synthesis with Sphere Latent Encoder | MBZUAI | arXiv:2605.15592 关键词:少步图像生成·球面潜空间·解耦训练·Sphere Encoder·推理加速 ⚠️ 前序问题:consistency 与 meanflow 类少步生成虽然推理便宜,但训练不稳定、可扩展性差;近期 Sphere Encoder 能少步出图,却需要在像素空间和潜空间间反复切换,重建与生成挤在同一架构里互相打架 本文贡献:把框架解耦为「固定预训练图像编码器 + 独立的球面潜在去噪模型」,完全在球面潜空间里训练去噪模型——训练和推理都不再需要反复跨像素/潜空间切换,重建和生成各自专精,互不掣肘 实验效果:在 Animal-Faces、Oxford-Flowers、ImageNet-1K 上同时显著超越 Sphere Encoder 的画质和推理速度,对比强力少步与多步基线也能取得有竞争力的结果,是一个高效少步图像合成的新基线 批判点评:「解耦」这个看似平凡的工程决策,反映出一个被忽略的事实:把重建和生成耦合在同一目标里很容易互相妥协;但跨数据集泛化、与扩散 Transformer 的兼容、以及球面潜空间的尺度上限仍需进一步研究 4. EntityBench:多镜头视频实体一致性基准 EntityBench: Towards Entity-Consistent Long-Range Multi-Shot Video Generation | ByteDance, Rice University | arXiv:2605.15199 关键词:多镜头视频·实体一致性·评测基准·记忆增强·叙事生成 ⚠️ 前序问题:多镜头视频生成把单镜头延伸到连贯叙事,但跨镜头维持角色、物体、地点的一致性长期是难题;现有评测用独立生成的 prompt 集,实体覆盖有限、一致性指标过于简单,难以做标准化比较 本文贡献:提出 EntityBench:从真实叙事媒体里抽取的 140 个 episode、2,491 个镜头,按易/中/难三档同时跟踪角色、物体、地点的实体调度(最长 50 镜头、13 跨镜头角色、22 跨镜头物体、回归间隔最长 48 镜头);配套三支柱评测套件解耦 intra-shot 质量、prompt 跟随、跨镜头一致性,并用保真度门控只让正确出现的实体进入跨镜头打分;另发布 EntityMem 基线:先把每实体的可信视觉参考存入持久记忆库,再生成 实验效果:实验显示现有方法的跨镜头实体一致性随回归距离急剧下降,显式 per-entity 记忆带来最高角色保真度(Cohen's d = +2.33)和实体出现率,为多镜头视频提供了能区分 SOTA 的标准评测 批判点评:把多镜头视频的「角色/物体/地点」标准化为可量化的 entity schedule 是社区一直缺的基础设施;但 140 个 episode 主要来自既有叙事媒体,对完全开放生成场景的覆盖度、评测自动化中视觉感知模型的偏差,仍是后续要补的环节 5. FashionChameleon:单卡 23.8 FPS 实时换装 FashionChameleon: Towards Real-Time and Interactive Human-Garment Video Customization | 厦门大学, 阿里巴巴 | arXiv:2605.15824 关键词:视频定制·实时交互·KV Cache·In-Context Learning·电商生成 ⚠️ 前序问题:服装级人物视频定制有巨大商业价值(电商、内容创作),但现有方法不支持低延迟交互式服装控制——用户无法在生成过程中实时切换服装,且多服装训练数据稀缺 本文贡献:提出 FashionChameleon 实时交互式自回归视频定制框架:(1) 不训多服装数据,用单参考-服装对配合 in-context learning 训练 Teacher Model,强制 reference/garment 失配迫使模型隐式保持单服装切换的连贯;(2) Streaming Distillation with In-Context Learning 用 in-context teacher forcing 微调,并用梯度重加权 distribution matching distillation 改善外推一致性;(3) Training-Free KV Cache Rescheduling 通过 garment KV refresh / historical KV withdraw / reference KV disentangle 实现切换时保留运动连贯 实验效果:支持长视频外推一致性 + 实时交互式服装切换,单 GPU 23.8 FPS 实时生成,比已有基线快 30-180 倍 批判点评:用「单服装数据 + KV 调度」绕过了多服装数据采集的瓶颈,是非常聪明的工程方案;但 KV 调度对极端切换(颜色/版型差异巨大)的视觉伪影、长时间交互后的累积漂移,仍是产品化的关键考验 6. VGGT-Ω:前馈 3D 重建首现 Scaling Law VGGT-Ω: Scaling Feed-Forward 3D Reconstruction | Meta FAIR, Oxford VGG | arXiv:2605.15195 关键词:前馈 3D 重建·register attention·scaling·动态场景·VLA ⚠️ 前序问题:VGGT 这类前馈式 3D 重建模型已经能与传统优化基线掰手腕,并提供几何感知特征服务下游任务;但要把这种模型 scale up 训练到更大的数据规模,原架构的显存占用与计算冗余成为最大障碍 本文贡献:提出 VGGT-Ω:(1) 用单一密集预测头 + 多任务监督简化原架构,去掉昂贵的高分辨率卷积层;(2) 用 register 把场景信息聚合为紧凑表示,并引入 register attention 把跨帧信息交换限定在 register 之间,部分替代全局 attention;(3) 配套高质量动态场景标注流水线 + 自监督协议;训练显存只需前代 30%,得以使用 15× 监督数据 + 大量无标注视频 实验效果:在静态与动态场景多个 benchmark 上一致刷 SOTA,例如 Sintel 上相机估计精度比之前最好结果提升 77%;学到的 register 还能改善 VLA 模型并支持语言对齐,证明重建可以作为空间理解的可扩展代理任务 批判点评:「重建模型也存在 scaling law」并通过架构精简一次性把训练规模拉满,是 VGGT 系列工作的关键里程碑;但 register 数量与表达能力的取舍、动态场景对真实开放视频的泛化,仍需在更复杂自由场景下追加验证 7. ReactiveGWM:解耦玩家与 NPC 跨游戏零样本 ReactiveGWM: Steering NPC in Reactive Game World Models | 腾讯, 新加坡国立大学, 港理工, 港科大广州 | arXiv:2605.15256 关键词:游戏世界模型·NPC 交互·零样本迁移·扩散主干·可控生成 ⚠️ 前序问题:现有游戏世界模型只从玩家主观视角模拟环境,把 NPC 当作背景像素,无法捕捉玩家与 NPC 的交互;本质上更像被动视频渲染器而非真正的仿真引擎,缺少建模动作引发的 NPC 反应所需的物理理解 本文贡献:提出 ReactiveGWM:显式解耦玩家控制与 NPC 行为——玩家动作通过轻量加性偏置注入扩散主干,NPC 高层响应(进攻/控制/防御)通过 cross-attention 模块 grounding;这些模块学到与游戏无关的交互逻辑表示,可零样本插入其他无标注游戏的世界模型,无需领域微调即可解锁可操控 NPC 交互 实验效果:在两款街头霸王上验证:保持精细玩家可控性的同时实现稳健、prompt 对齐的 NPC 策略遵循,为「策略丰富、可控的 NPC 交互」打开了零样本扩展的可能 批判点评:把「玩家 vs NPC」拆成两条解耦支路是非常优雅的设计,零样本迁移到其他游戏的能力让世界模型走出单一题材;但目前只验证了对战类游戏,开放世界 RPG 的多 NPC 协作、长时序情节一致性仍是开放问题 趋势观察 视频扩散对齐进入「单步训练」时代 — Flash-GRPO 把全轨迹 GRPO 压缩到单步训练,靠 iso-temporal grouping 与 temporal gradient rectification 修复时间步混淆与梯度漂移——14B 视频对齐从「数百 GPU 天」级实验降为可负担成本,视频扩散偏好对齐正在跨过工程化门槛 流匹配开始「修几何」而不是堆模型 — Spherical-FM 用径向/角度分解证明感知信息主要由方向承载,把线性插值改为球面插值即在多个 tokenizer 上一致涨点;Sphere Latent Encoder 进一步把生成完全搬到球面潜空间——少步图像生成的下一波收益来自「让路径贴上流形」 多镜头视频从「能拍」走向「记得住」 — EntityBench 把跨镜头角色/物体/地点一致性升级为可量化基础设施,配套 EntityMem 显式记忆库验证「记忆」是关键变量——多镜头视频生成的下一战场不是单镜头质量,而是叙事意义上的实体连续性 人物-服装视频生成走向实时交互 — FashionChameleon 用 in-context learning + KV cache 调度实现 23.8 FPS 单 GPU 实时换装,比基线快 30-180 倍——电商和内容创作的「实时交互式视频定制」从 demo 走向产品级 重建模型也存在 scaling law — VGGT-Ω 用 register attention 等架构精简把训练显存压到 30%,在 15× 数据上推到 77% Sintel 提升;ReactiveGWM 让世界模型零样本迁移到不同游戏——「重建+世界模型」开始从感知任务走向通用空间智能 人工智能炼丹君 整理 | 2026-05-18 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
AIGC 周末专题|2026-05-17|实时自回归视频生成加速 AIGC 周末专题深度解读:实时自回归视频生成:从蒸馏加速到流式交互的范式突破 人工智能炼丹君 整理 | 2026年5月17日(周日) 覆盖时间:2026-05-11 ~ 2026-05-16 本期概述 本期 AIGC 周末专题聚焦实时自回归视频生成:从蒸馏加速到流式交互的范式突破方向,精选 8 篇代表性论文进行深度解读。 方向分布: 自回归蒸馏加速 4 篇 (Causal Forcing++, AnyFlow, RAVEN, CDM) 流式推理与 KV Cache 优化 3 篇 (Forcing-KV, SWIFT, HSA) 世界模型与多镜头叙事 2 篇 (SANA-WM, CausalCine) 含 NVIDIA/MIT 联合 × 2 技术路线与时间线 基础蒸馏时代(2022.06 — 2024.06) 描述:Progressive Distillation 开创渐进蒸馏路线,Consistency Models 提出端点一致性映射,少步生成从理论走向实践。 关键节点: 2022.06:Progressive Distillation:渐进蒸馏开山作 2023.03:Consistency Models:一步生成理论突破 2023.12:DMD/DMD2:分布匹配蒸馏 2024.06:SD-Turbo/SDXL-Turbo:1-4 步商用 因果 AR 蒸馏兴起(2024.06 — 2025.12) 描述:Self Forcing 开创 AR 视频蒸馏范式,Causal Forcing 将 chunk-wise 4 步推向可用,流式视频生成原型出现。 关键节点: 2024.09:Self Forcing:AR 视频蒸馏开创 2025.02:Causal Forcing:chunk-wise 4 步实用 2025.06:Genie3:action-conditioned 世界模型 2025.12:LongLive:长视频流式生成 实时化爆发期(2026.01 — 2026.05) 描述:Frame-wise 蒸馏、KV Cache 压缩、无训练加速三线并进,实时交互式视频生成从实验室走向产品。 关键节点: 2026.03:CDM:连续时间分布匹配突破离散瓶颈 2026.05:Causal Forcing++:frame-wise 2 步实时 2026.05:AnyFlow:Flow Map 恢复步数可扩展性 2026.05:Forcing-KV/SWIFT:单卡 20-29 FPS 世界模型与叙事融合(2026.03 — 未来) 描述:实时 AR 视频生成与世界模型、多镜头叙事融合,从'生成画面'走向'仿真世界'。 关键节点: 2026.05:SANA-WM:消费级 GPU 分钟级世界模型 2026.05:CausalCine:多镜头叙事 AR 生成 未来:实时世界仿真 + 用户交互式导演 1. Causal Forcing++:因果一致性蒸馏实现 Frame-wise 2 步实时视频生成:清华 TSAIL 将因果 AR 蒸馏从 chunk-wise 4 步推进到 frame-wise 2 步,首帧延迟降低 50% 论文: Causal Forcing++:因果一致性蒸馏实现 Frame-wise 2 步实时视频生成 arXiv: 2605.15141 机构: Tsinghua TSAIL, 生数科技 (Shengshu) 1.1 研究动机 核心问题: Frame-wise AR 蒸馏的初始化策略与少步目标错位 实时交互式视频生成需要低延迟、流式、可控的 rollout。Causal Forcing 等先驱已经证明 chunk-wise 4 步蒸馏的可行性,但 chunk 粒度过粗——每生成 16 帧需 4 步 DiT forward pass,首帧延迟仍以秒计。如果能做到 frame-wise 1-2 步,每帧只需 1-2 次 forward pass,延迟可再降一个量级。问题是:现有蒸馏初始化策略要么目标错位、要么不能少步生成、要么算力大到无法 scale。 前序工作及局限: Causal Forcing:Chunk-wise 4 步成功但延迟仍高 Consistency Models:提供一致性蒸馏理论基础 与前序工作的本质区别: Causal CD 只需一次教师 ODE 步在线监督,三阶段初始化解决冷启动 1.2 方法原理 Causal Forcing++ 解决的核心问题是:如何在 frame-wise 粒度做高效的因果 AR 蒸馏?关键观察:Causal Consistency Distillation 学的流图与 Causal ODE 蒸馏完全等价,但训练信号更简洁——只需教师模型做一步 ODE 更新,学生学习匹配该更新结果。这避免了传统蒸馏需要预计算完整 PF-ODE 轨迹的巨大开销。 三阶段初始化解决冷启动:(1) 双向扩散预训练让模型学习高质量生成能力;(2) 因果适配将双向注意力切换为因果 mask,保持生成质量同时获得 AR 属性;(3) 少步蒸馏在上述基础上训练 frame-wise 1-2 步推理。 进一步将流水线扩展到 Genie3 风格 action-conditioned 世界模型,用相同 Causal CD 范式蒸馏交互式世界模型,支持动态 action 实时驱动。 1.3 核心创新 提出 Causal CD(因果一致性蒸馏)流水线:核心观察是 Causal CD 学习与 Causal ODE 蒸馏相同的 AR 条件流图,但只需在相邻时间步之间用一次教师 ODE 步在线提供监督,无需预计算完整 PF-ODE 轨迹——既高效又易优化。三阶段初始化策略彻底解决 frame-wise 蒸馏的冷启动问题。 1.4 实验结果 在 frame-wise 2 步设定下,全面超越 SOTA 4 步 chunk-wise Causal Forcing:VBench Total +0.1、VBench Quality +0.3、VisionReward +0.335。首帧延迟降低 50%。Stage 2 训练成本降至约 1/4。扩展到世界模型同样有效。 1.5 关键洞察 [{'point': '教师 ODE 误差放大', 'detail': '1-2 步生成使教师单步 ODE 的离散化误差直接影响学生最终输出,误差没有后续步骤修正的机会'}, {'point': '世界模型场景的 action 复杂度', 'detail': '在简单 action 下表现优秀,但面对复杂多步交互指令时的稳定性需要更多压力测试'}, {'point': '未开源', 'detail': '论文来自产业实验室,复现需等待官方代码公开'}] 技术演进定位: Frame-wise 因果 AR 蒸馏的实时交互级方案 可能的后续方向: Frame-wise 1 步 端到端无分阶段初始化 2. AnyFlow:任意步数视频蒸馏的 Flow Map 统一框架:NUS Show Lab + MIT + NVIDIA 首次基于 Flow Map 实现 4→32 步性能单调提升 论文: AnyFlow:任意步数视频蒸馏的 Flow Map 统一框架 arXiv: 2605.13724 机构: National University of Singapore Show Lab, MIT, NVIDIA 2.1 研究动机 核心问题: Consistency Distillation 步数增加时性能退化 过去一年的少步视频生成被一致性蒸馏(Consistency Distillation)统治——4-8 步即可出图。但一个致命问题:把步数从 4 加到 16/32,画质反而崩溃。为什么?CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为。用户需要'任意步数'推理的灵活性——算力充裕时多步出精品,紧急场景少步求速度——但 CD 做不到。 前序工作及局限: Consistency Models:端点映射 z_t→z_0 破坏 ODE 语义 Shortcut Models:任意区间跳跃但未系统化 与前序工作的本质区别: Flow Map z_t→z_r 目标 + FMBS on-policy 训练恢复步数可扩展性 2.2 方法原理 AnyFlow 的核心洞察:一致性蒸馏学的是 z_t→z_0 的端点映射,这迫使模型'一步到位'——当允许多步时,中间状态没有明确的 ODE 语义,因此步数越多反而越混乱。 Flow Map 解决方案:不学端点映射,而是学任意时间区间 [t, r] 的流图过渡 z_t→z_r。当 r=0 退化为一步生成,当 r>0 退化为多步 ODE 采样的某一段——自然统一了少步和多步。 FMBS 训练方法:传统蒸馏是 off-policy 的——用教师 ODE 生成配对 (z_t, z_r)。AnyFlow 提出 on-policy 方法:让学生自身做 Euler rollout,在 rollout 路径上反向模拟真实的流图过渡,用于训练。这解决了视频域因果生成的 exposure bias 问题。 在双向 DiT(Open-Sora Plan)和因果 AR(CausalVAR)两类骨干、1.3B 到 14B 全规模区间验证。 2.3 核心创新 提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架。核心突破:(1) 将蒸馏目标从端点一致性 z_t→z_0 升级为流图过渡 z_t→z_r(任意时间区间),让学生学会任意区间跳跃;(2) Flow Map Backward Simulation (FMBS) 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏。 2.4 实验结果 在双向和因果两类视频扩散骨干上一致达到或超越 consistency baseline。关键突破:步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势。在 14B 模型上同样有效。 2.5 关键洞察 [{'point': '复现门槛高', 'detail': '需要 1B-14B 级别教师模型 + 大规模 on-policy rollout,数据与算力两端门槛都不低'}, {'point': '具体数值缺失', 'detail': '论文未公开 VBench/UCF-FVD 等标准 benchmark 的绝对数值,难以与其他方法直接对比'}, {'point': '训练效率', 'detail': 'On-policy rollout 的训练时间和显存开销与 off-policy CD 的对比数据不够充分'}] 技术演进定位: 首次理论解释 CD 多步退化并给出 flow map 解决方案 可能的后续方向: 自适应步数调度 Flow Map + RL 结合 3. RAVEN:训练-测试对齐的实时自回归视频外推:帝国理工 AGI Lab 提出 CM-GRPO 在一致性核上直接做 RL 论文: RAVEN:训练-测试对齐的实时自回归视频外推 arXiv: 2605.15190 机构: Imperial College London AGI Lab 3.1 研究动机 核心问题: 因果视频蒸馏训练用真实 history、推理用自身 rollout 的分布 gap 因果自回归视频扩散模型通过蒸馏高保真双向教师已能实现少步推理。但一个根本性问题一直被忽视:训练时用真实 history(来自数据集)作为条件,推理时却用模型自身 rollout 的结果作为 history——两者分布不同。随着 rollout 长度增加,这个训练-测试分布 gap 会累积放大,导致长序列生成质量严重退化。 前序工作及局限: Self Forcing:self-rollout 训练但未系统性解决对齐 GRPO:RL 对齐但在扩散模型上公式复杂 与前序工作的本质区别: RAVEN rollout 重打包 + CM-GRPO 在一致性核上做 RL 3.2 方法原理 RAVEN 解决的核心问题是训练-测试分布不对齐。具体做法:训练时不再只用真实数据作为 history 条件,而是让模型先做一段 rollout 生成'假 history',然后把这个 rollout 的干净端点重新打包为条件输入,让模型在自身 rollout 分布上继续学习。这样训练时看到的 history 分布就与推理时一致。 CM-GRPO 的创新在于简化了 RL 在生成模型上的应用。传统 flow-model RL 需要构造 Euler-Maruyama 辅助过程来定义 policy gradient,复杂且不稳定。CM-GRPO 的观察:consistency model 的每步采样本质上是条件高斯转移 p(z_{t-1}|z_t) = N(μ(z_t), σ²I),可以直接在这个高斯核上定义 log-probability 并做 GRPO——公式简洁、梯度稳定。 两者组合:RAVEN 让模型在正确分布上训练,CM-GRPO 让模型朝奖励方向优化。 3.3 核心创新 提出 RAVEN training-time test 框架:把每次自身 rollout 重打包为(干净历史端点 + 噪声去噪状态)交错序列,让训练注意力对齐推理时的外推方式。进一步提出 CM-GRPO:把 consistency 采样步重新表达为条件高斯转移,直接在该核上做在线 RL,避免了 flow-model RL 中 Euler-Maruyama 辅助过程的复杂性。 3.4 实验结果 RAVEN 在质量、语义、动态度多维评测上超越近期因果视频蒸馏 baseline。CM-GRPO 与 RAVEN 组合后进一步提升性能。训练-测试对齐效果在长序列(>100 帧)上尤为显著。 3.5 关键洞察 [{'point': '内存开销', 'detail': 'RAVEN 重打包需要额外存储 rollout 结果,对长序列的内存占用影响未充分量化'}, {'point': '奖励设计敏感性', 'detail': 'CM-GRPO 的效果强依赖于奖励函数设计,在更复杂/多维奖励场景下的稳定性有待验证'}, {'point': '模型规模验证', 'detail': '在更大模型尺度(>5B)上是否同样有效需要进一步实验'}] 技术演进定位: 系统性解决因果视频蒸馏训练-测试对齐的首个完整方案 可能的后续方向: 多奖励 CM-GRPO 自适应 rollout 长度 4. Forcing-KV:注意力头特化驱动的 KV Cache 混合压缩:NVIDIA/MIT/ETH 联合发现注意力头功能特化规律,单卡 H200 达 29+ FPS 论文: Forcing-KV:注意力头特化驱动的 KV Cache 混合压缩 arXiv: 2605.09681 机构: NVIDIA, MIT, ETH Zurich, ZJU 4.1 研究动机 核心问题: AR 视频扩散历史帧 KV Cache 线性膨胀导致显存爆炸 自回归视频扩散模型(如 Self Forcing)通过流式生成实现了开放式长视频合成。但致命瓶颈来了:随着生成帧数增加,历史帧的 KV Cache 线性膨胀——注意力复杂度爆炸 + 显存不够用。一段 30 秒的 1080P 视频,KV Cache 就能吃掉整张 H100 的 80GB 显存。如果不压缩 KV Cache,流式视频生成就永远停留在几秒级别。 前序工作及局限: Flash Attention:算法层面加速但不压缩缓存 Token Merging:图像域 token 压缩 与前序工作的本质区别: 发现注意力头功能特化并据此设计静态/动态混合压缩 4.2 方法原理 Forcing-KV 的核心发现:在自回归视频扩散模型中,不同注意力头承担完全不同的功能角色,这种分工是稳定且可预测的。 静态头特征:注意力分布集中在远程 token(历史帧的关键区域),负责跨 chunk 的语义连续性和帧内的结构保真。这些头对'哪些远程 token 重要'的判断高度一致,因此可以做结构化剪枝——只保留少数高注意力权重的远程 token。 动态头特征:注意力集中在近邻 token(前几帧),负责帧间运动预测和局部一致性。近邻帧之间往往高度相似,因此可以做相似度驱动的动态剪枝——当相邻片段的 KV 向量相似度超过阈值时合并。 工程实现:KV-cache 同步机制确保压缩后的 cache 在多 head 之间保持一致的时间索引;缓存 Euler 更新将已压缩 token 的 denoising 中间状态缓存起来避免重复计算。 4.3 核心创新 首次发现视频扩散模型中注意力头具有稳定的功能特化:静态头(Static Heads)负责跨 chunk 过渡和帧内保真,关注远程 token;动态头(Dynamic Heads)负责帧间运动与一致性,关注近邻 token。基于此设计混合压缩:对静态头执行结构化剪枝(保留远程关键 token),对动态头执行基于片段相似度的动态剪枝(移除冗余近邻)。 4.4 实验结果 在 LongLive 和 Self Forcing 两个 AR 视频扩散模型上验证。480P 场景:1.35x/1.50x 加速。1080P 场景:加速比达 2.82x。单卡 H200 达到 29+ FPS 并减少 30% cache 显存。无需离线 profiling,运行时自动判断头类型。 4.5 关键洞察 [{'point': '架构通用性', 'detail': '仅在两个 AR 视频扩散模型上验证,是否推广到非 AR 架构(如 CogVideoX)有待检验'}, {'point': '头分类稳定性', 'detail': '静态/动态头的划分是否在新架构或不同训练阶段仍然成立存疑'}, {'point': '质量退化分析', 'detail': '在极端压缩比下(如 80%+ 裁剪)的视觉质量退化模式需要更多系统性分析'}] 技术演进定位: 首次揭示视频扩散注意力头分工并实现实时 29 FPS 可能的后续方向: 自适应头分类 hierarchical cache 5. SWIFT:无训练语义自适应记忆实现高效流式长视频:中科大/复旦/Georgia Tech 提出逐头语义注入,单卡 H100 达 22.6 FPS 论文: SWIFT:无训练语义自适应记忆实现高效流式长视频 arXiv: 2605.09442 机构: University of Science and Technology of China, Fudan University, Georgia Institute of Technology 5.1 研究动机 核心问题: 流式长视频 prompt 切换时 KV Cache 管理困难 流式长视频生成的核心挑战之一是语义切换——当 prompt 变化时(例如从'人走路'切换到'人跑步'),模型需要在保持视觉连贯性的同时响应新语义。现有方法在 prompt 边界处要么重建整个 KV Cache(慢),要么固定缓存大小无法适配语义变化(质量差)。 前序工作及局限: StreamingT2V:滑动窗口但无语义感知 ControlNet/P2P:注入控制但非流式 与前序工作的本质区别: 无训练语义注入代替缓存重建,逐头梯度化更新 5.2 方法原理 SWIFT 解决的问题:流式视频生成中 prompt 切换时如何高效更新记忆? 传统做法是在 prompt 边界处清空并重建 KV Cache,这造成两个问题:(1) 重建开销大,打断流式生成的实时性;(2) 清空历史信息可能导致前后帧视觉不连贯。 SWIFT 的做法完全不同:不清空缓存,而是把新 prompt 的语义'注入'到已有 cache 中。具体实现:计算每个注意力头当前 KV 状态与新 prompt 特征的对齐度(余弦相似度),对齐度高的头已经自然适配新语义(少注入),对齐度低的头需要更多新信息(多注入)。 自适应动态窗口:不同 prompt 阶段的记忆需求不同——刚切换时需要大窗口保持过渡平滑,稳定后可缩小窗口节省显存。SWIFT 根据生成帧数和语义稳定度自动调整窗口大小。 关键优势:完全无训练,可直接插入任何因果视频扩散模型。 5.3 核心创新 提出 SWIFT(Semantic Windowing and Injection for Flexible Transitions)无训练框架:(1) 语义注入缓存增强——不重建缓存,而是将新 prompt 语义注入已有缓存中;(2) 逐头语义注入——每个注意力头按自身与当前视频状态的对齐度决定接收多少新语义更新;(3) 自适应动态窗口——按 prompt 阶段分配时间记忆容量。 5.4 实验结果 在保持生成质量的同时,单卡 H100 上达到 22.6 FPS。多 prompt 长视频(>200 帧)的语义切换平滑度显著优于重建方案。与 Self Forcing 等 AR 模型即插即用兼容。 5.5 关键洞察 [{'point': '语义对齐度计算延迟', 'detail': '逐头计算语义对齐度本身引入额外延迟,在极端实时场景下可能成为瓶颈'}, {'point': '双向注意力适用性', 'detail': '仅在因果视频扩散模型上验证,对双向注意力架构是否同样有效存疑'}, {'point': '复杂语义切换', 'detail': '在多重、快速的语义切换场景下(如 5 秒内切换 3 次 prompt)的稳定性未充分验证'}] 技术演进定位: 首个无训练的流式语义切换方案 可能的后续方向: 与 KV 压缩组合 多模态条件注入 6. CDM:连续时间分布匹配蒸馏:阿里/南开提出动态连续调度,从离散锚定进化到连续流形优化 论文: CDM:连续时间分布匹配蒸馏 arXiv: 2605.06376 机构: Alibaba, Nankai University 6.1 研究动机 核心问题: DMD 离散锚定导致少步生成伪影 DMD(Distribution Matching Distillation)是少步扩散蒸馏的主流范式之一,但有个根本缺陷:它在离散时间步上做分布匹配——只在 {0, 0.25, 0.5, 0.75, 1.0} 等稀疏锚点对齐分布。这种离散锚定加上反向 KL 散度的模式寻求特性,容易产生视觉伪影和过度平滑。通常需要额外的 GAN 判别器或奖励模型来修补,系统复杂度极高。 前序工作及局限: DMD/DMD2:离散时间步分布匹配 Progressive Distillation:渐进蒸馏但步数固定 与前序工作的本质区别: 连续时间采样 + 轨迹偏离匹配,移除 GAN/奖励辅助 6.2 方法原理 ![Overview of Continuous-Time Distribution Matching (CDM). Top: Our approach employs a dynamic continuous time schedule during backward simulation, sampling intermediate anchors uniformly from $(0, 1]$. Bottom Left: CFG augmentation (CA) and distribution matching (DM) operate on this dynamic schedule to align text-image conditions and data distributions at on-trajectory anchors. Bottom Right: To address inter-anchor inconsistency, the proposed CDM objective explicitly extrapolates off-trajectory latents ($x_t_i'$) using the predicted velocity.](https://jefxiong.cn/assets/images/AIGC/20260516/2605.06376_1.png) CDM 的核心洞察:DMD 之所以需要 GAN 和奖励模型修补,是因为离散锚定注定了'覆盖不全'——轨迹上 99% 的点没有监督信号,模型在这些无监督区域自由飘移。 解决方案:把分布匹配从离散点扩展到连续流形。具体实现:(1) 训练过程中不再用固定时间步集合 {t₁, t₂, ...},而是在 [0,1] 上连续采样匹配点,采样概率密度随训练动态调整——模型薄弱的区域被更频繁地采样;(2) 对齐目标不再局限于 ODE 轨迹上的点,还主动采样轨迹附近的'偏离点'——这迫使模型学习在轨迹邻域内也保持良好的分布匹配。 效果:连续调度消除了离散锚定的覆盖空洞,偏离匹配增强了模型在采样扰动下的鲁棒性。两者组合后,即使不用 GAN 和奖励模型,视觉质量也能匹配甚至超越带这些辅助模块的方案。 6.3 核心创新 将 DMD 框架从离散锚定首次迁移到连续优化:(1) 动态连续调度——允许在任意轨迹点(而非预设锚点)做分布匹配,采样点随训练自适应调整;(2) 连续时间对齐目标——主动在偏离 ODE 轨迹的位置做匹配,增强鲁棒性。无需 GAN、无需奖励模型等复杂辅助模块。 6.4 实验结果 ![Empirical evidence of schedule decoupling. (a) Conventional distillation strictly anchors backward simulation to predefined discrete inference timesteps. In contrast, our dynamic scheduling optimizes over uniformly sampled continuous timesteps $t (0, 1]$ at each iteration. (b) Visually, the dynamically scheduled model produces finer details and fewer artifacts than the strictly aligned baseline. (c) Quantitatively, it also attains a higher HPSv3 score, indicating that exact discrete alignment is not only unnecessary but in fact restrictive---motivating our continuous-time formulation.](https://jefxiong.cn/assets/images/AIGC/20260516/2605.06376_2.png) 在 SD3-Medium 和 Longcat-Image 上展示了高度竞争力的少步生成视觉保真度。4 步 FID 达到接近 50 步教师的水平。代码已开源(GitHub)。无需 GAN 或奖励模型的极简架构降低了工程复杂度。 6.5 关键洞察 [{'point': '训练开销', 'detail': '连续调度增加了每步的采样复杂度,实际训练时间和显存开销的对比数据不够充分'}, {'point': '视频域验证缺失', 'detail': '仅在图像模型上验证,视频域的时序一致性是否同样受益未知'}, {'point': '与 CD 方法对比', 'detail': '与 Consistency Distillation 的直接对比较少,两者互补性未探讨'}] 技术演进定位: 分布匹配蒸馏从离散走向连续的进化 可能的后续方向: 视频域连续调度 自适应精度匹配 7. SANA-WM:2.6B 参数分钟级世界模型的算力民主化:NVIDIA/MIT/港科大提出 Hybrid Linear DiT,单卡 RTX 5090 生成 60s 720p 论文: SANA-WM:2.6B 参数分钟级世界模型的算力民主化 arXiv: 2605.15178 机构: NVIDIA, MIT, HKUST 7.1 研究动机 核心问题: 分钟级世界模型训练和推理都需要海量资源 分钟级世界模型是通往具身智能和虚拟环境仿真的必经之路。但现有方案面临三重困境:(1) 画质要求媲美产业级大模型(LingBot-World、HY-WorldPlay),(2) 训练需要海量闭源数据和数百张 GPU,(3) 推理需要多卡集群。结果是:开源社区几乎没有可用的分钟级世界模型。 前序工作及局限: Genie2/3:分钟级但闭源/昂贵 SANA:高效图像生成架构 与前序工作的本质区别: Hybrid Linear Attention + 公开数据 + 量化蒸馏 → 消费级 GPU 7.2 方法原理 SANA-WM 的核心挑战:如何用有限资源做出质量不差的分钟级世界模型? Hybrid Linear Attention:纯 softmax attention 的 O(n²) 复杂度在分钟级视频(数千帧)上不可承受。SANA-WM 将 frame-wise 的 Gated DeltaNet(线性复杂度,处理帧内 token)与跨帧的 softmax attention(处理时序依赖)混合——帧内用线性、帧间用 softmax,总复杂度接近 O(n)。 Dual-Branch Camera Control:世界模型需要精确的 6-DoF 相机控制。SANA-WM 设计双分支:一个分支处理相机轨迹的全局运动趋势,另一个处理局部帧间旋转/平移细节,两者融合后注入 DiT。 数据方案:不依赖闭源数据,而是从公开视频(WebVid 等)自动提取 metric-scale 6-DoF 相机姿态作为 action 标签。标注流水线基于 DUSt3R + SLAM,全自动无人工。 推理优化:蒸馏 + NVFP4 量化,在单张 RTX 5090 上 34 秒生成 60s 720p clip。 7.3 核心创新 提出 SANA-WM:首个面向分钟级视频生成的开源高效世界模型。三大技术突破:(1) Hybrid Linear Attention——frame-wise Gated DeltaNet 与 softmax attention 混合,长上下文内存 O(n) 可控;(2) Dual-Branch Camera Control——保证 6-DoF 轨迹精确跟随;(3) 鲁棒标注流水线——从公开视频自动提取 metric-scale 6-DoF 相机姿态。 7.4 实验结果 仅用约 213K 公开视频片段、64 张 H100 训练 15 天。单 GPU 即可生成 60s 720p clip。蒸馏量化版在单卡 RTX 5090 上 NVFP4 下 34 秒完成。在 1 分钟世界模型 benchmark 上动作跟随精度强于现有开源 baseline,画质相当但吞吐高 36 倍。 7.5 关键洞察 [{'point': 'Refiner 依赖', 'detail': '1 分钟生成仍依赖 stage-2 refiner 外置模块,端到端质量与商业闭源仍有差距'}, {'point': '场景多样性', 'detail': '213K 公开视频的场景覆盖度有限,复杂室内/多物体交互场景可能生成质量不稳定'}, {'point': '6-DoF 精度', 'detail': '自动标注的 6-DoF 姿态精度受限于 DUSt3R/SLAM 的能力,在快速运动或低纹理场景可能有偏差'}] 技术演进定位: 首个面向消费级硬件的开源分钟级世界模型 可能的后续方向: 多模态 action 物理引擎耦合 8. CausalCine:多镜头叙事的实时自回归视频生成:港科大/蚂蚁/上交提出内容感知记忆路由 CAMR 支持动态镜头切换 论文: CausalCine:多镜头叙事的实时自回归视频生成 arXiv: 2605.12496 机构: HKUST, Ant Group, SJTU 8.1 研究动机 核心问题: AR 视频模型无法处理多镜头叙事中的镜头转换 现有自回归视频模型解决了'开放式生成'——可以无限延伸画面。但电影叙事不是无限延伸单一场景——它需要事件演进、视角切换、镜头边界。当用户说'先拍远景,然后切到近景,再来个俯拍'时,现有 AR 模型将其视为单一长序列延伸,结果:运动停滞、语义漂移、无法处理镜头转换。 前序工作及局限: Self Forcing:单镜头流式生成 MovieGen:多镜头但非 AR/非实时 与前序工作的本质区别: CAMR 内容感知路由 + 多镜头训练数据构建 8.2 方法原理 CausalCine 解决的核心问题:如何让 AR 视频模型理解'镜头'概念? 传统 AR 视频模型把所有帧当作同质序列——前一帧和后一帧的关系是'延续'。CausalCine 引入镜头边界的概念:同一镜头内的帧关系是'延续',跨镜头帧关系是'切换'——两者需要完全不同的记忆策略。 CAMR (Content-Aware Memory Routing) 的具体做法:不使用固定的滑动窗口来管理历史 KV Cache,而是让每个新 token 通过注意力得分动态选择'回忆什么'。镜头切换时,与新镜头语义相关的历史(如同一人物的远景)被高权重检索,无关历史(如前一场景的背景细节)被低权重淡化。 这本质上是一种学习到的'选择性遗忘'——让模型在保持叙事连贯性(人物/故事线)的同时,允许视觉内容的突变(场景切换)。 最后蒸馏为少步实时生成器,保持交互式特性。 8.3 核心创新 将多镜头视频生成转化为在线导演过程:(1) 在原生多镜头序列上训练因果基础模型,学习复杂的镜头转换先验(淡入淡出/硬切/运镜等);(2) 提出 Content-Aware Memory Routing (CAMR)——按注意力相关性动态检索历史 KV 条目而非固定窗口,让镜头切换时记忆'该忘的忘、该记的记'。 8.4 实验结果 显著超越自回归基线,接近双向模型能力。多镜头叙事的连贯性(人物一致性、情节连续性)在主观评测中远超现有 AR 方案。支持动态 prompt 实时切换——生成中途改变指令,模型自动执行镜头切换。 8.5 关键洞察 [{'point': '训练数据获取', 'detail': '原生多镜头视频的镜头边界标注获取成本未讨论,是否需要大量人工标注'}, {'point': '蒸馏后多样性', 'detail': '蒸馏为少步生成器后,镜头转换的多样性(淡入/硬切/运镜等)是否被压缩到少数模式'}, {'point': '长叙事稳定性', 'detail': '超过 10 个镜头的长叙事中,人物一致性是否能稳定维持'}] 技术演进定位: 首个面向多镜头叙事的实时 AR 视频框架 可能的后续方向: 分镜自动规划 多角色追踪 横向对比与技术脉络总结 横向对比:本周实时视频生成技术路线对比 论文 核心方法 推理步数 单卡速度 是否需要训练 视频长度 是否开源 Causal Forcing++ 因果一致性蒸馏 Frame-wise 2 步 未公布 FPS 需蒸馏训练 开放式流式 未开源 AnyFlow Flow Map 任意步数蒸馏 4-32 步灵活 未公布 FPS 需蒸馏训练 标准长度 待开源 RAVEN 训练-测试对齐 + CM-GRPO 少步(具体步数未公布) 未公布 FPS 需 RL 训练 开放式流式 待开源 Forcing-KV KV Cache 混合压缩 与基模型一致 29+ FPS (H200) 无训练推理优化 开放式长视频 待开源 SWIFT 语义注入缓存 与基模型一致 22.6 FPS (H100) 完全无训练 多 prompt 长视频 待开源 CDM 连续时间分布匹配 4 步 标准推理 需蒸馏训练 图像(待扩展视频) 已开源 SANA-WM Hybrid Linear DiT 多步(+量化加速) 34s/60s clip (5090) 需完整训练 60s 分钟级 已开源 CausalCine 内容感知记忆路由 少步(蒸馏后) 实时级 需多镜头训练 多镜头叙事 待开源 核心技术趋势 因果自回归蒸馏从 chunk-wise 4 步推向 frame-wise 1-2 步,实时交互成为现实 Causal Forcing++ 证明因果一致性蒸馏可以在 frame 粒度实现高质量 2 步生成,首帧延迟降低 50%,解锁了真正的流式交互式视频生成 训练-推理分布对齐成为自回归视频蒸馏的核心议题 RAVEN 通过 rollout 重打包直接弥合训练时 teacher history 与推理时 student rollout 的分布 gap,配合 CM-GRPO 实现端到端对齐 KV Cache 压缩与自适应记忆方案使流式视频生成在单卡上实现 20-30 FPS Forcing-KV 发现注意力头的功能特化规律(静态/动态),SWIFT 提出无训练语义注入方案,两者分别在 H200 和 H100 单卡上实现实时吞吐 世界模型正在从封闭系统走向开源、从秒级走向分钟级 SANA-WM 以 2.6B 参数 + 213K 公开视频在单卡 RTX 5090 上生成 60s 720p 视频,吞吐比闭源方案高 36 倍,标志着世界模型的算力民主化 核心技术难点与开放问题 四大核心难点 1. 少步生成的质量天花板 当采样步数降到 1-2 步,模型本质上在做'条件预测'而非'迭代去噪'。Causal Forcing++ 在 2 步下已接近 4 步水平,但与 50 步教师仍有可见差距。AnyFlow 通过 flow map 让多步时性能恢复,但 1-2 步仍是瓶颈。核心问题:少步生成的理论质量上界在哪里? 2. 长序列的累积误差与遗忘 所有 AR 模型都面临长序列退化:RAVEN 通过训练-测试对齐缓解,Forcing-KV/SWIFT 通过 cache 管理控制,CausalCine 通过 CAMR 选择性遗忘。但 1000+ 帧的真正长视频中,这些方案能否持续有效?'选择性遗忘'与'不该遗忘'之间的精确边界难以界定。 3. 蒸馏与 RL 对齐的统一 本周出现三条竞争路线:Causal CD(蒸馏为主)、AnyFlow(flow map 蒸馏)、CM-GRPO(RL 对齐)。它们解决不同层面问题但目前各自为战——是否存在一个统一框架,先 flow map 蒸馏获得任意步数能力,再 CM-GRPO 对齐到人类偏好? 4. 实时生成的硬件民主化 Forcing-KV 在 H200、SWIFT 在 H100、SANA-WM 在 RTX 5090 上实现实时/近实时。但消费级 GPU(如 RTX 4090 甚至 RTX 4060)上呢?真正的用户端实时体验需要把算力需求再降一个量级,这可能需要蒸馏+量化+剪枝+cache 压缩的全栈优化。 今日讨论 自回归视频生成已经进入'实时'门槛——Forcing-KV 29 FPS、SWIFT 22.6 FPS、Causal Forcing++ frame-wise 2 步。下一步的核心问题是:实时生成的质量天花板在哪里?当采样步数降到 1-2 步,模型本质上在做'条件预测'而非'迭代去噪',这对视觉保真度的根本影响是什么?AnyFlow 通过 flow map 让步数可伸缩、RAVEN 通过 RL 对齐推理分布——这两条路线谁更有可能统一少步和多步的质量-速度曲线? 人工智能炼丹君 整理 | 数据来源:arXiv 2026-05-11 ~ 2026-05-16 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注