


版权属于:
人工智能炼丹君
作品采用:
《
署名-非商业性使用-相同方式共享 4.0 国际 (CC BY-NC-SA 4.0)
》许可协议授权

模型:MiniMax H3
机构:MiniMax
发布时间:2026-07-31(产品发布);2026-08-02(开放权重许可日期)
资料:官方 README | 官方博客 | 技术文档 | SGLang 部署文档
协议:MiniMax H3 Community License,不是 Apache-2.0,也不是 OSI 意义上的开源协议
说明:本次只分析公开文档、配置、源码与仓库元数据,没有下载或运行模型权重。性能数字来自官方与 SGLang 文档,不等同于独立实测。
(图片来源:MiniMax H3 官方仓库)
MiniMax H3 的定位是一个通用全模态生成系统:输入可以同时包含文字、图片、视频和音频,输出是一段自带 32 kHz 立体声的视频。公开规格支持 4–15 秒、24fps、默认短边 768 像素;官方完整服务再通过一次上下文重生成,把结果提升到 2K。
简单讲,它想把过去分散在不同模型里的工作放进同一套生成语言里:
真正值得关注的不是“功能列表很长”,而是 H3 把任务关系也交给自然语言表达。人物身份来自图片、运镜来自视频、音色来自音频,这些过去要靠不同接口和控制模块硬编码;H3 先把它们写成一份结构化的多模态叙事,再交给统一 Transformer 生成。
但也要先把边界讲清楚:目前真正开放的是 768p 的 H3-Base。官方效果所依赖的 H3-Context-IR、2K 重生成和原生稀疏注意力都没有随首批权重开放。因此,“开放 H3-Base”和“本地复现官网完整 2K H3”不是一回事。
主要亮点:
f16t4d24,再做 1×2×2 patch,送入 Transformer 时等效为时间 4 倍、空间 32 倍下采样。相对弱、或者说需要保持合理预期的地方:
MiniMax 在官方博客里把演进分成三步:
过去的视频生成产品通常按任务拆模型:文生视频、图生视频、首尾帧、主体参考、动作参考、声音参考、视频编辑各走一条链。图像、视频与音频之间又是三套系统。
H3 的选择是从预训练阶段就混合这些数据与任务,并用语言描述“输入材料和目标之间是什么关系”。官方列出的预训练范围包括文生图、文生视频、文生音频、原生多镜头、图像参考与编辑、视频参考与编辑、音频参考与编辑,以及音视频到音视频的参考与编辑。
这里的关键不是把多个数据集简单拼起来。任务边界消失后,数据配比、序列长度和计算量差异都会变大。MiniMax 称加入多模态上下文后,样本序列长度方差扩大到约 3 倍,因此训练系统把“理解负载”和“生成负载”分开调度,再平衡样本内异构计算与样本间负载,端到端训练吞吐提升接近 30%。
需要注意:这 30% 是训练系统吞吐,不是生成质量提升,也不是推理提速。
官方把完整 H3 拆成三个模块:
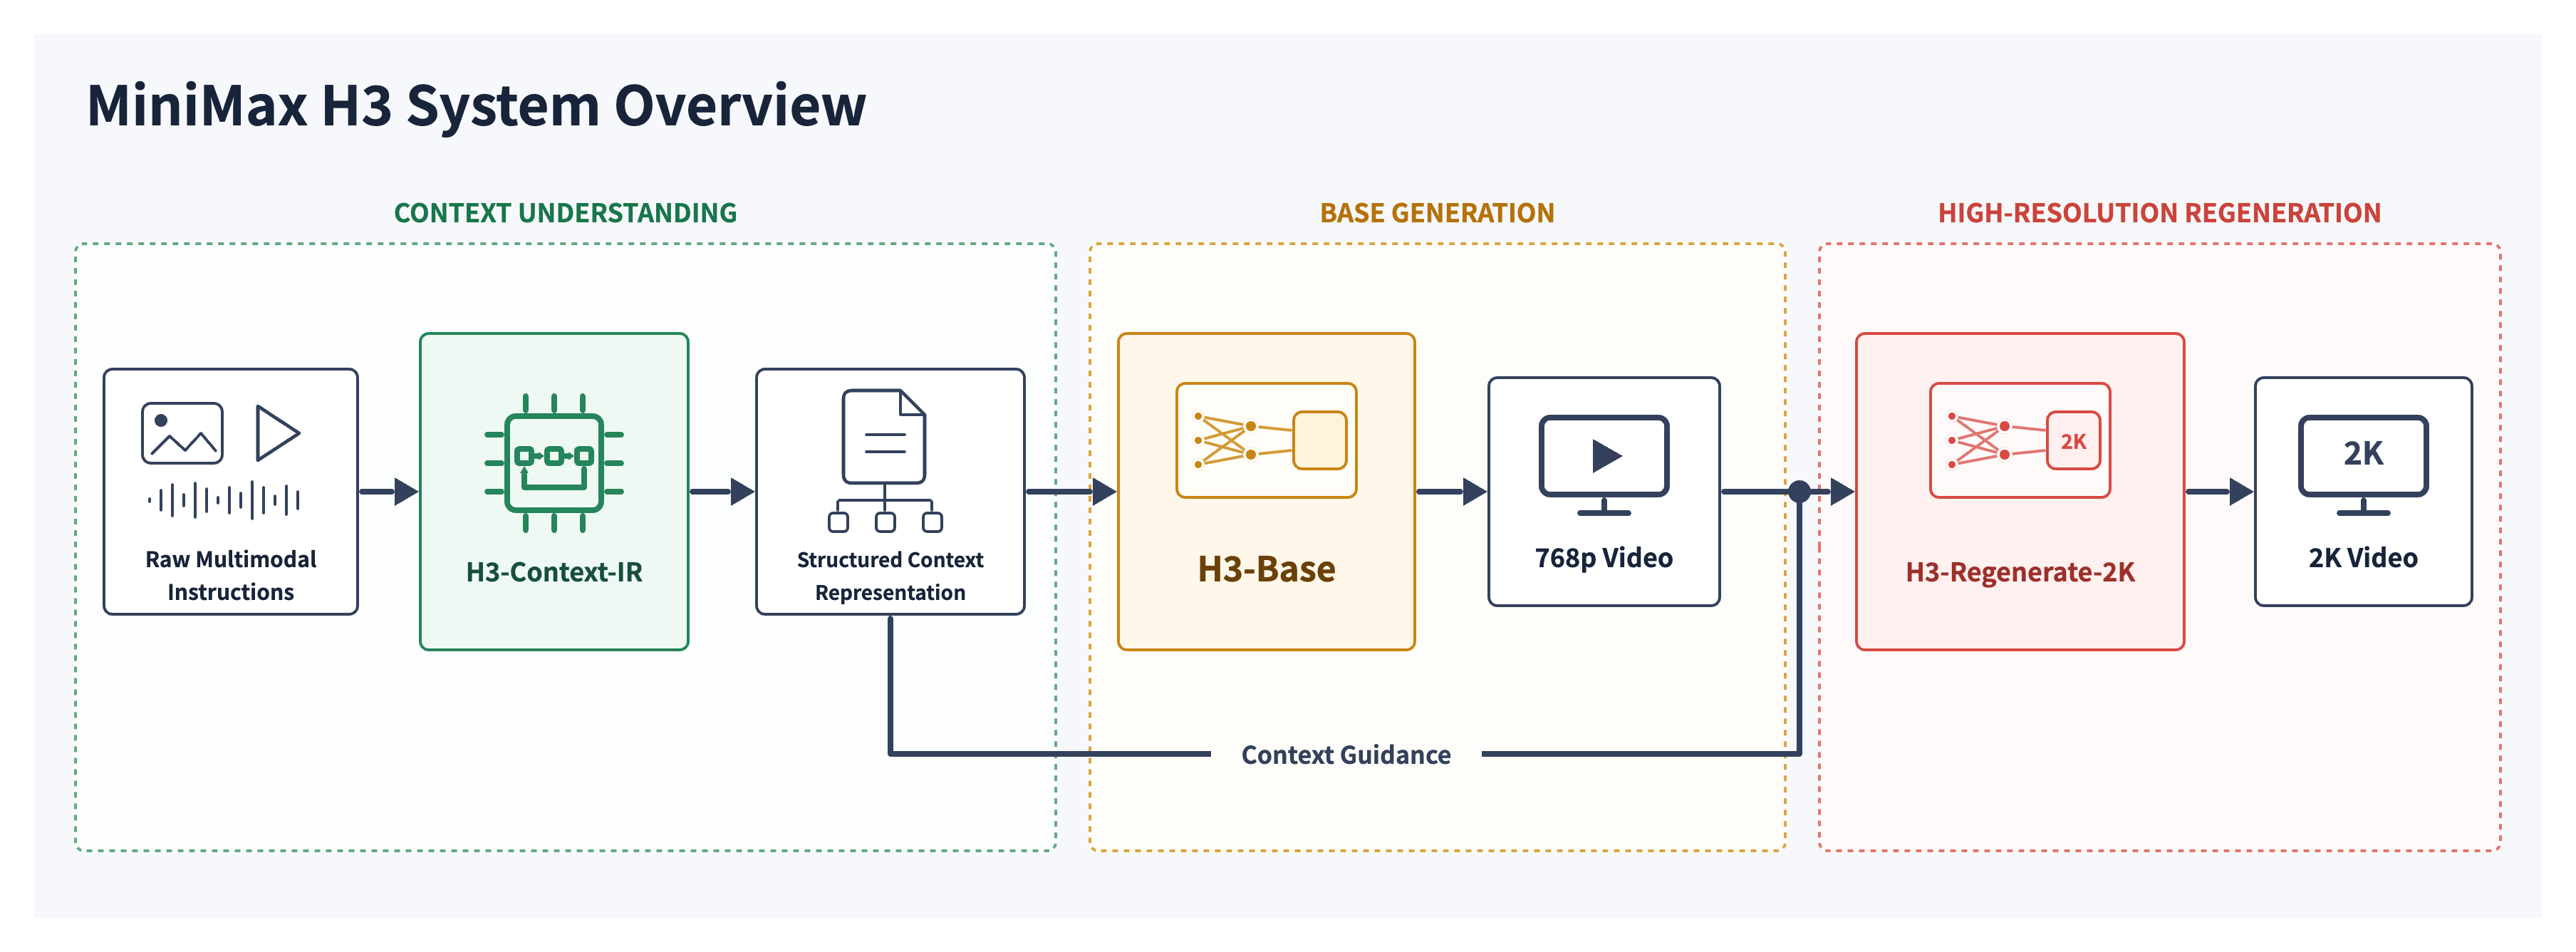
(图片来源:MiniMax H3 官方 README,System Overview)
这个拆法很重要。它说明 H3 并不是一次前向就从任意素材直接吐出 2K:
从产品角度看,这是一个“多模态编译器 + 基础生成器 + 生成式精修器”。从开源角度看,目前只开放了中间的基础生成器与相关编码/解码组件;前后两段仍需官方 API。
H3 首批开放两个任务分区,每个分区都自带文本编码器、Tokenizer、VisualVAE、AudioVAE 和专用 Omni Transformer。
| 检查点 | 适合什么任务 | 输入约束 | 输出 |
|---|---|---|---|
| H3-Base-FL2VA | 文生音视频、首帧、尾帧、首尾帧生成 | 0、1 或 2 张关键帧 | 768p 视频 + 立体声 |
| H3-Base-Ref2VA | 人物、风格、动作、镜头、视频和音频参考 | 图片≤9;视频≤3;音频≤3;混合文件≤12 | 768p 视频 + 立体声 |
FL2VA 中的图像是严格的时间锚点:
Ref2VA 的素材则是语义参考,不保证逐像素保留。输入视频可以提供动作、构图、镜头节奏或原音轨,但生成器允许重新合成、重排运动和裁切画面,也没有类似传统视频编辑的 denoising strength 控制。
这意味着:要“从这张图原样开始动”,选 FL2VA;要“参考这个人的身份或这个视频的动作”,选 Ref2VA。把两者混用,很容易得到与预期不符的构图。
(这段稍微技术一点,不感兴趣可以跳过,不影响后续阅读。)
H3-Context-IR 是整套系统最容易被低估的部分。它不是普通的 prompt 润色器,而是在做四类工作:
官方博客称,多数原始素材会触发约 100K token 量级的内部推理,最后压缩成平均约 4K token 的上下文表示。这里的“100K”指整个托管理解流水线的推理开销,不代表最终 prompt 必然有 100K token。
基础模式的 Context-IR 最终会落成三个核心字段:
integrated_multimodal_description: [Shot 1] ...

overall_soundscape: ...

non_diegetic_music: ...
第一段写画面、动作、镜头、对白和时间线;第二段写环境声、动作声和非语言人声;第三段专门写角色听不到、只有观众能听到的配乐。对白用 <d>[语言] ...</d> 包裹,说话者用稳定的 (S1)、(S2) 标识,后续镜头继续复用。
全参考模式还会增加:
subject_definitions:定义人物、图片、视频和音频标签;summary:概括这是编辑、续写、关键帧补全、音频复用还是参考生成;retention_analysis:明确哪些内容要完整保留、部分保留、只参考风格,音频是复制还是只参考音色;detailed_description:按播放顺序逐镜头写出素材在何时发挥作用。说白了,Context-IR 把一个固定任务 API,变成了可扩展的自然语言“中间代码”。这正是 H3 能统一不同任务的根。
问题也在这里:Context-IR 依赖多阶段托管模型和服务,当前没有开放。只部署 H3-Base,开发者要么调用官方 Context-IR API,要么严格照官方 prompt guide 自己搭理解与改写系统。否则同一套权重很难直接复现官网的复杂指令遵循。
H3-Base 先把不同模态分别编码,再打包进一个统一序列:
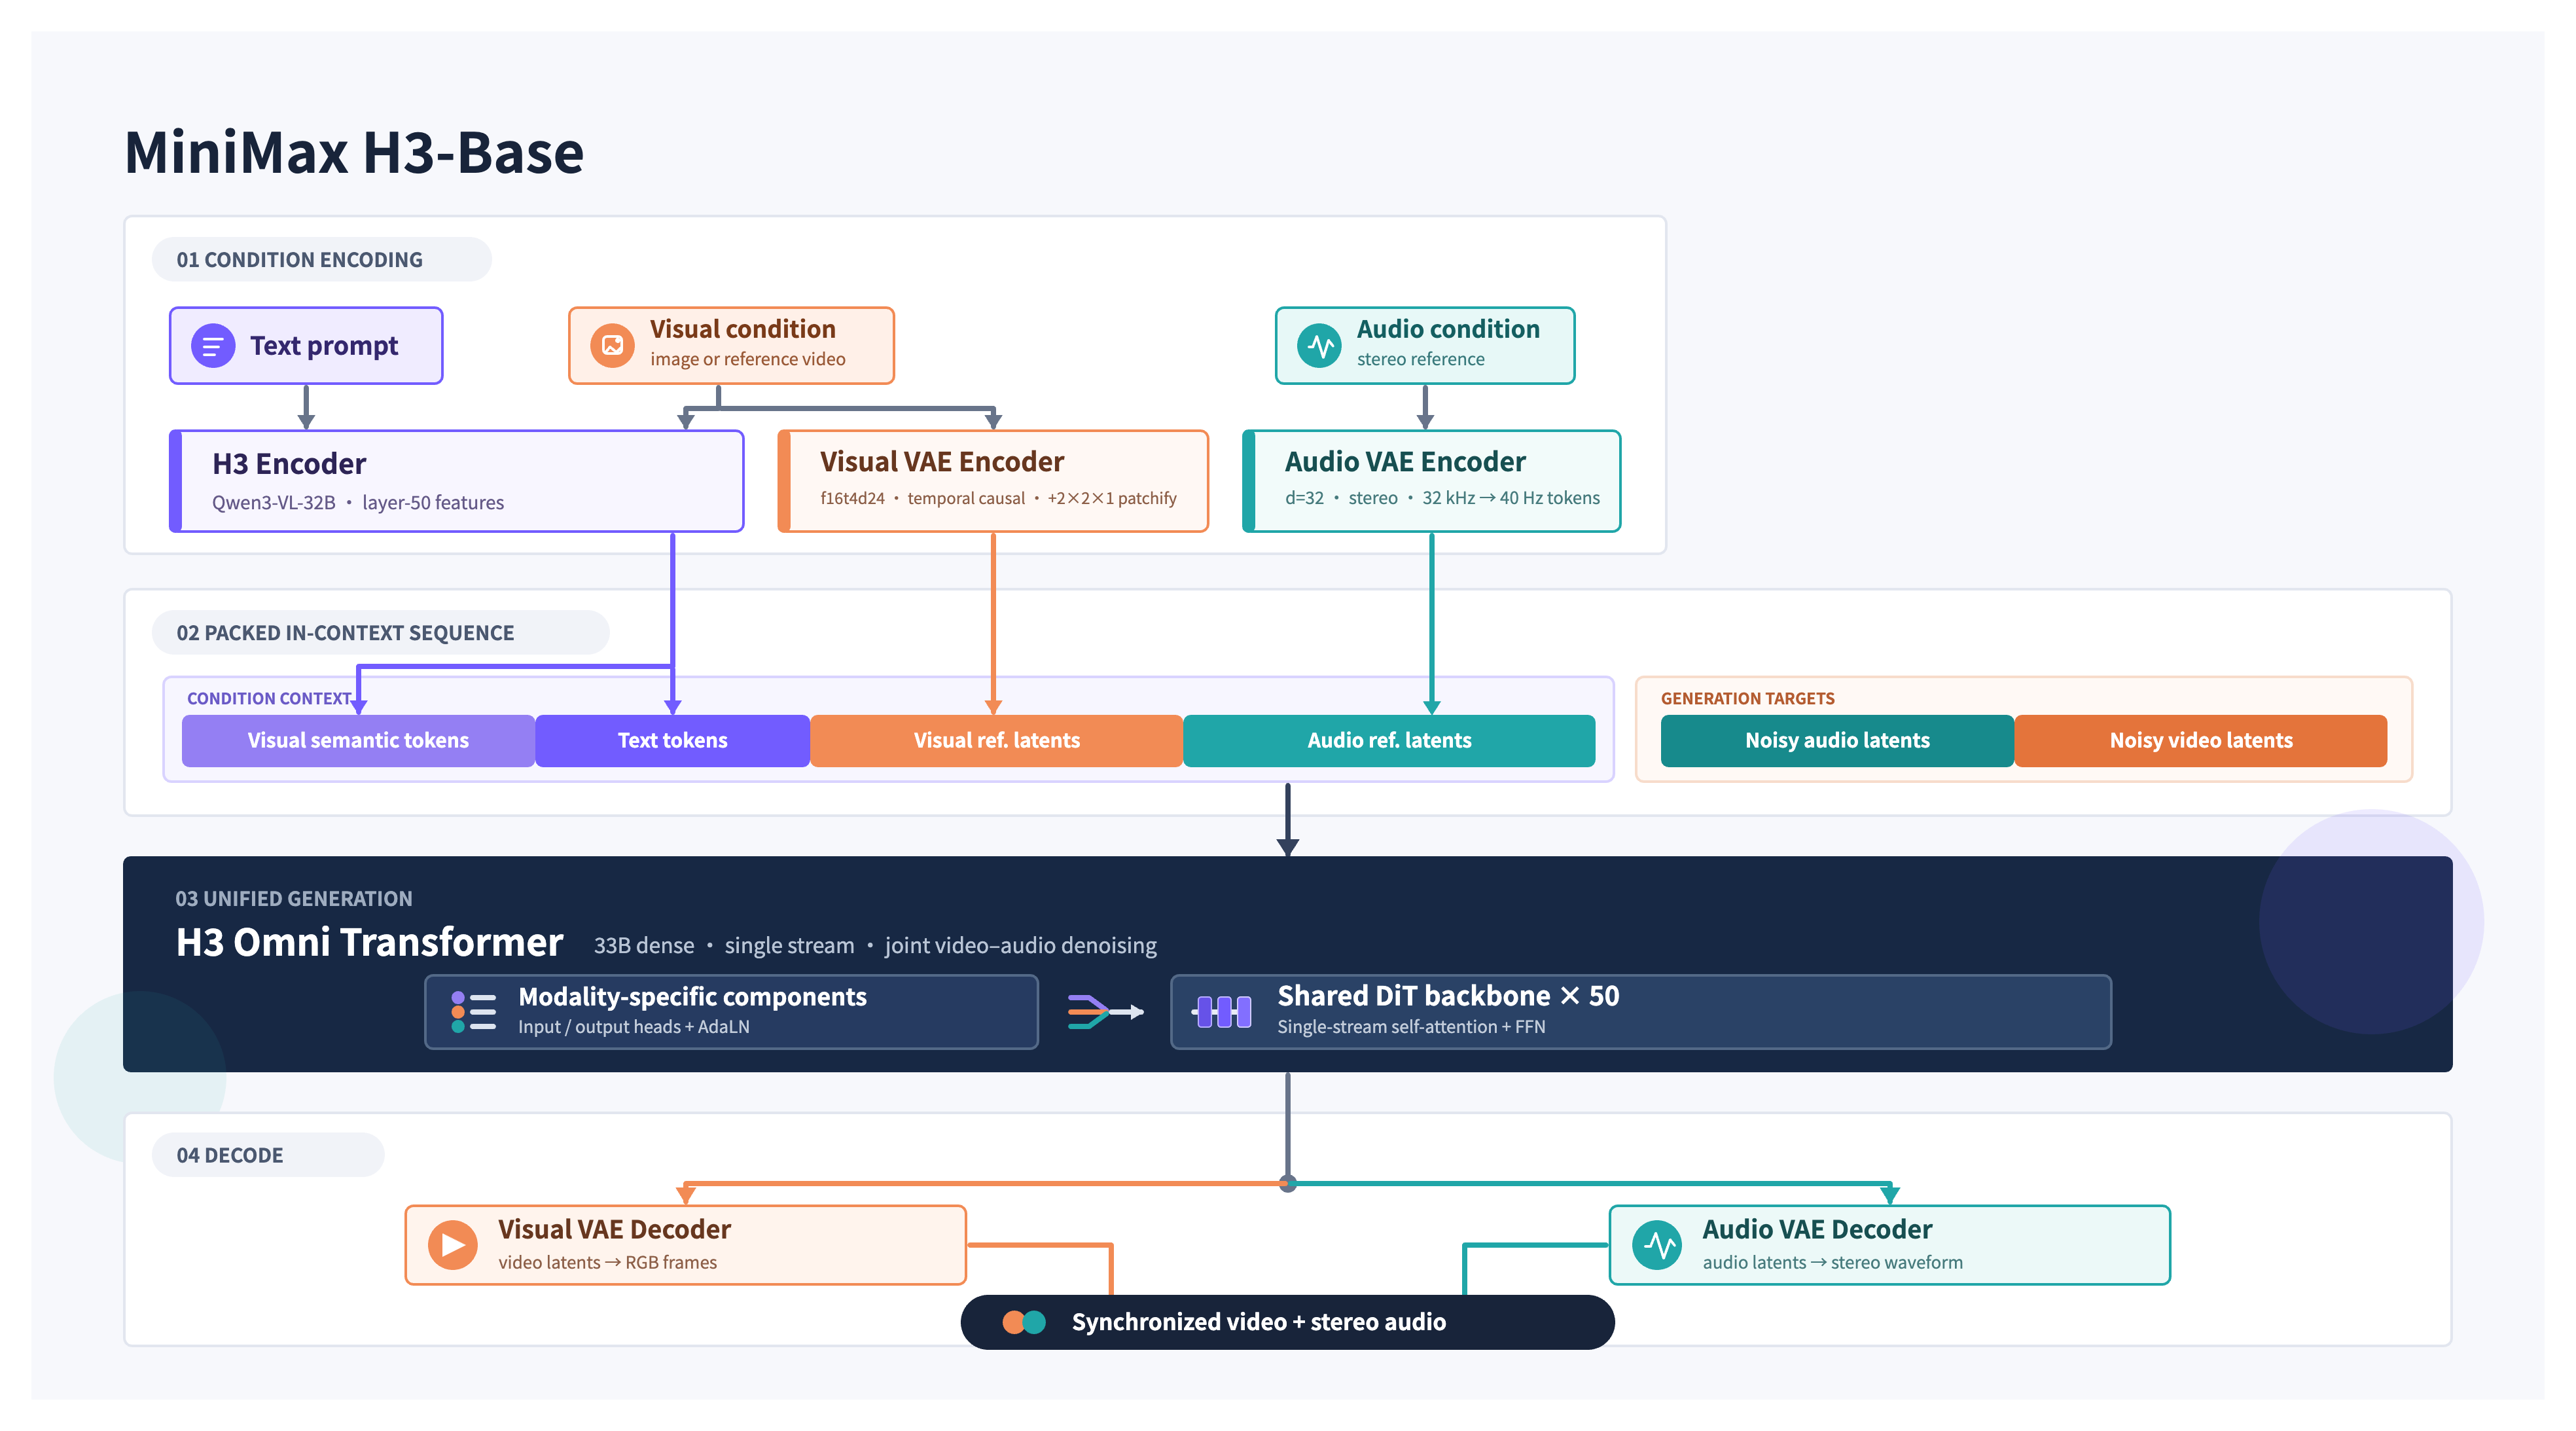
(图片来源:MiniMax H3 官方 README,H3-Base Architecture)
为什么视觉输入要编码两次?
H3-Encoder 提取的是语义信息:画面里是谁、在做什么、物体和镜头是什么关系。VisualVAE 保存的则是生成需要的细粒度外观、结构和纹理。前者适合“理解”,后者适合“照着生成”。
这也是统一多模态模型常见的一对矛盾:只用语义 token,身份和纹理容易丢;只用 VAE latent,复杂指令和关系又不容易读懂。H3 没有强迫一种表示同时承担两种职责,而是在统一序列中同时保留。
音频侧没有单独公开一个音频语言模型。H3-Base 内部主要依赖 AudioVAE latent 和 Omni Transformer 做音频条件与生成;更高层的声音关系理解,很大程度上由上游 Context-IR 负责。
H3-Encoder 直接使用完整预训练的 Qwen3-VL-32B。公开配置显示:
有意思的是,H3 不取 Qwen3-VL 最后一层,而是把第 50 层隐藏状态送给 Omni Transformer。官方没有解释原因。一个合理但尚未被报告验证的理解是:中间层保留了更丰富的视觉与语言表征,而最后几层更偏向语言生成目标;生成模型未必需要最靠近词表 logits 的特征。
H3 还给 Tokenizer 加了 <d> 等特殊 token,因此不能随便换成原版 Qwen Tokenizer。对话、演唱、镜头和参考关系都依赖这些格式约定。
从权重体积看,H3-Encoder 本身约 66.7GB BF16。所以“33B H3”只是生成 Transformer 的口径;把理解编码器和两个 VAE 都算进公开推理栈,规模远大于 33B。
H3-VisualVAE 的公开记号是 f16t4d24:
f16:高和宽各压缩 16 倍;t4:时间压缩 4 倍;d24:latent 通道数为 24。随后 H3 又把 visual latent 按 (时间, 高, 宽) = 1×2×2 patchify。因此,真正进入 Transformer 的视频 token 等效为:
1×2×2×24 = 96 个 latent 标量。拿官方 1344×768、24fps 的规格估算:15 秒有 360 帧,时间压缩后约 90 格,空间是 42×24,目标视频约有 90×42×24 = 90,720 个视觉 token。再加文字、语义视觉 token、参考图像/视频和音频,统一序列会更长。
这也解释了两个现象:
公开源码配置还透露了更多细节:
causal_encoder=true;[1, 2, 2, 4, 4, 8],每阶段 2 个残差块;VisualVAE 的 safetensors 达 10.4GB,按 BF16 粗略对应约 5.2B 参数。它不是一个可以忽略不计的小 tokenizer,ViT 解码器本身就是部署开销的重要来源。
另外,配置中存有 24 组 latents_mean 和 latents_std。生成前对每个 latent 通道单独标准化,有助于把方差差异很大的视觉通道拉到更容易学习的范围。H3 官方强调 VAE 不只追求重建质量,也追求“让生成模型好学”,这些统计量就是具体证据之一。
AudioVAE 的设计相对清晰:
公开 metadata 中,编码器下采样率为 [2, 4, 4, 5, 5],乘起来正好是 800。32000 / 800 = 40,因此每个 latent 时间步覆盖每声道 800 个原始采样点。15 秒音频每声道只有 600 个 latent 时间步。
解码器倍率 [5, 5, 2, 2, 2, 2, 2] 同样乘到 800。其内部使用 64 维起始编码器、1024 维 BigVGAN 解码器、2048 维内部 latent 投影,再压到对外的 32 通道 VAE latent。公开 AudioVAE 权重约 0.605GB,粗略对应 0.3B 参数。
左右声道独立经过同一个 VAE,有两个好处:参数共享,且天然兼容单声道表示。但声道间的相位、时差和声像关系不能靠 VAE 内部跨声道卷积建模,必须由 Omni Transformer 在联合 latent 层生成正确的左右声道关系。这也是“原生立体声”真正困难的地方。
和视觉 VAE 一样,AudioVAE 配置给出了 32 组通道均值与标准差。音频、视频 latent 的分布完全不同,如果直接塞进一个扩散模型,梯度和噪声尺度很容易失衡;逐通道归一化是统一生成能稳定训练的基础操作。
H3-Omni-Transformer 是一个 33B、稠密、单流、50 层的 Diffusion Transformer。公开配置如下:
| 配置项 | 数值 | 含义 |
|---|---|---|
| hidden size | 5376 | 主干 token 宽度 |
| layers | 50 | 共享 DiT Block 数 |
| attention heads | 56 | 注意力头数 |
| head dim | 128 | 单头维度 |
| attention inner dim | 7168 | 56×128,比主干宽 4/3 |
| FFN hidden | 14336 | 主干宽度的 8/3 |
| token refiner | 2 层 | 主干前的条件 token 精炼 |
| text input dim | 5120 | 对接 Qwen3-VL |
| video latent dim | 24 | 对接 VisualVAE |
| audio latent dim | 32 | 对接 AudioVAE |
| video patch | 1×2×2 | 每个视频 token 含 96 个 latent 值 |
注意力内部维度是 7168,比 5376 主干宽度更大,属于“宽注意力”;FFN 则是 14336。按权重索引里的 qkv_proj/out_proj 与门控 FFN 结构粗算:
4 × 5376 × 7168 = 154.1M 参数;3 × 5376 × 14336 = 231.2M 参数;剩下那一大块在哪里?答案是 AdaLN。
配置中的 time_embed_dim=2688、adaln_out_features=96768,而 96768 = 18 × 5376。如果每层都用 2688 维时间/条件向量投影到 96768 维调制量,那么:
2688 × 96768 × 50 ≈ 13.01B
这与官方“约 13B 参数位于 AdaLN 相关分支”完全吻合。再加输入输出投影、两层 token refiner、归一化和偏置,总量就落在约 33B。
这里的 18 组隐藏维调制量,很可能对应条件、音频、视频等 token 类型在注意力与 FFN 中的 shift、scale、gate 组合;但完整 Transformer 源码尚未公开,所以这部分只能称为配置层面的推断,不能当作官方确认。
AdaLN 分支还有一个工程优势:官方称其调制输出可以预计算并缓存,因此纯推理部署不一定要常驻加载这约 13B 参数。按 BF16 算,理论上可减少约 26GB 权重驻留。需要微调、改变调度或重新计算调制时,完整权重仍然有价值,所以仓库发布的是全量 33B。
H3 没有把音频生成器挂在视频生成器后面。它把以下 token 打成一个 packed sequence:
主干的注意力层与 FFN 没有音频专用或视频专用结构,所有 token 使用同一套共享参数。模态差异主要留在输入/输出投影和 AdaLN 分支中。
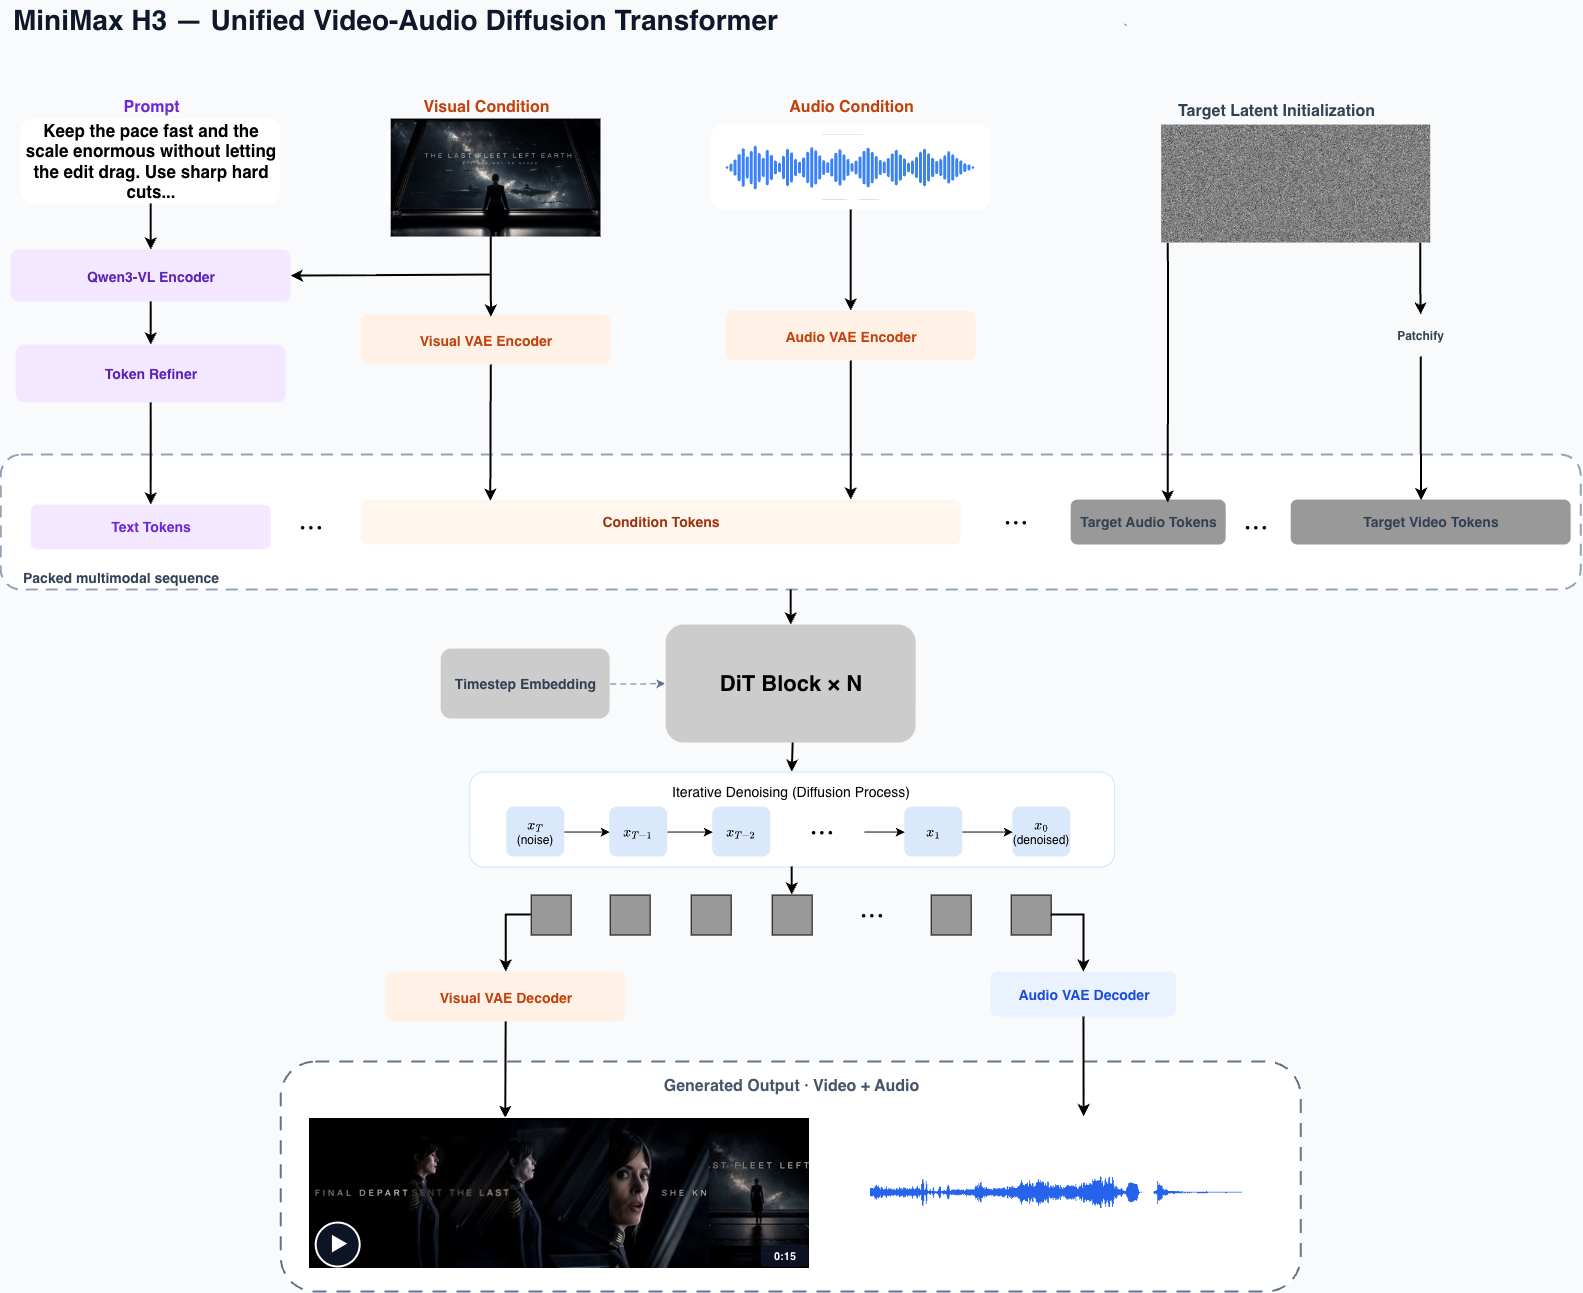
(图片来源:MiniMax H3 官方公开架构图)
这种设计让嘴型、对白、动作声和镜头变化可以在每一层互相看见。例如角色开口时,视频 token 的嘴部运动能关注对应音频时间段;爆炸发生时,音频 latent 也能看到画面中的事件状态。同步不是后处理对齐,而是在联合去噪轨迹里一起形成。
H3 使用三维 MM-RoPE 表示 (t, h, w)。视频 token 有完整的时空坐标,音频和文字则通过打包段与时间关系接入统一注意力。公开配置给出 rope_inv_freq_len=16,但没有披露不同模态如何分配频率维度。
模型索引里还有两个容易忽略的参数:
flow_shift = 12.0;audio_flow_shift = 3.0。官方复现实例默认使用 50 个推理步。视频与音频虽然联合去噪,但 latent 统计与生成难度不同,因此使用不同的 flow shift 校准各自噪声轨迹。模型索引甚至把 scheduler 写成 null,说明调度逻辑由 H3 专用 pipeline 管理,而不是直接套一个通用 Diffusers scheduler。
首批检查点还做了 CFG distillation。这不等于“几步生成”:官方示例仍是 50 步。它的意义是推理时只跑单个去噪分支,不再对有条件/无条件各跑一次。SGLang 也明确禁止为 H3 开启 CFG parallel,因为复制正向分支只会浪费算力。
VisualVAE 已经把视频 token 压得很狠,但长视频、多参考仍会把 packed sequence 推到数万甚至十万 token。全注意力的计算与显存随序列长度近似二次增长,15 秒比 5 秒远不只是慢 3 倍。
MiniMax 在训练最后阶段加入了原生稀疏注意力,官方称 H3 从架构上支持稀疏注意力训练与推理。但首批开放实现只提供全注意力,稀疏版本承诺后续发布。
这意味着当前开放版有一个明显落差:
第三方框架可以用 Cache-DiT、序列并行、张量并行等手段降成本,但这些不是官方原生稀疏注意力的等价替代。Cache-DiT 会复用相邻步特征,速度更快但会改变同 seed 轨迹;序列并行则主要把长序列分摊到多卡,并没有消灭总计算。
传统超分只看到低分辨率结果。小字已经糊成几个色块时,超分模型只能猜;原 prompt 里品牌名、材质和参考图信息通常已经丢了。
H3-Regenerate-2K 的做法不同:把 768p 结果连同最初的文字、图片、视频和音频上下文再次送进 H3,让基础模型在完整条件下重生成高分辨率视频。
优势是:
代价也很直接:这是再生成,不是确定性插值。它有机会修回细节,也有机会改动原有纹理、文字笔画或局部运动。官方目前没有公开 768p→2K 的一致性、文字准确率与时序稳定性消融。
最重要的现实边界是:H3-Regenerate-2K 尚未开源。完整 2K 工作流要把本地 H3-Base 与官方 Context-IR、Regenerate-2K API 串起来。官网宣传的“默认 2K”是服务能力,不是首批开放权重单独具备的本地能力。
通过 Hugging Face 仓库元数据统计,Ref2VA 单个自包含检查点的 safetensors 体积如下:
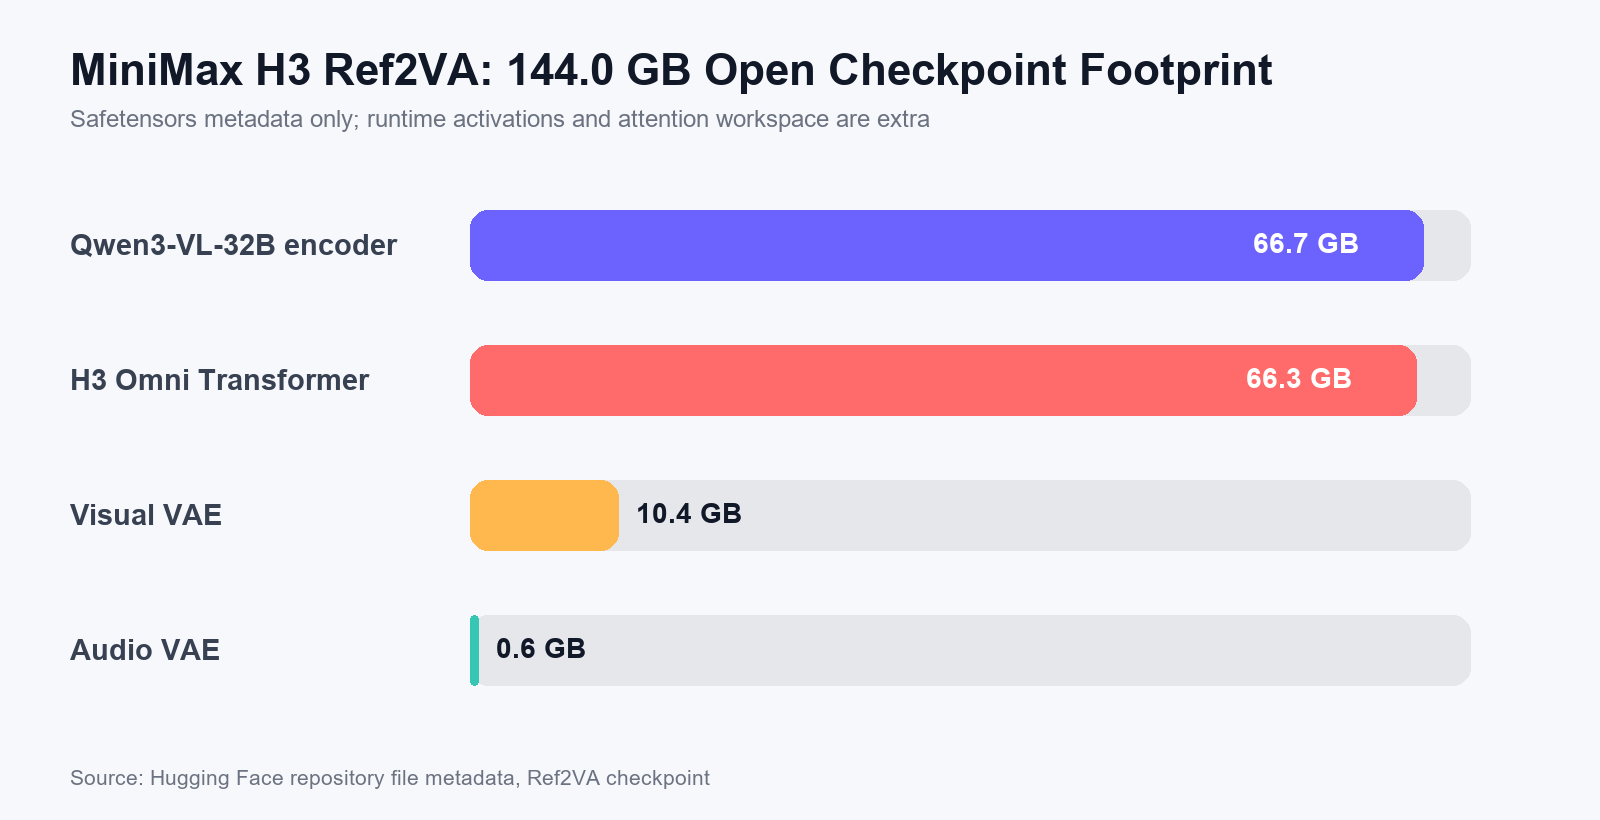
(数据来源:MiniMax H3 Hugging Face 仓库文件元数据;仅为权重文件体积,不含运行时激活与工作区)
| 组件 | BF16 权重体积 | 粗略参数规模 |
|---|---|---|
| Qwen3-VL-32B 编码器 | 66.715GB | 约 32B |
| H3 Omni Transformer | 66.280GB | 约 33B |
| VisualVAE | 10.416GB | 约 5.2B |
| AudioVAE | 0.605GB | 约 0.3B |
| 合计 | 144.016GB | 约 70B 组件参数 |
FL2VA 也是约 144.016GB。两个分区各自完整打包同类组件,如果整仓库两套全取,safetensors 合计约 288GB。
官方 README 的 SGLang 示例使用 4 张 GPU。更细的 SGLang 验证结果显示:
消费卡数字尤其值得看清:SGLang 的 2×RTX 5090 验证中,标准 50 步、1344×768、5 秒请求耗时 559.67 秒,其中去噪 525.05 秒、解码 33.61 秒,峰值约 26.3GiB/卡。改成 5 步时约 78.11 秒,但这不是与标准 50 步等价的质量设置。
所以目前更准确的判断是:
另外,SGLang 当前不建议用 torch.compile 生成一致性基准,因为文档称现有编译路径会改变数值输出。B200/B300 支持在线 FP8,但它是近似量化,音频和视频质量都需要重新验证。
官方提供了 T2VA、FL2VA 和 Ref2VA 的可复现 768p 样例。下面三张是对应公开视频在约 2 秒处的抽帧。
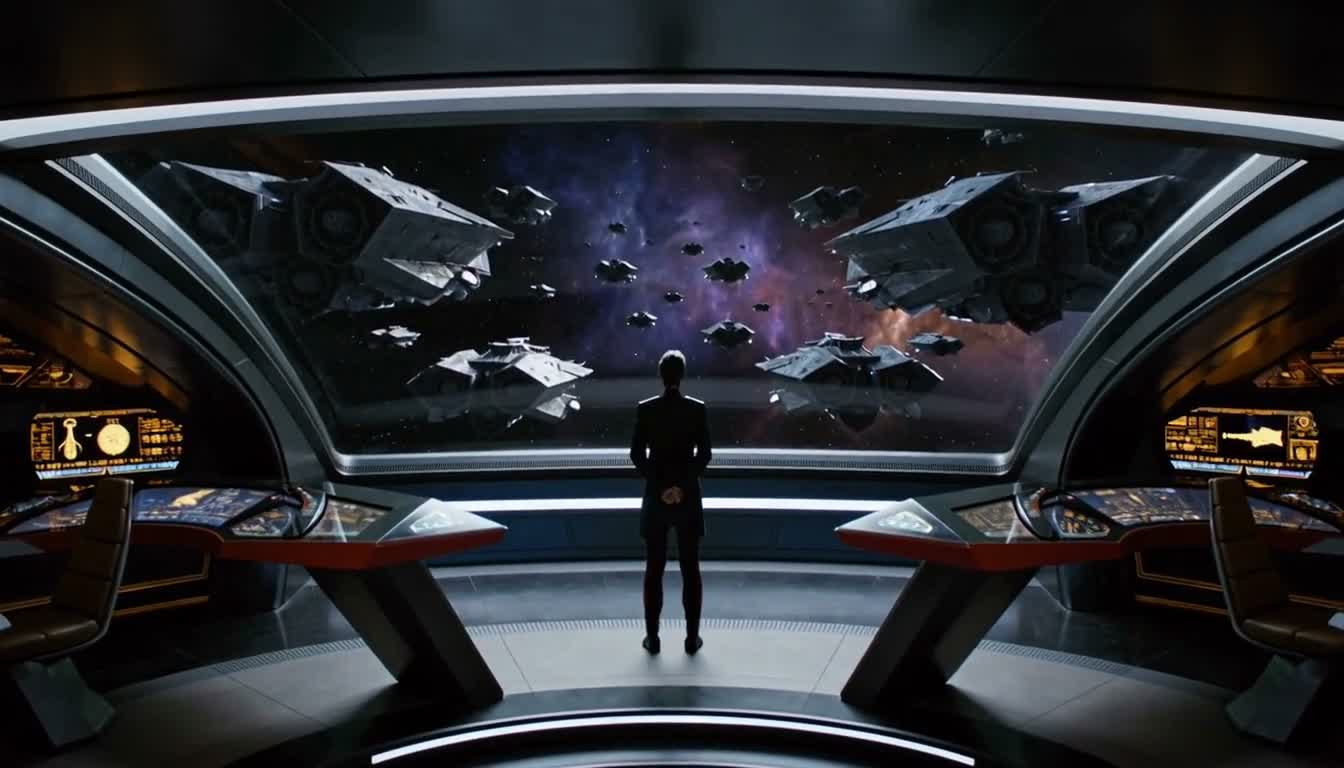
(图片来源:MiniMax H3 官方 T2VA 示例视频抽帧;原视频为 1344×768、24fps、32 kHz 立体声)
T2VA 样例展示了多镜头、复杂光照与空间歌剧音效,主要体现 Context-IR 对镜头与声音层次的组织目标,而不只是单帧画质。
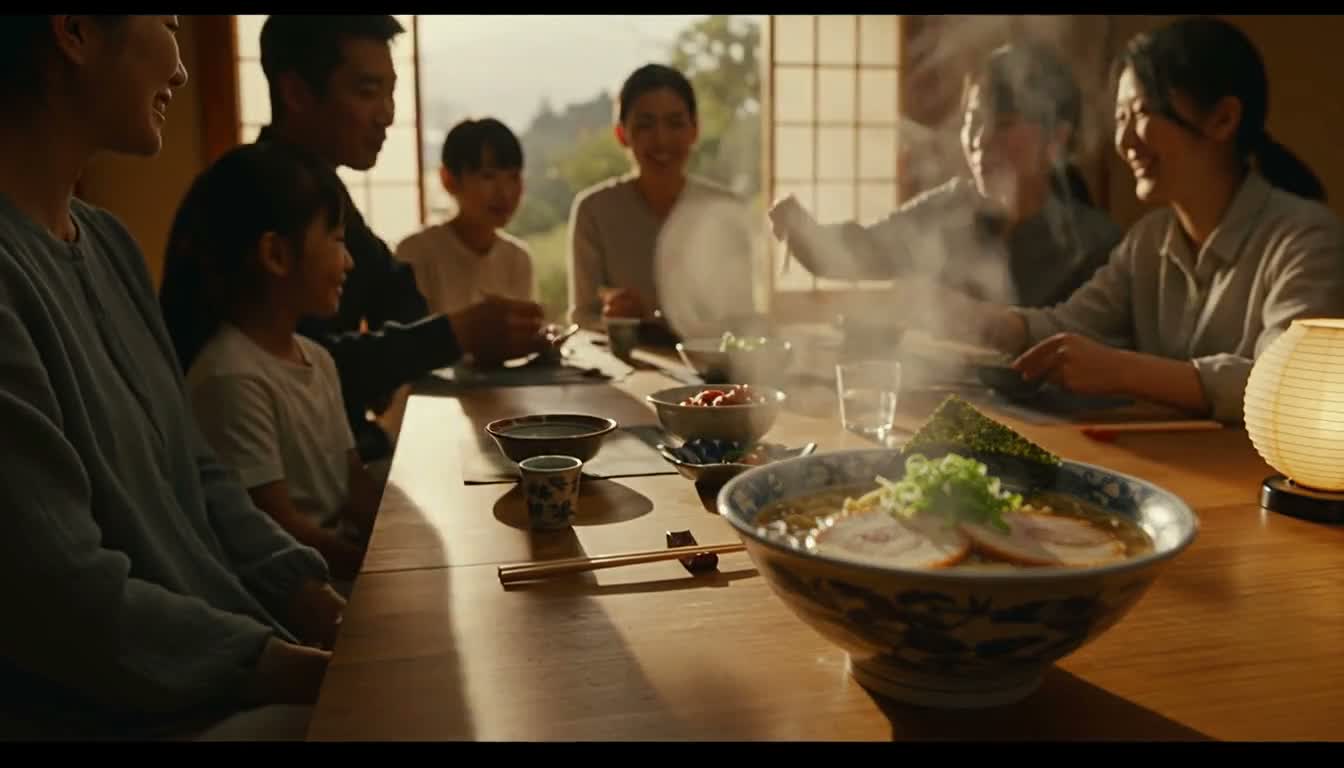
(图片来源:MiniMax H3 官方首/尾帧模式示例视频抽帧)
FL2VA 样例重点是关键帧之间的运动路径。此模式要求参考图成为真正的端点,比“只参考人物风格”更强约束。
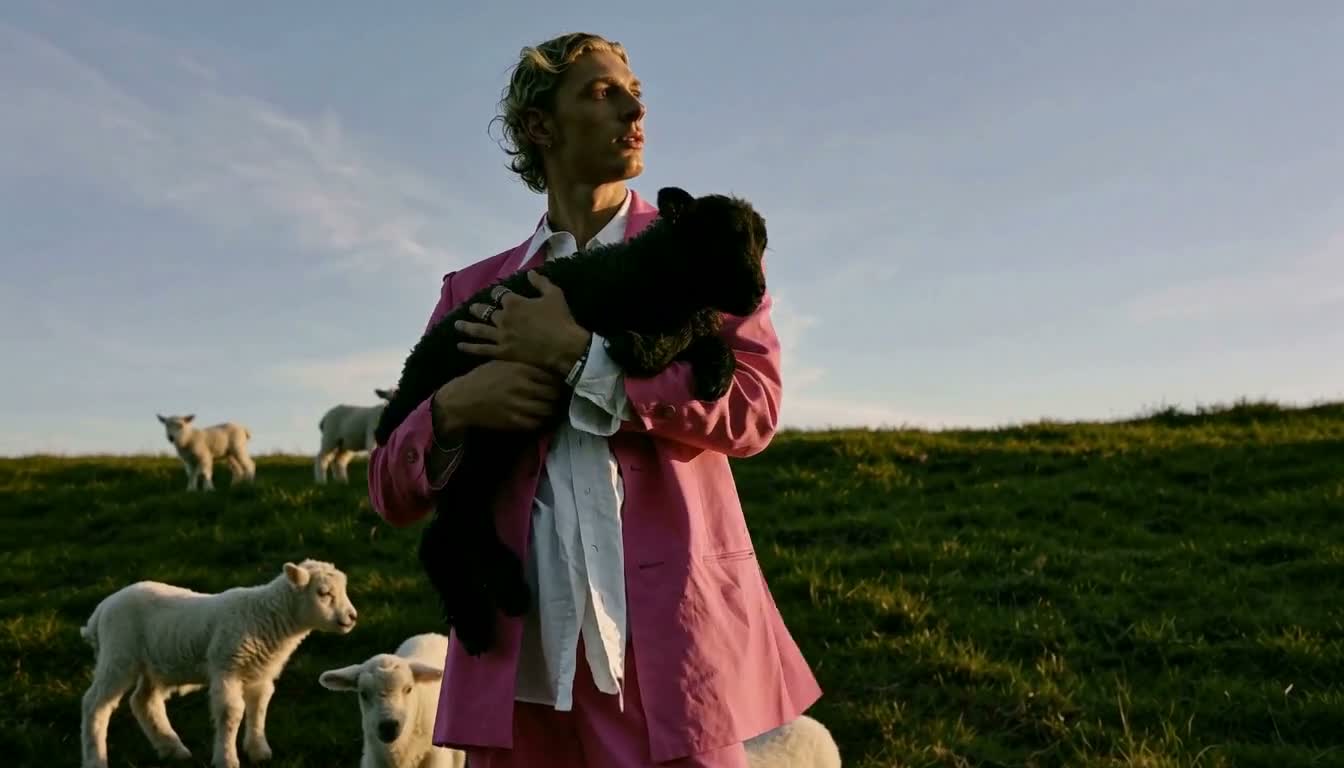
(图片来源:MiniMax H3 官方 Ref2VA 示例视频抽帧)
Ref2VA 样例把源视频画面、背景音乐和另一段男性音色组合起来,让角色说新台词。它体现了 H3 最有差异化的地方:引用的不是一个“风格 embedding”,而是多个素材各自承担不同关系。
但这些仍是发布方选择的展示案例。官方博客称 H3 在指令遵循、文字与品牌渲染、V2V 动作迁移上表现突出,并称 2K 每秒价格低于主流模型的三分之一、768p 价格低于主流 720p 的一半;发布材料没有给出“主流模型”的明确名单、统一测试协议和原始评分,因此这些口径适合看产品定位,不适合当学术 Benchmark。
如果不调用官方 Context-IR,prompt 不能只写一句“电影感,一个人在唱歌”。官方指南实际要求把视频当成一条可执行时间线。
基础模式建议至少写清:
[Shot N] 镜头编号;首尾帧模式重点不是重复描述两张静态图,而是写清“从第一张怎样连续变化到第二张”。Ref2VA 则要先定义每个素材的角色:
<Subject 1>:人物身份来自 Picture 1
<Video 1>:提供动作与镜头节奏
<Audio 1>:只参考音色,不复制原台词

retention_analysis:
<Subject 1>: fully_preserved
<Video 1>: reference
<Audio 1>: reference
这里还有几个实用细节:
<d> 后必须保留用户原文,不能擅自翻译;<scenetrans> 表示连续。H3 的 prompt 之所以长,不是“堆形容词”,而是在用自然语言写一个带音轨的分镜脚本。对复杂任务而言,这比为每一种控制关系设计独立参数更能扩展;代价是必须有一个强大的上游理解与编排系统。
MiniMax H3 Community License 的适用范围是“全球,但排除欧盟、英国、韩国和美国”。这些被排除地区需要另行申请授权。API 因由 MiniMax 托管并实施安全措施,可以采用不同的全球可用策略。
还需要注意几条:
Qwen3-VL-32B 编码器本身采用 Apache-2.0,但这不等于整个 H3 都是 Apache-2.0。模型主体、衍生权重与使用行为仍受 H3 Community License 约束。
因此,H3 更准确的描述是“开放权重的社区许可模型”,而不是“无地域、无用途限制的开源软件”。准备商用前应直接审核许可证原文,不能只看模型卡上的 Open Weights 宣传。
完整技术报告尚未发布,以下问题现在没有可靠答案:
在这些信息补齐前,H3 最能被验证的是“开放基础栈的结构与可部署性”,而不是所有宣传能力的平均质量。
H3 的架构没有追求很多花哨的模态专用 Block。它真正押注的是另一件事:让语言成为图像、视频、声音与任务关系的通用中间层,再让一套共享 Transformer 在同一时间线上生成音画。
这条路线有三个很强的信号:
工程上,H3 也非常“重”:约 144GB 的单分区公开权重、5B 级 VisualVAE、数万 token 的全注意力序列;SGLang 已验证的双 RTX 5090 路径还需要约 384GiB 主机内存做逐层 offload。它能开放已经有价值,但离人人本地实时生成仍有明显距离。
我的判断是:H3 当前最适合三类人。
如果后续技术报告公开了训练配比、稀疏注意力和 2K 重生成消融,H3 的技术价值会更容易被准确评估。就首批资料而言,它已经不是“再做一个视频模型”,而是在尝试把多模态内容生产从一组孤立工具,变成一个可以用语言编排的统一生成系统。
作者:人工智能炼丹君
日期:2026-08-03
声明:个人观点,仅供参考。架构与参数分析来自公开配置、源码和仓库元数据;质量与性能数字来自官方或第三方部署文档,如有更新以原始资料为准。



评论 (0)