搜索到
27
篇与
音频生成
的结果
-
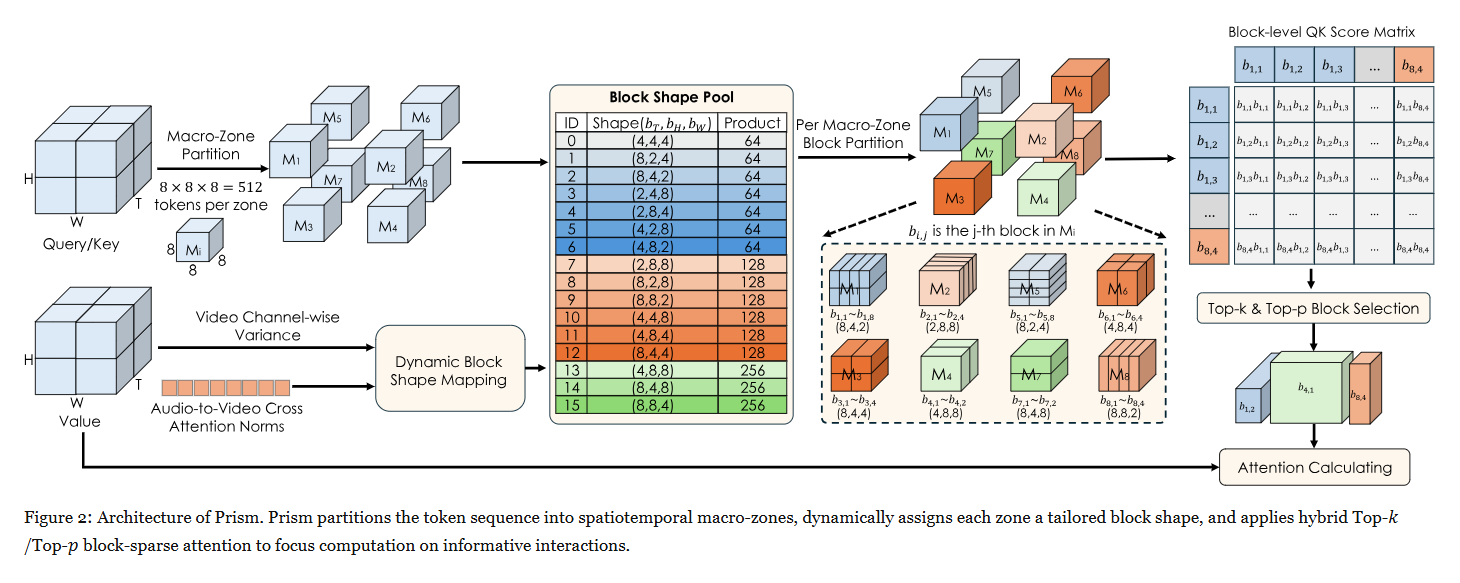
 AIGC 每日速读|2026-10-07|腾讯原生2K音画训练快2.5倍Prism 今日 AIGC 论文速览 今日共 10 篇 · 音画与流式声音生成 2 篇 · 规则一致性与四维世界 2 篇 · 图像生成与连续编辑 2 篇 · 视频编辑与推理加速 3 篇 · 结构可控声音变形 1 篇 重点论文标题列表 Prism(腾讯):原生二千像素音画训练提速 S2PD(剑桥):先串行推演再并行修画面 PVD(港理工):两个半身专家接力生成图像 WorldSonus(港科大):世界画面逐段配上立体声音 ALIVE(罗切斯特):插入的物体跟着人物互动 今日论文速览 1. Prism:原生二千像素音画训练提速 Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Generation Model Training | 腾讯混元;复旦大学;浙江大学 | arXiv:2610.05416 关键词:联合音画生成, 原生2K训练, 动态稀疏注意力, 跨模态引导 前序问题:2K 视频的 token 数量让全注意力训练昂贵,先生成低分辨率再超分又难补回原生细节。固定稀疏块还可能把不同运动方向或关键发声区域混在一起,省了计算却损伤动作与声音对应。 本文贡献:Prism 在 MOVA 双分支 DiT 中替换视频自注意力,保留音频与跨模态注意力。先划分 8×8×8 时空宏区,结合视频特征通道方差和音频到视频交叉注意力范数,为各区选择 64、128 或 256 token 的块形状;再用 Top-k/Top-p 混合策略分配注意力预算。稀疏布局适应空间结构和音画耦合,而非统一删去固定区域。 论文 Figure 2:Prism 架构。把 token 序列划分为时空宏区,动态给各宏区指定适配的块形状,再以 Top-k/Top-p 混合块稀疏注意力把计算集中到信息量高的交互。 实验效果:作者在十万条 2K 视频上训练,报告原生 2K 联合音画训练加速 2.5 倍。表 2 的 95% 稀疏配置相对全注意力训练:cpCER 从 0.374 降到 0.187,DeSync 从 1.05 降到 0.63,MotionQ 从 0.53 升到 0.89。2K-Bench 为 300 条未见的十秒视频;训练吞吐与这些质量指标是两类证据。 论文 Figure 3:与此前开源方法的定性比较。音频必须参看项目演示视频,更多结果见附录 A.7;此静态图展示视频画面,不单独证明音频质量。 批判点评:2.5 倍不能移写成端到端生成速度,95% 稀疏也不等于整个模型少算 95%。静态截图无法核对音频,须结合项目音画演示。自建测试集和自动评价不代表所有镜头、说话人与低分辨率任务都同样获益。项目页与官方代码给出复现入口。 2. S2PD:先串行推演再并行修画面 S2PD: Serial-to-Parallel Diffusion for Physically and Logically Consistent Video Generation | 剑桥大学;丰田欧洲 | arXiv:2610.06847 关键词:视频扩散, 串并行采样, 物理一致性, 游戏规则 前序问题:即使不断采样程序生成的训练数据,并行视频扩散仍会生成违规棋步、错误碰撞或不连贯物体。问题可能在于模型缺少逐段协调事件的串行计算,而不只是数据不够。 本文贡献:Serial-to-Parallel Diffusion 在高噪声阶段按时间块自回归去噪,先协调相互依赖的事件;到较低噪声再切换为整段并行细化,减少纯串行采样的闪烁。训练使用多种块大小;实验在从零训练的 DiT-B 与 Wan-5B-LoRA 上,按匹配训练预算比较双向并行、因果 Diffusion Forcing 和 Block Causal。 论文 Figure 2:各方法的注意力模式与本文采样策略。(a–c)分别为双向、因果 Diffusion Forcing(cDF)与 Block Causal(BC)的注意力掩码及噪声水平;(d)先串行去噪再并行细化;(e)时间切片内部的 token 顺序;(f)训练使用多种块大小。 实验效果:表 2:DiT-B 的 2048 每次 rollout 非法转移从并行基线 47.9 降到 0.9,双摆动力学误差从 73.4 降到 1.1;Wan 的 Kubric MOVi-A CD-FVD 从 252.8 降到 137.0。国际象棋则为 51.0→12.3,仍逊于另两种串行方法的 4.6 和 6.8,不能写成全任务最优。 论文 Figure 6:Wan-5B-LoRA 架构的定性比较。在 MPMWorlds 与真实魔方数据集上,串行方法表现相近,相比双向基线生成更连贯的视频。 批判点评:程序世界中的规则错误减少,不是开放世界物理定律的保证。串行块越小通常越慢,表 4 显示质量和采样成本需一起调;混合方法相对纯并行也有额外串行开销。建议先检查自己的事件依赖是否需要串行推演。项目页可核验,本文不使用未经确认的会议接收背书。 3. PVD:两个半身专家接力生成图像 Two Halves are More than One: Phase-wise Velocity Distillation for Fast and High-Quality Image Generation | 香港理工大学;OPPO研究院 | arXiv:2610.08070 关键词:图像生成, 分阶段蒸馏, 平均速度, 显存压缩 前序问题:粗结构与细节生成发生在不同噪声区间,却常由同一个完整学生网络承担。压到一次完整主干计算预算时,统一学生容易兼顾不好两个阶段;少步模型也未必减少活跃参数或显存。 本文贡献:Phase-wise Velocity Distillation 从教师抽取约半深度主干,先用 flow matching 对齐初始化,再学习粗到细两个区间的平均速度;文生图采用共享冻结主干与阶段 LoRA,并加阶段判别器做对抗细化。两个半身专家依次执行,累计 FLOPs 约等于一次完整教师主干前向,但实际仍是两次专家调用。 论文 Figure 3:PVD 总览。(a)从教师抽取半身主干,经 flow matching 微调初始化局部学生;(b)分阶段 LoRA 专家在划分的时间区间上学习平均速度;(c)文生图任务使用分阶段判别器进行对抗细化。 实验效果:表 1 的 ImageNet 256×256、归一化计算预算 1.00 下,PVD FID-50K 为 1.48,iMF 为 1.72,多步 LightningDiT 为 1.35。表 3 的 Qwen-Image 蒸馏:活跃参数 20.43B→10.40B,峰值显存 38.42→19.84 GiB,减少 48.36%;GenEval 为 0.8720→0.8846。 论文 Figure 1:文生图结果。上排为教师:Stable Diffusion 3.5-Medium、FLUX.1-dev、Qwen-Image,分别使用 50×2、50、50×2 步;下排以两个半身分阶段专家顺序生成,累计计算约等于一次完整教师主干前向。这是计算预算比较,不能读成只调用一个专家。 批判点评:活跃参数不是所有权重总量,等 FLOPs 也不是已实测的一倍调用延迟。Qwen 的 DPG 从 89.10 降到 86.54,WISE 从 0.64 降到 0.59,质量没有全面超过教师;密集计数和罕见布局仍困难。可从官方仓库核对权重与实现,再按具体 GPU 测显存及延迟。 4. WorldSonus:世界画面逐段配上立体声音 WorldSonus: Bringing Sound to Worlds | 香港科技大学;Noiz AI;沐曦;上海交通大学 | arXiv:2610.08760 关键词:视频到音频, 因果流式生成, 立体声, 交互提示 前序问题:交互视频的未来画面尚未产生,双向配音不能等待整段视频再工作。声音还要随左右位置与用户文字控制变化,同时维持跨块连续性。 本文贡献:WorldSonus 用因果自回归 Transformer 与 rectified-flow 头,逐块输出 48 kHz 立体声。两种时间尺度的视觉 token 同时提供场景计划与帧级线索,环形 KV 缓存限制历史长度;提示词在块边界更新。训练用冻结 Synchformer 的 ShiftNCE 做时间对齐,结合真实立体声筛选和全景一阶 Ambisonics 的视角解码学习方向,教师只在训练使用。 论文 Figure 1:WorldSonus 总览。(a)因果流式流程:视频映射为两种时间尺度的视觉 token,条件化自回归 Transformer 和 rectified-flow 头;(b)训练专用 ShiftNCE:冻结 Synchformer 教师以对比窗口匹配指导时间对齐;(c)立体声空间监督:真实立体声筛选与全景一阶 Ambisonics 视角解码提供方向依据;(d)交互文字控制:在块边界动态更新提示,保留会话状态和声学连续性。 实验效果:表 1 的单 H100 设置中,100 ms 音频块计算为 41.2 ms,实时因子约 0.41。VGG 五秒测试 FAD 为 1.73,PrismAudio 为 2.09;交互五秒为 2.68 对 6.22。五秒与十秒拆分各 4096 条,三十秒拆分为 1024 条,跨时长结果分别统计。 论文 Figure 2:两个交互片段中,与双向基线比较立体声布局。红框标出声源;能量平衡曲线中负值表示左声道占优,正值表示右声道占优。 批判点评:41.2 ms 是模型块计算,不是含采集、传输、播放缓冲的完整交互延迟。时间同步并非全优:VGG 五秒 DeSync 为 0.686,PrismAudio 为 0.539,后者更低。因果音频表示和有限立体声数据仍构成限制,三十秒评测不足以保证无限长会话稳定。项目页可听原始演示。 5. ALIVE:插入的物体跟着人物互动 ALIVE: Interaction-Aligned Object Insertion for First-Frame-Guided Video Editing | 罗切斯特大学;Adobe Research | arXiv:2610.08779 关键词:视频编辑, 首帧引导, 物体插入, 时间局部条件 前序问题:给视频首帧加一本书很容易,随后让人拿起、翻开它却难:插入物体常留在原地或穿过手。只写物体名称,也缺少每个阶段该发生什么交互的描述。 本文贡献:ALIVE 把干净源视频 latent 与带噪目标 latent 沿通道拼接,编辑后的首帧保持干净,以 LoRA 训练 LTX-2.5 22B 编辑器。35,800 对数据混合渲染、真实、模型生成与通用编辑来源,并标注多级提示。可选 VLM 从原视频、编辑首帧和物体名称预测分段交互描述与帧区间,再通过时间局部交叉注意力路由到对应片段。 论文 Figure 3:ALIVE 总览。(a)源视频与带噪目标 latent 沿通道拼接(C),编辑首帧 latent 保持干净(金色);火焰表示编辑器及 VLM 的 LoRA 微调。(b)监督 VLM 从同样的视觉输入与物体名提示 P1 预测 P4 描述及帧区间,P4 文本独立编码;注意力图比较共享的 P0–P3 条件与时间局部 P4 条件。 实验效果:表 1 的 128 例交互插入测试中,0–100 的 VLM Overall:只给物体名的 ALIVE 为 86.71,Señorita 为 60.24;预测分段提示后为 87.66。103 例通用插入中,ALIVE 为 92.28,加入 VLM 后为 91.71,增强并非对所有任务有益。 论文 Figure 4:交互物体插入定性结果。(a)拿书,(b)提篮,分别展示首帧、视频 40% 和 90% 位置。AnyV2V 的方形帧以较窄宽度展示;† 表示按照各方法官方提示格式额外提供交互指导。 批判点评:这些是自动 VLM 判断与抽帧协议下的分数,不能当作接触力或真实物理正确率。区间预测错误、布料和物体旋转仍会造成伪影;编辑器也不是在线流式生成器。论文明确实现和实验在罗切斯特完成,署名 Adobe 合作不应改写为单一机构成果。项目页可查演示,未确认可下载的方法代码。 6. MC-Sparse:缓存稀疏布局再补注意力尾项 MC-Sparse: Deconstructing and Closing the Dense-Sparse Attention Gap in Diffusion Transformers | 腾讯混元;复旦大学;上海创智学院;香港中文大学;南开大学;北京大学;上海交通大学 | arXiv:2610.06801 关键词:视频生成加速, 稀疏注意力, 元数据缓存, 残差补偿 前序问题:稀疏注意力与完整注意力之间的差距不只来自删掉低权重连接,还来自块结构绑定和近似选择错误。每步重新精确筛选又可能吞掉节省的计算。 本文贡献:MC-Sparse 在锚点步骤精确选择 KV 索引,并用相似查询重排与 token 级选择减少结构误差;跨去噪步缓存查询分组、选择索引及完整减稀疏的残差,近似补回被丢弃尾项。Q、K、V 特征仍在当前步重新计算,因此不是复用旧视频 token。预热、锚点刷新和 CUDA 实现成本都需计入。 论文 Figure 6:MC-Sparse 流程总览,展示查询分组、精确选择及元数据复用、token 稀疏注意力和尾项补偿之间的连接;具体预算与刷新策略以正文为准。 实验效果:表 1 的 Minimax-H3-Base 768p 视频分支:15% 注意力密度下,DiT 去噪加速 1.80 倍,相对完整注意力输出 PSNR 为 27.30 dB;25% 密度为 1.61 倍、28.44 dB。15% 时 VBench ImgQual 从 69.20 变为 68.94,接近基线仍有质量差异。 论文 Figure 1:Minimax-H3-Base 768p 的质量和效率。左侧为质量指标及 DiT 去噪延迟:15%、25% 注意力密度分别相对 FA3 全注意力加速 1.80、1.61 倍;右侧为 15% 密度生成帧与完整注意力参考的逐段比较。接近参考不代表无损。 批判点评:这里的 PSNR 对齐完整模型输出,不是真实视频;1.80 倍也不包含 VAE 与条件编码。各任务约五十个评测样本、硬件并行设置和内部三维数据限制泛化与复现判断,不能宣传无损或全系统同幅提速。项目页已给出,未把未知代码状态写成开源完成。 7. CtrlCache:转向与动作变化决定是否复算 CtrlCache: Accelerating Interactive Video World Models with Control-Aware Caching | 奥克兰大学;新南威尔士大学 | arXiv:2610.08777 关键词:交互世界视频, 免训练加速, 控制感知, 残差缓存 前序问题:少步交互世界模型还要多次运行昂贵 DiT。只按内部特征相似度决定缓存,容易忽视用户突然转向或改变动作时需要及时刷新。 本文贡献:CtrlCache 先把输入控制分成初始、变化、持续转向与稳定状态:初始及动作变化块完整计算,转向和稳定块才在选定内部去噪步复用本块最近完整步的残差,首尾步骤始终完整。稳定交互时,再把上一块最后一帧的低频历史先验混入首步干净 latent 估计;无需重新训练,也不把所有历史特征无条件沿用。 论文 Figure 3:CtrlCache 总览。(a)按块自回归去噪,首尾步骤保持完整计算;(b)动作感知策略在转向与稳定块的选定内部步复用残差,在初始及动作变化块保留完整计算;(c)稳定交互中,频率混合历史先验把前一块最后干净帧的结构用于指导首步干净 latent 估计。 实验效果:表 1 的 WBench 导航、单 A100 设置:Matrix-Game 2.0 去噪时间 14.99→10.67 秒,加速 1.41 倍,Overall 0.6543→0.6786;LingBot-World v1 为 1.26 倍、0.7816→0.8127,v2 为 1.21 倍、0.8042→0.8201。使用相同提示、控制和初始帧比较。 论文 Figure 4:CtrlCache 与基线的定性比较。各方法使用相同初始条件和控制序列;蓝色虚线框用于比较布局、物体位置及运动细节,红框标出外观或结构失真,绿框标出本文保留较好的细节。控制字符串沿用 WBench:W/S/A/D 为平移,left/right/up/down 为视角变化。 批判点评:计时排除 KV 提交与更新,不能直接当完整交互延迟;TeaCache 与 EasyCache 在此表还更快,CtrlCache 选择了不同质量取舍。v2 的画质与交互分项略降,不能写成每项提升。复用步位置和控制规则依赖具体模型,移植时需要重新验证。项目页提供方法说明。 8. UniSlider:滑杆刻度对应感知变化 UniSlider: Perceptually Uniform Sliders for Continuous Image Editing | 巴塞罗那自治大学计算机视觉中心;Adobe Research | arXiv:2610.06831 关键词:连续图像编辑, 感知均匀性, LoRA, 自适应采样 前序问题:把编辑强度从 0.2 拉到 0.3,有时完全没变化,有时突然跳到另一种样子。现有强度参数并不对应均匀的可感知变化,界面有刻度却缺少稳定控制。 本文贡献:UniSlider 在冻结的 FLUX.2-klein-4B 上训练按强度缩放的 LoRA,完整运行少步采样,用 DreamSim 距离把中间图推向输入与满强度输出之间的相应感知位置。满强度目标只需缓存基座的默认编辑,不需人工中间图。推理再测量样本的感知曲线,自适应重映射滑杆参数,补偿残余不均匀。 论文 Figure 3:UniSlider 训练。采样强度 s,按公式 3 缩放可训练 LoRA 与冻结主干组合,完整运行 T 步得到 x_s;满强度 x_edit 在 s=1 时仅缓存一次。公式 4 的损失把 x_s 推向输入 x_src 与 x_edit 之间由 s 指定的感知位置。 实验效果:表 1 的 300 例基准:感知距离变异系数 CV-DSim 为 0.652,SliderEdit 为 1.199;LPIPS 单调性违例率为 0.016 对 0.251。表 3 中,只用均匀采样的 UniSlider 为 0.871,自适应采样后为 0.652,表明训练和参数重映射均有作用。 论文 Figure 2:训练缩小滑杆不均匀差距,自适应采样继续补偿。三行对同一图像执行同一指令:左侧为等滑杆刻度的 SliderEdit、仅用训练损失的 Vanilla、带强度重参数化的完整 UniSlider;右侧为每张图相对输入的 DreamSim 感知距离,以输入到完整编辑的总距离归一化。对角线表示理想均匀变化。 批判点评:DreamSim 上的匀速不等于每种语义属性都线性变化,原文失败例中颜色变化会掩盖球尚未膨胀的问题。编辑身份保持与 VQA 单调性也并非逐项最佳,基座本身的错误会沿滑杆传播。不同基座的比较需看附录同基座对照。作者项目站本次 TLS 验证失败,未降级访问,也不声称演示或代码已核验;本卡依据可访问的原论文全文。 9. ChronoWorld:用四维记忆回看修正世界 ChronoWorld: Camera-Controlled Consistent 4D World Generation via Spatiotemporal Cues and Geometric Reflections | 北京大学王选计算机研究所;加州大学默塞德分校 | arXiv:2610.06687 关键词:相机可控生成, 四维世界, 几何记忆, 反思修正 前序问题:按新相机轨迹生成视频时,动态物体在不同视角可能对不上,局部漂亮也不能保证整个时空场景一致。需要把生成结果放回可重建的几何状态,再检查历史视角。 本文贡献:ChronoWorld 的 Observation–State–Reflection 框架以相机条件 STC-DiT 生成视频,通过时空极线因果注意力联结视角约束和时间顺序;多头重建 decoder 预测颜色、几何与运动等四维属性。统一 4D 记忆用于检索和重渲染,几何反思再据不一致结果做校正,把视频观察转成可检查的世界状态。 论文 Figure 2:ChronoWorld 框架。相机轨迹条件化的时空线索 Diffusion Transformer(STC-DiT)去噪目标视频,多头重建 decoder 预测四维属性。 实验效果:表 1 的相同输入视频与目标相机轨迹设置:ChronoWorld 的 FVD-4D 为 177.41,Free4D 为 216.67;相对位姿旋转、平移误差为 0.95、2.34,对方为 1.73、3.28。表 2 的重建一致性 PSNR 为 18.87、SSIM 为 0.73。本次也核对 v2,相应主表数字一致。 论文 Figure 4:不同相机轨迹下 ChronoWorld 与基线的定性结果。作者提示放大查看局部细节;量化效果须结合 FVD-4D、相机误差和重建一致性表格。 批判点评:4D 同步、相机误差与重建一致性是不同指标,不宜合并为现实世界正确率。几何由生成和估计共同建立,回看改进仍可能继承错误;原文未给出足以验证无限场景或完整实时延迟的证据。训练使用八张 A100 80GB,推理单 A100;未确认官方项目或代码入口,不宣称已开源。 10. Smorph:换音色时保留节奏与音高 Smorph: Playable Sound Morphing with Diffusion Models | 美国西北大学;Adobe Research;Wizdom Music | arXiv:2610.06478 关键词:声音生成, 音色变形, 结构引导, 音乐交互 前序问题:从铜管变成弦乐、从鼓声变成气泡声时,音色与节奏结构常一起变化。音乐设计希望保持音高轮廓或响度包络,让声音身份沿连续路径变化。 本文贡献:Smorph 在扩散采样中组合文本或音频端点引导,并让所有中间状态共享固定的 RMS 或音高结构条件;支持提示到提示、音频到提示和音频到音频变形。SoundCanvas 预生成 5×5、共 25 个声音组成二维网格,鼠标在邻近样本间双线性交叉混音,MIDI 键盘触发当前音色。当前引导无需额外训练,但所用基座与音频条件模块已有预训练或适配。 论文 Figure 2:结构引导的组合指导,详见第 3.1 节。变形参数 α∈[0,1] 插值音频或文本端点条件 c_1…c_N;共享结构参考 c_S 为所有中间状态锚定时间包络或音高轮廓,并在全部 T 个去噪步保持固定。 实验效果:表 2 的 Clotho→Clotho、RMS 音频到提示设置:相对 SDEdit,结构控制分数 S_ctrl 从 0.356 升到 0.646,mel-L1 从 1.518 降到 1.027;目标音色相似度从 0.695 降到 0.646,KAD 从 4.420 升到 4.902。结构保留增强伴随目标变形及分布质量取舍。 论文 Figure 3:有显式结构控制(上排)与无显式控制(下排)的变形路径。每格为 mel 频谱,灰线为输入 RMS、橙线为生成 RMS;显式控制在展示的路径中更好保留预期时间包络。 批判点评:实时的是预生成样本间的演奏与混音,不是鼠标每次移动都实时运行扩散。感知路径也不保证处处线性;音乐人案例属于探索性反馈。机构由作者项目页核实,arXiv 注释和项目页标示 ISMIR 2026,但本期不把这一标示扩大为独立查证的接收结论;没有确认方法代码下载。 趋势观察 计算应随阶段与控制变化 S2PD 把高噪声串行推演和低噪声并行细化分开,PVD 把粗细生成交给不同专家,CtrlCache 在动作变化时刷新。减少计算之前,需要先识别哪些阶段或控制状态承载关键依赖。 缓存内容比缓存数量更关键 MC-Sparse 缓存布局与误差补偿,WorldSonus 限制流式历史,ChronoWorld 保存可重建的四维状态。缓存有不同语义,不能把索引、旧特征与几何记忆混为同一种技巧。 连续控制需要可测的约束 UniSlider 用感知距离修正滑杆,Smorph 用音高或响度结构锚定音色变化,ALIVE 用时间区间对齐交互。控制的意义要落到具体条件与失败例,而非只展示连续参数。 速度与质量必须分别核对 训练吞吐、DiT 去噪、单音频块计算和端到端响应是不同预算。自动质量分数的改善也常伴随其他维度退步,本期逐项写清测试条件,不拼成统一性能榜。 今日讨论 你的生成工作流更需要降低训练成本,还是让交互控制更稳定? 人工智能炼丹君 整理 | 2026-10-07
-
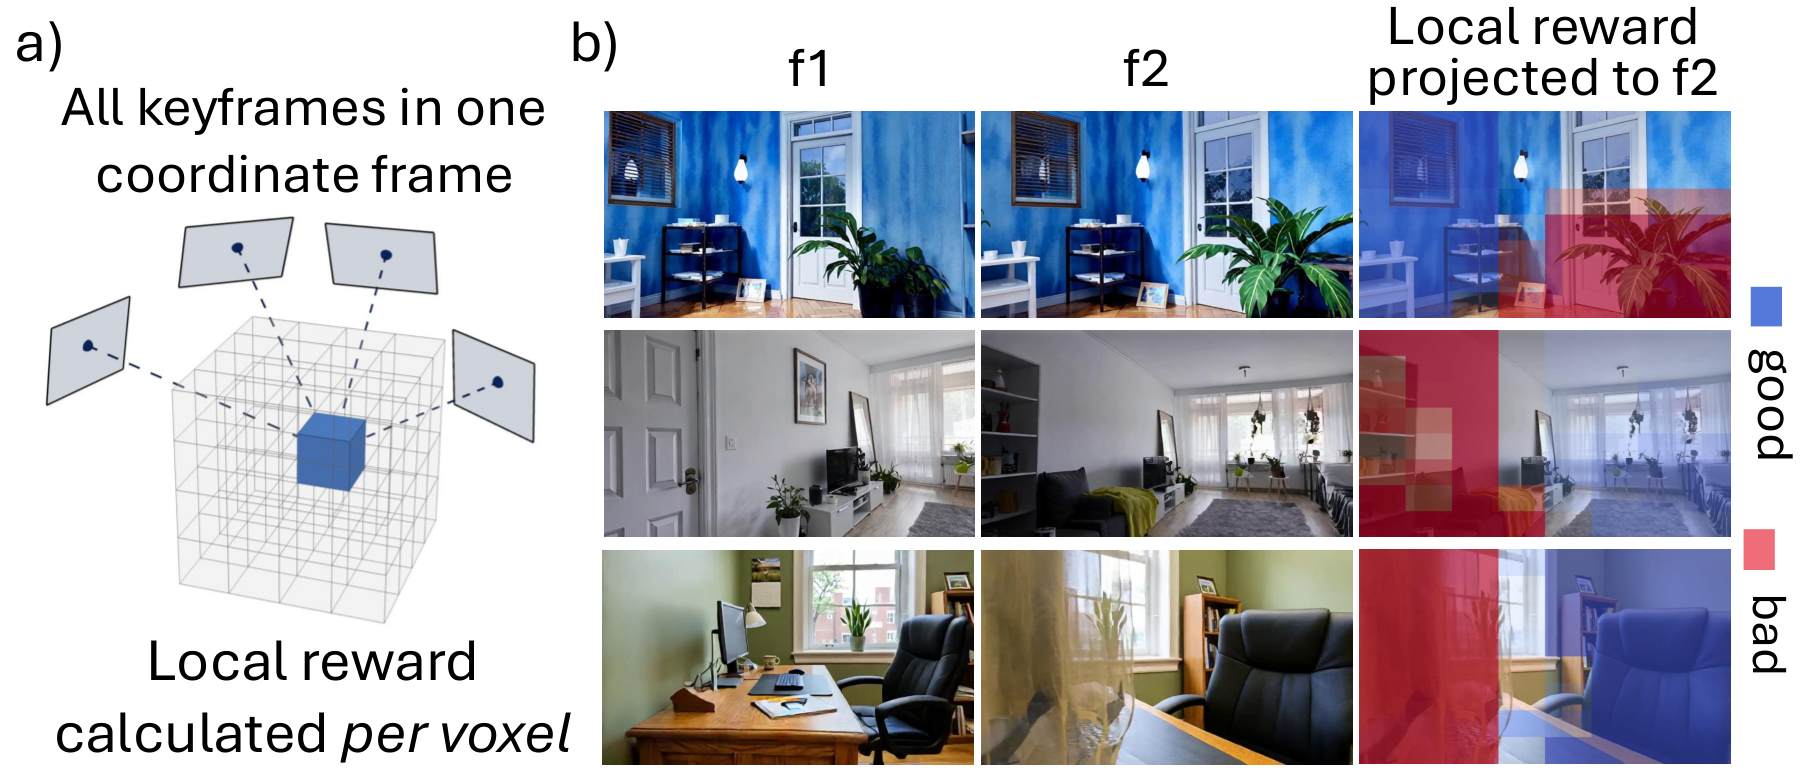
AIGC 每日速读|2026-10-06|加州理工稳住镜头外场景LoGo 今日 AIGC 论文速览 今日共 10 篇 · 长视频一致性与定制 2 篇 · 一步图像生成与后训练 2 篇 · 视频蒸馏与加速 3 篇 · 配对动作生成 1 篇 · 语音与音乐生成 2 篇 重点论文标题列表 LoGo(加州理工):镜头绕一圈场景少变形 Depth as Time(普林斯顿):一步生成把去噪搬进深度 DuoMatching(港中文):图像老师帮视频补回细节 VDOT++(悉尼大学):四步蒸馏别硬配每个token Reward Composition(UCLA):审美加分先过提示词约束 今日论文速览 1. LoGo:镜头绕一圈场景少变形 LoGo: Local-Global Rewards for Consistent Long-Horizon Video Generation | 加州理工学院 | arXiv:2610.03636 关键词:长视频生成, 相机控制, 三维一致性, 局部奖励 前序问题:镜头绕过墙面再回来,门可能移位、墙上数字可能变形。给整段视频一个三维一致性分数,会让局部错误被大面积正确区域稀释;只强化局部几何,又可能鼓励模型把画面变灰、变糊来降低误差。 本文贡献:LoGo 将关键帧经 VGGT 重建到共享三维空间,以 voxel 聚合 RGB 和深度重投影误差,把奖励分配到出错区域。训练混合归一化后的局部与全局奖励,并交替使用美学和相机跟随奖励。它改善的是相机可控视频的后训练信号,而非新增一个持久世界记忆模块。 论文 Figure 4:(a)说明 voxel 奖励如何聚合:把关键帧重建到共享三维空间,按体素汇总局部误差。(b)把局部奖励投影回视频帧进行可视化,突出需要修正的区域。 实验效果:表 1 的 TrajectoryBench 上,Lingbot2 的 PSNR-D 从 16.0 提高到 18.2 dB,极线误差从 1.507 降至 1.111,约下降 26%。表 2 的 DL3DV 上,同一基座极线误差由 2.161 降至 1.365。三个基座均有三维一致性收益,但相机指标并非逐项变好;例如 UniWorld 在表 1 的旋转误差由 13.8 变为 14.0。 论文 Figure 3:LoGo 的动机。(a)只用全局奖励难改善三维一致性;局部奖励改善以 PSNR 衡量的一致性,却降低以 HPSv3 衡量的画质,因此要组合二者。(b)绿色 LoGo 曲线扩展一致性与质量的 Pareto 前沿。(c)训练中的奖励曲线及质量评估显示,局部奖励随训练损害画质,LoGo 在改善一致性的同时维持质量。 批判点评:作者明确限定静态场景,超过 400 帧仍困难;因此不能写成动态世界无限稳定。奖励依赖重建模型估计的几何,改善重投影指标也不等于恢复真实物理。建议优先看局部奖励与画质的消融,再判断自己的相机轨迹是否在测试范围内。代码与 benchmark 已给出官方仓库。 2. Depth as Time:一步生成把去噪搬进深度 Depth as Time in One-Step Generative Models | 普林斯顿大学 | arXiv:2610.03626 关键词:一步生成, 深度探针, 共享权重, 模型压缩 前序问题:一步生成只调用一次网络,但网络内部仍有许多层。多步扩散的逐步去噪到底消失了,还是被重排到网络深度里?仅看最终图像,无法区分一次直达和层内反复细化。 本文贡献:作者用模型自身输出头解码中间层,并用独立训练及随机探针做对照:时间条件 flow-map 模型呈现随深度去噪的规律,部分 MeanFlow 任务甚至先去噪再加噪。进一步用带内部时间区间条件的共享 block 拟合教师隐藏层,把层数与独立参数组数拆开。 论文 Figure 2:大规模一步图像生成器也呈现沿深度逐渐去噪的现象。FLUX-schnell 和 MeanFlow 的逐层终点预测逐渐显露清晰图像结构;不依赖 τ 的 Drifting 模型作为对照。对 FLUX-schnell,模型输出头与独立训练探针得到相似的归一化终点距离下降规律,随机探针不能复现。 实验效果:附录表 1 的 ImageNet 256×256 实验:MeanFlow SiT-L/2 从 459M 参数压到 27.6M,压缩 16.6 倍;经 FD-loss 后训练,FID-50k 为 4.87,教师为 4.01。两组独立 block 的学生用 46.5M 参数达到 4.04。附录表 2 中,另行训练的两组 block 学生将执行次数减半后 FID 为 5.25。 论文 Table 1:ImageNet 256×256 的参数压缩结果。在教师原始深度、固定 K 执行次数下,分别报告 FD-loss 后训练前后的 FID-50k,各行采用最优 CFG 强度 ω。压缩倍数相对教师参数量;高亮行使用单个共享 block,灰色行为教师。增加独立 block 数量可用更多参数换取质量。 批判点评:16.6 倍是参数压缩,单组 block 仍可执行 24 次,不能换算成 16.6 倍延迟加速。相似的深度轨迹也不等于逐点复现教师的采样轨迹;缺少时间索引任务的 Drifting 模型未呈现同样规律。公开代码适合研究内部计算,结论尚不是所有一步模型的普遍定理。 3. DuoMatching:图像老师帮视频补回细节 DuoMatching: Joint-Marginal Distribution Matching for Few-Step Video Generation | 香港中文大学;字节跳动;香港科技大学;香港交互感知研究中心 | arXiv:2610.03543 关键词:视频蒸馏, 联合边缘分布, 图像教师, 潜空间桥接 前序问题:视频教师能教会时间连贯,但少步学生仍可能丢掉 prompt 中的羽毛、毛发等细节。整段视频的联合分布匹配会受到周围帧制约,需要额外的单帧监督补足视觉与语义先验。 本文贡献:DuoMatching 在视频联合 DMD 上增加来自图像教师的边缘 DMD。LatentBridge 将视频 latent、前一片段与局部帧编号映射到图像 latent,避免直接套用不同 VAE 空间;Latent Variation Sampling 用相邻 latent 的差异切分时间区间,每段抽样一片,提高有限监督预算的覆盖。 论文 Figure 3:DuoMatching 总览。(a)用图像教师参考分布 P_i 补充联合分布匹配;每组表示一个视频,节点表示帧级分布。(b)LatentBridge 根据视频 latent z^l、前一片 z^(l−1) 和局部帧编号 i,通过 ℓ₁ 重建损失映射到对应图像 latent。(c)Latent Variation Sampling 用相邻 latent 的差异分段,并在段内随机抽样。 实验效果:表 1 按生成单位和 NFE 分组:两步逐帧设置的 VBench Total 从 Causal Forcing++ 的 80.67 到 83.53;四步 chunk 设置从 82.79 到 83.51。表 2 在同一 Wan2.1 教师下,对四个基线的整体偏好为 80.87%–94.35%;对 Causal Forcing++ 的时间与运动偏好为 49.57%,说明主要收益来自画质与语义。 论文 Figure 1:DuoMatching 的动机与结果。自回归模型的后续帧常退化,图中 Q-Align 曲线展示这一现象。联合 DMD 缓解漂移,但学生与视频教师仍有画质差距,示例中缺少 prompt 要求的羽毛。联合与边缘匹配的组合改善画质、补回羽毛,同时保留时间连贯性;这张示例不代替完整统计评估。 批判点评:Full、Frame、Chunk 的函数评估单位不同,不能跨组把 NFE 当作相同成本排序。图像教师与桥接模块也带来训练成本;更清晰的单帧不是所有运动指标都提高的保证。项目页提供代码,值得在相同生成模式与预算内复现。 4. VDOT++:四步蒸馏别硬配每个token VDOT++: Unified Few-Step Video Generation via Unbalanced Optimal Transport Distillation | 悉尼大学;上海人工智能实验室;香港科技大学;香港中文大学 | arXiv:2610.03221 关键词:少步视频生成, 非平衡最优传输, 跨规模蒸馏, 条件生成 前序问题:同一个文字或图像条件允许多种正确视频。把学生与教师每帧的空间 token 强制全量配对,可能把本来合理但位置不同的内容当作错误,并在分布重叠不足时给出不稳定指导。 本文贡献:VDOT++ 在 DMD 上加入非对称非平衡最优传输:放松学生侧质量约束,下调不可靠 token 的质量,同时保持教师侧覆盖。ℓ₁ 距离使聚合更接近加权中位数,减少远处匹配的影响;DMD 与对抗项分两次反传。相同训练配方分别训练三类任务的生成器,还研究大 score 网络指导小生成器。 论文 Figure 3:VDOT++ 总览。上方:给定条件,少步生成器同时使用 DMD score 差异、逐帧最优传输匹配和对抗损失,经两次顺序反传及一次优化更新。下方图示一对时间帧,为清楚省略扩散时间与帧索引 (t,q)。DMD 在对应时空坐标提供 score 差异;平衡 OTD 显式耦合空间 token,却强制全量匹配;对称 UOT 放松两侧。非对称 UOT 放松学生侧、保持教师侧约束,压低不可靠学生 token 质量并维持教师覆盖。 实验效果:表 III 的文生视频 VBench 中,Wan-14B 四次评估学生的归一化均分为 81.59,50×2 次评估教师为 77.70;表 IV 的图生视频对应为 78.38 和 77.92。表 II 的 flow 条件任务却是 80.29,对应教师 80.35,因此不是每个任务、每项指标都超过教师。 论文 Figure 4:可控视频生成的定性对比。比较 100 次函数评估的 VACE 教师与 4 次评估的 VDOT、VDOT++,任务为(a)flow 条件的视频到视频,(b)视频向外扩展,(c)多参考图像到视频。顶行给出输入条件,每种方法展示 0、2.5、5 秒的帧。 批判点评:“统一”指训练配方跨任务复用,并非一个 checkpoint 同时完成全部任务。NFE 降低也不能直接等同端到端加速倍数。正文提到 CVPR 2026 的是前作 VDOT,这个扩展版本未核实接收证据,不能借前作会议作本篇背书;本文未发现可核验的新代码仓库。 5. Reward Composition:审美加分先过提示词约束 Post-Training Frontier Text-to-Image Models by Composing Preference and Rubric Rewards | 加州大学洛杉矶分校;Arena Intelligence | arXiv:2610.02967 关键词:图像后训练, 人类偏好, rubric奖励, 奖励投机 前序问题:优化审美奖励,模型可能擅自添加装饰、乱码或写实风格;只优化提示词完成度,又可能牺牲细节。把不同量纲的分数简单平均,无法处理“这个要求只对某类 prompt 生效”的情况。 本文贡献:这项图像后训练研究组合人类偏好、内容满足度和禁止内容 checklist。各奖励轴独立归一化;只有意图严格的 prompt 激活额外约束;适用的反投机检测发现问题后否决正向偏好加分。不同奖励配置得到的权重再做融合,使审美优化受到意图约束。Reward Composition 是本文的编辑短名。 论文 Figure 2:两类反复出现的奖励投机失败。左侧:prompt 要求不含文字,RL 策略却在餐巾上添加乱码。右侧:prompt 要求 Elsa Beskow 的故事书插画风格,基座保持该风格,而 RL 策略偏向照片写实。这些案例解释为何需要按 prompt 启用约束和否决。 实验效果:表 1 的 2026-09-04 Arena 快照中,FLUX.2-dev 从 1132.8±14 到 1202±13,约增加 69 Elo。表 2 在 1k 验证 prompt、五个候选 checkpoint 中选择最佳值,Stage 3 在 Gemini 评估配 Arena RM 的对比胜率为 0.660,单偏好为 0.507;这些自动评估与线上 Elo 不是同一个指标。 论文 Figure 1:奖励设计可视化。只用偏好训练会偏向通用装饰并忽略要求;只用满足度会洗掉细节并丢失风格和景物;Arena-T2I-Hard 能恢复要求元素但保留多余装饰;不加意图门控的禁止内容奖励,即使 prompt 允许细节也会将其压平。Stage 1 仅在意图严格时施加约束,示例中能满足要求而未明显损伤质量。 批判点评:只测试两个基座、单个随机种子,内容分解问题未经人工逐条审计。排行榜数字属于 9 月 4 日快照,不是今天的排名;多个 checkpoint 择优也需与固定预算评估区分。作者说释放 1k 训练子集,但本次项目页未提供可核验下载入口,因此不声称数据或代码已可下载。 6. PMD:冻结视频模型顺手生出动作 Parasitic Co-Denoising: Unlocking 3D Human Motion Generation in a Frozen Video Diffusion Model | 新加坡南洋理工大学 | arXiv:2610.03047 关键词:三维动作生成, 视频扩散, 共去噪, 多层特征融合 前序问题:视频模型学会了人怎么动,却没有显式输出可用于动画的三维动作。先生成视频再估计动作需要多阶段处理;从零训练动作生成器又受动作数据覆盖限制。 本文贡献:Parasitic Motion Decoder(PMD)附着在冻结的 Wan2.1 上。先对齐动作与视频 latent,再用轻量 flow-matching decoder 读取视频 DiT 多层特征,按噪声水平 σ 自适应融合,并与视频共享去噪日程。视频与动作的噪声独立,耦合来自同一日程和特征条件;一次联合采样流程得到配对输出。 论文 Figure 2:Parasitic Motion Decoder(PMD)的结构。先将动作与视频 latent 对齐,再让动作 decoder 与冻结视频宿主同步去噪;σ 自适应多层融合把宿主的中间特征送入动作流。 实验效果:表 1 的 MBench Protocol B:19M 可训练参数的 PMD,动作条件一致性 0.58、泛化 0.72;2B 可训练参数的 MotionVLA 对应 0.55、0.66。表 2 的 HumanML3D 上,PMD 的 R-Precision Top-1 为 0.537,FID 为 0.098;DisCoRD 的 FID 为 0.032,说明语义对齐优势没有覆盖全部分布质量指标。 论文 Figure 3:MBench prompt 上的定性比较,展示各动作生成方法对文字动作要求的可视化结果。图展示动作语义与轨迹外观;抖动、足部接触等质量仍应结合实验表分别判断。 批判点评:19M 是附加可训练模块,不包含冻结视频宿主,因此不是整个系统只有 19M 参数。冻结宿主没有接受本工作三维动作监督,但附加模块训练仍用配对动作数据。动作抖动、接触和 FID 也并非全面最佳;没有找到作者可核验代码链接,不把模板或会议样式当作接收证据。 7. Custom Forcing:两分钟视频保持同一个主体 Custom Forcing: Training-Free Subject Customization for Autoregressive Video Generation | 韩国庆熙大学;得克萨斯大学奥斯汀分校 | arXiv:2610.02914 关键词:视频个性化, 自回归生成, KV缓存, 免训练定制 前序问题:自回归视频能不断续写,却容易把用户给定的某只宠物或物品变成同类通用实例。固定参考帧只能提供初始锚点;文本的类别先验与后续漂移会逐步削弱主体身份。 本文贡献:Custom Forcing 将五张参考图和一张场景定制 anchor 一次写入持久 KV cache。DVA 根据当前主体相似度相对初始水平的下降增强参考 value;ACG 比较读取与不读取 anchor 的注意力输出,沿远离通用类别先验的方向引导。冻结基座,无需逐主体训练。 论文 Figure 3:Custom Forcing 总览。上方:参考图与 FLUX.2 [klein] 生成的定制 anchor 副本一次写入 KV cache。中间:冻结基座每层 self-attention 在 DVA 以 g(t) 放大参考 value 后,分别读取含及不含 anchor 的缓存,得到 z_+、z_-。左下:DVA 根据当前已完成 chunk 的相似度 s(t) 相对初始 μ_base 的下降设置 g(t)。右下:ACG 以 κ 沿远离 z_- 的方向外推,再与 z_+ 混合。 实验效果:表 1 的两分钟测试:固定 K/V 的首段与末段 DINO-I 为 0.583、0.415,Custom Forcing 为 0.622、0.578。表 2 在单 H100、30 秒、100 个案例上,相对 FramePack-F1、SkyReels-V2 DF、SkyReels-V3 的逐帧生成时间优势为 9.5、11.5、28.5 倍;这些基线架构和规模不同。 论文 Figure 4:两分钟生成示例。只使用定制 K/V 时,主体在第一分钟内发生漂移;Custom Forcing 在展示的两种主体案例中维持到两分钟。两种案例分别生成,并非证明一个视频同时控制两个主体。 批判点评:相对固定 anchor,DVA 与 ACG 增加 11%–13% 生成时间。测试为动物和物品、每段一个主体、最长两分钟,局部细节漂移和多个主体仍未解决。实际能力受冻结基座限制。作者项目页可访问,但没有找到该方法的可核验代码仓库。 8. SpectralCache:复用奇异子空间少算主干 SpectralCache: Accelerating Diffusion-Based World Models via Spectral Feature Caching | 史蒂文斯理工学院;美国东北大学;达姆施塔特工业大学 | arXiv:2610.02660 关键词:扩散加速, 世界视频生成, 频谱缓存, 特征近似 前序问题:世界视频模型每个去噪步都运行昂贵主干。直接复用完整特征没有利用结构:相邻步骤的主导奇异子空间相对稳定,变化更多体现在低维奇异值上。 本文贡献:SpectralCache 在完整步分解最终层特征,缓存最近两次的奇异子空间、奇异值和残差。近似步固定子空间,只线性外推奇异值;误差累积或间隔到阈值后,交替刷新主干和缩放奇异值,以进一步少算完整步骤。它是免训练近似,不是精确复用。 论文 Figure 4:SpectralCache 总览,区分完整主干计算与近似缓存步骤;稳定奇异子空间和残差被复用,奇异值通过外推或缩放更新,触发条件控制刷新。 实验效果:表 1 的 HunyuanVoyager-13B,512×768、49 帧设置下加速 5.22 倍;静态 WorldScore 从基线 66.28 变为 65.90,动态从 46.40 变为 46.13。Aether-5B 的 480×720、41 帧生成加速为 2.20 倍。不同模型与任务的收益应分别读,不能都写成 5.22 倍。 论文 Figure 1:SpectralCache 与基线在 HunyuanWorld-Voyager-13B 上的比较。(a)视觉效果,(b)延迟,(c)质量。在所测条件下加速约 5.22 倍,同时保持较高视频保真;接近原模型仍不代表逐像素无误差。 批判点评:频谱稳定和固定缩放系数来自所测模型的经验,强动态或采样日程改变时需重新验证。质量接近基线仍存在误差,不能写“无损”;PSNR 对齐基线生成也不是对齐真实视频的证明。当前原文没有可核验代码链接,工程复现还需要补足实现和预算测量。 9. DriftTTS:不用生成老师四步合成语音 DriftTTS: Few-Step Text-to-Speech Without Distillation via Distribution-Matching Drift | 马萨诸塞大学阿默斯特分校;伍斯特理工学院 | arXiv:2610.03390 关键词:语音合成, drifting模型, 分布匹配, 少步生成 前序问题:少步 TTS 往往依赖多步生成教师或预设噪声到数据轨迹。能否直接让真实和生成 mel 特征的分布接近,并让生成器学习自己实际会访问的中间状态? 本文贡献:DriftTTS 在原始 mel 与冻结 MelMAE 特征空间构造真实样本吸引、生成样本排斥的 drift 目标,训练文本条件 decoder。on-policy rollout 用模型自身中间状态学习少步更新;MelMAE 只用于训练。推理从高斯噪声逐步替换 mel 状态,再由 HiFi-GAN 转为波形,无生成教师蒸馏。 论文 Figure 1:DriftTTS 总览。文本条件高斯噪声经少步 drift decoder 迭代细化为 mel 频谱,再用 HiFi-GAN 转为波形。训练时在 mel 域特征空间使用真实与生成样本计算 on-policy 分布匹配 drift 目标,优化 decoder。 实验效果:表 1 在 LJSpeech、相同 HiFi-GAN 和 Whisper-medium 评估下,四步 DriftTTS 的 MCD 为 3.87 dB、WER 3.7%,Matcha-TTS 为 3.85 dB、3.4%。表 2 的 MOS 为 4.18±0.16,对方 3.96±0.18;配对检验按受试者聚合 p=0.31,按语句 p=0.044。 论文 Table 1:LJSpeech 评估。所有合成系统使用同一个 HiFi-GAN 声码器,WER 由 Whisper-medium 计算,听测统计另见 Table 2。四步 DriftTTS 的 WER 为 0.037、MCD 为 3.87、UTMOS 为 4.25、MOS 为 4.18;四步 Matcha-TTS 对应 0.034、3.85、4.36、3.96。NFE 是声学生成器的函数评估次数。 批判点评:更高 MOS 均分不能写成所有统计口径显著胜出,两个客观指标还略逊基线。无生成教师不等于没有预训练组件,仍用 MelMAE 与声码器;只报告单说话人数据。推理次数应不超过训练深度 K,训练两步的模型直接跑四步会退化。官方代码可访问。 10. Music Rubric:音乐奖励别只盯一个分数 Rubric-Based Optimization for Text-to-Music Generation | 华盛顿大学;艾伦人工智能研究所 | arXiv:2610.03589 关键词:文本到音乐, rubric奖励, 音频语言模型, 后训练 前序问题:提高某一个音乐自动评分,可能牺牲提示词符合度或其他听觉质量。让音频语言模型按多个维度打分是否更稳,也要区分“音乐听起来好”与“速度、调性、乐器确实正确”。 本文贡献:作者用七维自然语言 rubric 评价 prompt 对齐、风格乐器、旋律、节奏、结构、制作和音乐性。MusicGen-small 与 ACE-Step v1 将候选排名转为 DPO 偏好对;ACE-Step 另用 DiffusionNFT 在线优化标量奖励,并比较一次联合评分和逐维评分。Music Rubric 是本文编辑短名。 论文 Figure 1:MusicCaps 上 DPO 后各评估器分数相对未训练模型的百分比变化,正值为好。上排为 MusicGen-small,下排为 ACE-Step v1。每面板对应一个偏好来源:左三列斜线柱按单一自动指标排序,右三列实心柱按音频语言模型 rubric 排序。面板内三柱对应三个评估器,三柱皆正表示无这三项的取舍。各排尺度不同,上排最大柱使用断轴以保持小柱可读;绝对变化见附录表 1、2,基线分数见表 4。 实验效果:附录表 3:ACE-Step 用 Qwen3-Omni 逐维奖励训练 125 次更新后,相对原模型 CLAP、SongEval、Audiobox 分别增加 0.0180、0.1057、0.3385。第 5.4 节的小听测有 7 人、40 条 caption、52 次判断,36 次偏好训练后模型,即 69%,95% 区间 48%–89%;这些是不同口径的证据。 论文 Figure 2:ACE-Step v1 的 DPO 与 DiffusionNFT 比较,每个评分器一面板。面板内三组为 rubric 偏好 DPO(斜线)、一次请求评价全部维度的联合提示 DiffusionNFT、每维度独立请求的逐维提示 DiffusionNFT。每组三柱为与 Figure 1 同色的三个评估器,以相对未训练模型的分数变化百分比表示。所有面板同尺度,对 Qwen2-Audio 最大柱使用断轴;绝对变化见附录表 2、3,基线分数见表 4。 批判点评:评分器和提问方式决定信号是否有效:Music Flamingo 联合评分可出现奖励上涨而外部指标下降,rubric 也没有改善所测调性准确率。短音乐、少量听测与宽置信区间不足以承诺长曲或专家质量;直接属性测量与 rubric 更适合互补使用。本次未找到可核验的作者代码入口。 趋势观察 奖励要定位错误并尊重条件 LoGo 将几何错误定位到三维区域;图像奖励组合按 prompt 意图启用约束,音乐 rubric 则暴露评分器和提示方式的影响。更细的奖励有机会改善生成,但也需要防止对评分代理的过度优化。 一步调用仍包含内部迭代 Depth as Time 把压缩目标推进到网络深度,SpectralCache 从稳定子空间中减少重复计算。参数、执行次数与端到端延迟是三种预算,本文分别给出对应测试条件。 跨模态先验需要明确桥接 DuoMatching 把图像教师接到视频 latent,PMD 把视频宿主知识接到动作流。对齐接口是关键,但附加参数或少步采样不能抹去宿主与训练的成本。 质量应按维度报告 主观偏好、文字符合度、三维一致性和接触质量不一定同步上升。不同论文的 benchmark、生成单位与采样预算不同,这份日报不把分数拼成统一排行榜。 今日讨论 你会优先改善长视频的一致性,还是压缩少步生成的内部计算? 人工智能炼丹君 整理 | 2026-10-06
-
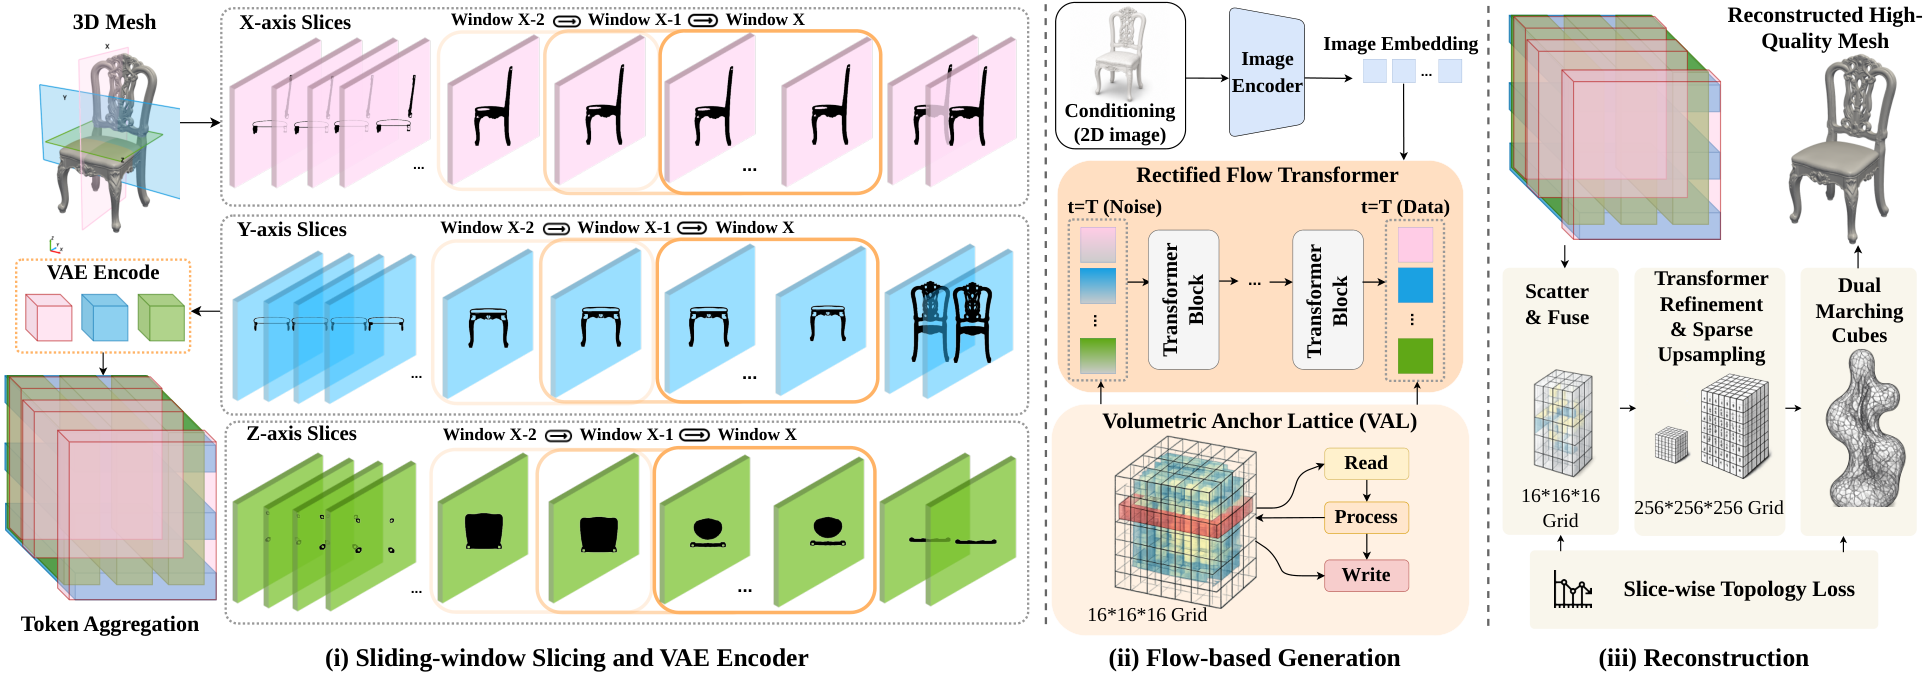
AIGC 每日速读|2026-10-05|NeurIPS省七成token保孔洞SILSA 今日 AIGC 论文速览 今日共 10 篇 · 3D生成 1 篇 · 持久世界建模 2 篇 · 视频表征与3D控制 3 篇 · 个性化图像生成 1 篇 · 音频生成 2 篇 · 视频生成评测 1 篇 重点论文标题列表 SILSA(伊利诺伊大学):省七成token保住孔洞 Oneira(莫纳什大学):新物体能互动且留下后果 World Observer(KAIST):镜头外的物体也继续演化 SemanTok(Stability AI):小模型先学会视频语义 Tacit-TTS(杜比实验室):免转写克隆语音快十倍 今日论文速览 1. SILSA:省七成token保住孔洞 SILSA: Sliding-Window Slice Latents for Topology-Preserving High-Resolution 3D Generation | 伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02201 关键词:图像生成3D, 切片潜空间, Rectified Flow, 拓扑约束 前序问题:高分辨率 3D 生成常先预测活跃体素,再补局部几何;连续曲面被拆成大量局部 token,细杆、孔洞和远距离连接容易断裂。增加体素数能补细节,却同时推高序列长度与训练显存。问题不只是模型画得像不像,还包括生成的网格是否保留原有结构。 本文贡献:SILSA 沿 x、y、z 三轴使用重叠的滑动窗口切片,每个 token 概括一段局部深度窗口。Slice VAE 将带朝向的表面采样编码成切片潜变量,再通过稀疏体积解码器重建网格;Volumetric Anchor Lattice 给三组切片共享的 3D 工作空间。切片级持久同调与相邻切片 Betti 转变损失约束连通分量和孔洞,图像条件 Rectified Flow 则一次生成整组潜变量。 论文 Figure 2:SILSA 总览。沿 x、y、z 轴以重叠切片 latent 表示形状。拓扑感知 SliceVAE 将表面编码为固定的多轴切片 latent,再通过稀疏体积上采样解码为高分辨率网格。图像条件 Rectified Flow Transformer 生成 latent,并以 Volumetric Anchor Lattice 作为共享 3D 记忆协调不同轴。VAE 训练中的切片级持久同调与 Betti 转变损失监督连通分量、孔洞和拓扑一致性。 实验效果:表 3 中固定 384 个 token,对比最紧凑基线 Dora 的 1280 个减少 70.0%;batch size 4、单张 A100 下训练显存 8.7GB,对比 Dora 的 14.6GB 减少 40.4%,端到端推理 0.34 秒/形状,对比 0.82 秒减少约 58.5%。表 1 的 PSNR 为 32.74,SparseFlex 为 30.12;表 2 的 Betti-Err 为 1.582,对比 1.743。arXiv comments 明确标注 Accepted at NeurIPS 2026。 论文 Figure 3:自然场景输入图像的 image-to-3D 生成结果。图中展示 SILSA 从不同输入得到的 3D 形状;这是定性展示,不能仅凭样例推出分布外形状可靠性。 批判点评:这些数字来自不同对照:70% token、显存和延迟以 Dora 为参照,PSNR 与 Betti-Err 的强基线是 SparseFlex,不能拼成对同一模型的全面领先。切片拓扑监督改善结构,并不提供任意形状的拓扑保证;作者也承认分布外结构及信息不足的输入视角会降低保真。值得关注的是表示方式,而不是把单物体结果直接外推到完整场景。 2. Oneira:新物体能互动且留下后果 Oneira: From Open-Ended Generation to Open-World Interaction in Video World Models | 莫纳什大学;大连理工大学;香港中文大学(深圳);牛津大学;布里斯托大学 | arXiv:2610.01614 关键词:交互式视频生成, 显式世界状态, 状态持久性, 条件视频 前序问题:能生成新房间,不代表能持续与新房间里的东西互动。镜头发现一个新苹果,模型要把它变成可操作对象;把苹果拿走之后,再回头也应看到空桌面。纯视频续写往往把交互当作局部视觉效果,缺少记录事件后果并供后续片段查询的状态载体。 本文贡献:Oneira 用显式世界状态表把视频生成与交互闭环连接。coding agent 读取当前观察和目标,定位实体、规划动作并把结果写回表;探索中发现的新物体也会注册。渲染引擎沿相机轨迹把更新后的表转成粗条件视频,视频生成器结合首帧、可选记忆帧和分块 caption 补齐外观与动作;末帧和更新后的状态进入下一段。它的贡献落在生成可互动且状态连续的视频环境。 论文 Figure 2:Oneira 单片段流程。给定输入图像与目标,coding agent A 读取世界状态表并规划动作 P_k。引擎 E 将每个动作写入表,把更新结果 T_k 沿相机路径 C_k 渲染成粗条件视频 V_k(第 3.2 节)。交互表现为物体框的删除或重新着色;被移动物体的框暂时移除,静止后从生成帧重新注册,新露出的物体也如此。视频模型 G 结合首帧、可选记忆帧、V_k 与分块 caption c_k 生成片段(第 3.3 节),末帧与更新后的表启动下一段。球体仅为示意,条件与生成帧来自同一个 Oneira 片段。 实验效果:表 1 的 InteractionBench 包含 100 个交互案例和 50 条记忆链。Oneira 的交互成功率为 0.78、目标正确率 0.82,LingBot-World-V2 分别为 0.49、0.39;记忆部分 State 通过率 0.80,MiniMax-H3 Ref2VA 为 0.68。图 3 展示三个片段组成的 30 秒链,比较执行交互后转回原处的状态。 论文 Figure 3:三个片段组成的 30 秒链的定性比较。各列上方标出当时的动作,橙色单元格表示 caption 携带交互的 chunk,插图显示 Oneira 的条件视频。红色标签标注 baseline 帧中的失败。Oneira 在指定 chunk 控制两次交互,并在相机转回时维持改变后的状态。 批判点评:状态表使“后果被记住”更明确,却没有让底层视频模型成为物理仿真器。作者列出的动作空间仍是离散的,连续控制和精细接触并未解决;长时域视觉一致性仍受生成器能力限制。100 个交互案例与 50 条记忆链是作者的专用评测,不能等同于开放世界任意操作均可靠。 3. World Observer:镜头外的物体也继续演化 World Observer: Joint Actor-Observer Generation for Persistent World Modeling | 韩国科学技术院(KAIST)人工智能学院 | arXiv:2610.02162 关键词:视频世界模型, 全景观察者, 多视角生成, 镜头外动态 前序问题:视频世界模型通常只生成行动者当前看见的画面。汽车驶出视野之后,没有可见证据约束它继续前进;再次入镜时可能丢失、停住或变成别的车。仅保存旧图像能帮助记住外观,却不一定能维护镜头外持续发生的动态。 本文贡献:World Observer 把“行动”和“观察”拆成两个同步生成流:透视 actor 负责当前视角,全景 observer 持续观察选定区域,二者由共享 DiT 联合生成。共同全景源的 warping 建立几何对应;Observer Sink 从高分辨率初始全景取四个透视参考,帮助物体重返视野时恢复细节。观察者还能放在不同位置,或接收单独条件来控制画面外的事件。 论文 Figure 4:模型总览。(a)World Observer 使用共享 DiT 联合生成 actor 与全景 observer 两条流。(b)Observer Sink 将高分辨率初始全景转换为四个透视参考,以保留精细外观信息。 实验效果:表 1 的真实/合成 OOV 测试中,单观察者 2B 模型的 FVD 为 291.7/196.2,LingBot-World 为 420.0/333.3;OOV-D_gt 为 0.426/0.531,对方为 0.337/0.340。多观察者仅在合成集测试,FVD 为 147.0,但 OOV-D_gt 为 0.528,略低于单观察者 0.531。因此视角增加改善部分指标,并非所有动态指标同步上涨。 论文 Figure 7:与其他模型的定性比较。红框标出目标离开视野前与重新进入视野后的物体。已有模型常丢失物体、冻结其状态或不一致地重建它;World Observer 在视野外间隔后更好地保持物体身份与状态演化。 批判点评:方法目前需要全景条件,作者将从普通透视图补全全景列为后续方向;真实世界多观察者条件稀缺,多观察者优势只在合成集有证据。有限的观察者预算也无法覆盖整个世界。它更像把算力分配到感兴趣区域,而不是获得无限范围的世界记忆。 4. SemanTok:小模型先学会视频语义 SemanTok: Predictable Semantic Tokens for Efficient Autoregressive Video Generation | Stability AI;卡尔斯鲁厄理工学院 | arXiv:2610.00686 关键词:视频tokenizer, 自回归生成, DINO语义监督, 可变长度token 前序问题:自回归视频生成需要先确定场景是什么,再补纹理细节。可变长度 tokenizer 虽能从粗到细输出,已有 decoder-REPA 对齐却可能利用带噪输入满足损失,未必迫使短 token 前缀本身承载语义;小 AR 模型因此仍可能生成类别不对或随时间漂移的画面。 本文贡献:SemanTok 保留 VideoFlexTok 的可变长度训练和 nested dropout,在编码端加入冻结 DINO 特征,并用轻量 Dense DINO 与 Class DINO 读出头,要求每个保留下来的 token 前缀单独预测教师语义。冻结 tokenizer 后,AR 模型按时间优先、由粗到细的顺序预测 token,再由扩散 decoder 还原视频。语义监督直接落在短前缀,而不只落在 decoder 的中间状态。 论文 Figure 2:方法总览。(1)tokenizer 训练:encoder、FSQ 与扩散 decoder 联合训练,nested dropout 使 decoder 能从任意 token 前缀重建视频。SemanTok 保留 VideoFlexTok 的训练方案(橙色),再加入冻结教师的语义监督:教师特征输入 encoder,每个保留的前缀都学习预测这些特征(紫色;细节见图 3)。(2)AR 训练与生成:冻结 tokenizer,AR 模型按时间优先、粗到细的顺序预测 token,步骤(1)的 decoder 将任意生成前缀渲染为视频。 实验效果:摘要与实验分析报告:201M 的 SemanTok AR 模型可匹配或超过约 3.4 倍规模的 VideoFlexTok AR 模型;附录表 4 中相应规模阶梯为 201M 和 679M。正文还报告在相同 AR 模型下,k=16 时每 token 预测约少用 32% 的 bits。图 7 比较同一 Kinetics-600 弹吉他类别的 rollout,201M 的 SemanTok 随时间退化更慢。 论文 Figure 7:SemanTok 在两种 AR 模型规模下保持优势。图中是同一 Kinetics-600 弹吉他类别的 class-to-video rollout。在 201M 模型下,SemanTok 随时间缓慢退化,而 VideoFlexTok 只在 t=1 时清晰。项目页提供视频。 批判点评:“小模型追上大模型”限定在作者的数据、token 预算与指标配置;参数量减少不等于端到端生成耗时同比减少。正文专门指出每帧仅 1 个 token 时不能兼顾全部目标,附录重建表也显示部分 PSNR/SSIM 逊于基线。语义更准和逐像素重建更准是两种目标,部署时仍需按预算权衡。 5. Tacit-TTS:免转写克隆语音快十倍 Tacit-TTS: From Autoregressive Decoding to Masked Prediction for Efficient Transcript-Free Voice Cloning | 杜比实验室 | arXiv:2609.38658 关键词:语音克隆, Masked LM, 非自回归生成, ReFlow蒸馏 前序问题:自回归 TTS 逐个预测语义 token,零样本音色克隆效果好但延迟高。非自回归系统更快,却常要求参考音频的转写;参考是陌生语言、婴儿咿呀或无意义发音时,ASR 生成的错误文本反而污染条件。目标是在不要求参考转写的同时降低生成耗时。 本文贡献:Tacit-TTS 从 IndexTTS2 蒸馏,将 text-to-semantic 阶段替换为 masked 非自回归生成,同时保留预训练的说话人和情绪条件。免训练长度估计结合参考音频语速与目标文本音节数,确定输出长度;连续潜表示和 ReFlow 蒸馏则加速下游 semantic-to-mel 的 flow-matching 渲染器,最后由 vocoder 合成波形。 论文 Figure 2:Tacit-TTS 流程总览。输入为参考音频与目标文本,encoder 提取条件表征;text-to-semantic 模型通过 masked-LM 生成语义 token,semantic-to-mel 模型将其转成 mel 频谱,最后由 vocoder 合成波形。 实验效果:单张 NVIDIA A100 上,作者对超过 5 秒的语音报告相对 IndexTTS2 超过 10 倍加速。图 3 的端到端测试包含参考条件计算:4 秒输出约 9.0 倍、31 秒附近最高约 14.9 倍、125 秒为 11.8 倍。表 1 中 LibriSpeech speaker similarity 为 0.875,教师为 0.870;但 WER 为 5.54,教师为 3.115。参考语言另测试了 8 种语言及非词汇声音。 论文 Figure 3:IndexTTS2 与 Tacit-TTS 的端到端生成时间(包含参考条件计算)随输出时长的变化。使用同一参考片段,以固定段落重复延长输出。虚线表示实时速度;Tacit-TTS 曲线上方数字是相对教师的加速比,插图放大 Tacit-TTS 曲线。4 秒、31 秒附近和 125 秒的示例加速比约为 9.0、14.9 和 11.8 倍,不能当作全数据平均。 批判点评:更快没有消除质量损失:普通中文测试上的音色相似度和内容准确度仍落后于教师。图 3 使用固定段落重复拉长输出,最高 14.9 倍不能写成所有语音平均加速;长序列的全注意力成本也开始侵蚀收益。四个常规数据集的其他基线质量数字来自教师论文,而跨语言与非词汇测试由作者重跑,比较范围应分开理解。 6. 4Director:完整网格让物体转身不丢脸 4Director: Controlling Video World Models with Rigid 3D Geometry | Stability AI;伊利诺伊大学厄巴纳—香槟分校 | arXiv:2610.02160 关键词:可控视频生成, 4D场景, 刚体网格, Motion Adapter 前序问题:2D 框只能指定物体在屏幕上的位置,不能完整表达深度和转向;3D 点或 blob 也缺少完整表面。镜头与物体同时移动时,模型容易每帧重新猜未观测几何,导致物体转了一半、遮挡出错或身份变化。专业创作需要把相机和物体轨迹放进统一的 3D 坐标系。 本文贡献:4Director 从输入图为每个物体一次重建 canonical mesh,每帧只施加一个指定刚体变换。网格、背景点云与相机共享坐标系,用户编排轨迹后渲染成深度视频;可训练 Motion Adapter 将几何条件注入预训练视频模型,后者补充外观、光照与非刚体动态。团队构建含 20,774 个片段的 RealCOD-Rigid,并以身份判断门控 mask IoU,形成 IG-IoU 指标。 论文 Figure 3:4Director 总览。左侧:每个物体只重建一次为完整 canonical mesh,每帧用一次刚体变换移动;网格、背景点云与相机共享坐标系,用户在该坐标系指定物体与相机轨迹,并将场景渲染成深度视频(第 3.1 节)。右侧:可训练的 Motion Adapter 分支将刚体渲染注入预训练视频生成器,由后者补充外观、光照与非刚体动态(第 3.2 节);训练使用 RealCOD-Rigid(第 4 节)。 实验效果:表 1 中 4Director 的 FVD 为 370.4,SymphoMotion 为 405.4、VerseCrafter 为 484.7;IG-IoU 为 60.4,对应 52.9 和 54.8,camera RotErr 为 3.65°。图 5 对比共同相机与物体控制,显示其更完整地跟随指定转向;图 6 另展示物体离开视野后重返的定性案例。 论文 Figure 5:相机与物体共同控制的定性比较。每个片段顶行展示输入图像和规定的轨迹,其下为四个 baseline、4Director 以及源视频按时间对齐的帧。箭头表示物体朝向,源视频中为绿色、生成视频中为红色。该组案例里只有 4Director 完成源视频的转向;baseline 保留原朝向、只转了一部分、模糊或丢失主体。 批判点评:完整网格减少逐帧几何猜测,却会把错误重建固定进控制条件。论文失败案例中,倒立舞者被当作一个刚体平移,生成结果一直保持初始姿态而没有跳舞,说明刚体轮廓可能压制应有的非刚体动作。IG-IoU 还依赖视觉语言裁判判断身份;作者的 VBench 优势多数在 2 个点以内,应避免把图中单例写成稳定保证。 7. GenCine:相机与物体在3D里一起编排 Generative Cinematographer: Composing Camera and Object Motion in 3D | 约翰斯霍普金斯大学 | arXiv:2610.02180 关键词:视频运动控制, 3D运动handle, XYZ引导图, LoRA 前序问题:同一条 2D 拖拽轨迹可能对应完全不同的 3D 运动;相机和物体一起动时,屏幕坐标更难区分“物体真的转身”和“镜头绕过去”。另一方面,整物体刚体控制过硬,人体、动物或机械臂的不同部分需要分别编排,而不必为每类对象建立物理模型。 本文贡献:GenCine 把单张图提升为可编辑的 3D 场景 scaffold,艺术家在共同世界坐标系里设置相机路径,并以局部 3D handle 控制前景不同部分。背景 XYZ、前景 XYZ 和恒定前景身份颜色图分别表达静态位置、动态位置和跨帧对应;有效性 mask 标记缺失条件。轻量 guidance branch 与 Wan 模型的 LoRA 学习这些控制,从真实视频恢复轨迹并结合合成数据训练。 论文 Figure 3:GenCine 的 3D 控制流程。首先从 RGB 图估计深度与动态 mask,再提升为供动作编排的 3D 场景。艺术家通过 Blender 等 3D 界面,在共同世界坐标系指定相机和物体运动。控制转为背景 XYZ、前景 XYZ 和前景身份图,分别指示静态场景位置、移动 handle 的位置及身份。有效性 mask 区分可用条件与缺失值,动态 mask 标出初始前景。冻结的 Wan VAE 将图编码给视频模型;训练配对从视频运动恢复的条件,推理时同样的图表达艺术家编排的控制。 实验效果:表 1 的 Camera Shooting 上,GenCine 的 TransErr 为 1.00,Wan-Move 为 1.02;受控前景 R-LPIPS 为 0.18,对方为 0.19。Object Interactions 上整体 LPIPS 为 0.35,Wan-Move 为 0.37,但整体 PSNR 为 16.54,略低于 Go-w-Track 的 16.59。图 5 给出艺术家编排运动的定性对比,体现 3D 意图与 2D 投影控制的区别。 论文 Figure 5:艺术家编排运动的定性比较。自上而下为 Living room、Bus 和 Robotic arm;每组按行展示 Wan-Move、VerseCrafter、Go-with-the-Track 和 GenCine。第一列为 3D 控制(GenCine)或共享的 2D 投影(baseline),随后四帧采样各控制区间。实线与虚线分别表示已执行和剩余目标路径,圆点表示当前目标,半透明 mask 表示投影目标区域。 批判点评:主要价值是可表达的控制接口,数值优势相当局部,不支持“全指标碾压”的结论。多个 handle 只是分段刚体近似,不能可靠表示复杂形变;单图深度估计出错、遮挡和超出归一化范围的运动都会影响控制。它与 4Director 各有取舍:局部操作更灵活,但没有完整网格带来的全表面约束。 8. PEARL:从用户历史推理个性化画面 Personalized Image Generation with Reasoning and Reflection | 范德堡大学;Adobe;马里兰大学帕克分校;佐治亚大学 | arXiv:2610.00737 关键词:个性化图像生成, 用户历史, 推理反思, DPO 前序问题:个性化图像生成通常依赖挑选好的参考图片,而真实用户偏好分散在评论、帖子、图片和 metadata 中。把某件商品放到什么环境、某个主题应采用什么风格,需要综合历史线索;检索一张最像的图片并不能完整表达生活方式与审美。 本文贡献:PEARL 将多模态 planner、reflector 与冻结图像生成器串成 reason-reflect 循环:先从历史形成场景计划并渲染,再根据实际图像与历史的不匹配修订计划。训练先蒸馏 silver personalization trajectory,再采用交替策略 DPO,用与用户历史相关的检索奖励优化两种策略。配套 benchmark 区分电商商品的 Personalized Scene Generation 和社交媒体的 Personalized Creative Generation。 论文 Figure 2:Pearl 的训练流程。先用 Silver Personalization Trajectory 做 warm start,再通过 Render-in-the-Loop 优化两种策略。图左的教师产生推理与计划供 planner 和 reflector 蒸馏;图右把两种策略与冻结渲染器串接,按奖励给候选排序、构建偏好对并做交替 DPO 更新。 实验效果:表 1 的 Amazon 场景生成中,H@5 为 0.2297,PMG 为 0.2143;MLLM Overall 为 3.92,对方为 3.48。表 2 的 Instagram 创作生成中,跨类别 R@1 为 0.876,Pigeon 为 0.748,MLLM Overall 为 3.541,对方为 3.334。图 4 将两种任务的指标归一化后汇总,比较完整 PEARL 与移除 reflection 的版本。 论文 Figure 4:消融:Pearl 与 Pearl -Reflection 的比较。该可视化对两种任务的指标进行归一化和汇总,展示保留 reflection 前后的差异;坐标是汇总后的相对值,不是原始 benchmark 分数。 批判点评:用户“喜欢”不等于模型能识别出用户:检索与 MLLM 分数只是偏好对齐的代理指标。作者明确指出电商场景没有每个用户—商品组合的自然真实目标图,只能间接评估;策略训练也只做了一轮交替 DPO。Instagram 的 LPIPS 和 MS-SSIM 并非最优,因此不能把摘要中的平均个性化提升写成所有画质指标普遍提升。 9. PLACE:让双耳声像跟随多模态条件 PLACE: Positional Latent Adaptation via Conditioned Embeddings for Binaural Audio Generation | 杜比实验室;佐治亚理工学院 | arXiv:2610.00630 关键词:双耳音频生成, 空间条件, 低秩latent适配, ILD与ITD 前序问题:音频与画面语义一致,还不一定听得出声音来自左边还是右边。现有空间声音生成器的条件接口常较固定,难以同时接收文本、视频和可选音频。想让耳机中的声像随场景变化,需要条件中的空间信息真正改变生成 latent,而不是只描述声源类别。 本文贡献:PLACE 基于 AudioX,增加 Perception Encoder Core 视频特征,将文本与视频表征对齐以提取空间线索,再用依赖条件的低秩变换调整生成 latent。适配器通过解码音频上的耳间声级差 ILD 和时间差 ITD 损失训练;五个预训练 encoder 与 SAO decoder 冻结,AudioX 通过 LoRA 微调。系统支持不同模态条件组合,而非只处理视频输入。 论文 Figure 1:PLACE 框架总览,蓝色突出视频特征路径,橙色突出文本路径。(a)AudioX 生成 latent,空间条件在冻结 SAO decoder 之前驱动其变换;五个预训练 encoder 与 decoder 全部冻结,AudioX 用 LoRA 微调。(b)投影后的 PE Core 特征在 MAF 模块之前补充 CLIP 与 Synchformer 特征。(c)文本—视频 cross-attention 与联合 self-attention 产生空间特征 H_c-sp。 实验效果:表 1 的 FAIR-Play split 1 上,ITD 误差 0.1077ms、ILD 误差 2.0495dB,ViSAGe 分别为 0.1136ms、2.1306dB;split 2 的 ITD 却较差。表 3 的分布外 T2A 听测平均分为 55.5,SpatialSonic 为 44.8;域内 V2A 为 65.3,对方 ViSAGe 为 44.9。原文只写 Submitted to ICASSP 2027,不能称为会议接收。 论文 Table 3:主观听测表。评分范围为 1–100,越高越好;SC 为语义一致性,SI 为空间感,SP 为空间一致性,Sy 为同步性(T2A 不评此项),AR 为音频真实感,Avg 为所评维度的均值。GT 是真实音频参考,不参与最佳模型加粗;粗体表示每种条件各列最优模型。表中区分域内与分布外 T2A、域内与 Gemini 视频条件 V2A;n 统计评分数。PLACE 在域内 T2A 均分 40.5,分布外 T2A 为 55.5,域内 V2A 为 65.3,Gemini V2A 为 58.4。 批判点评:收益取决于模态与分布。域内 T2A 听测均分仅 40.5,低于 SpatialSonic 的 44.4 和 AudioX 的 41.1;BEWO-1M SS-set 上 FSAD、ITD、ILD 也逊于 SpatialSonic,优势集中在原文定义的 SpatialCLAP 差值指标。听测表中的 n 是评分数,不能当作独立听众人数。空间一致性进步不等于全面音质领先。 10. VTR-Bench:视频逼真了字却还常写错 VTR-Bench: A Systematic Benchmark for Evaluating Visual Text Rendering in Video Generation | 香港城市大学;香港科技大学(广州);香港科技大学;西湖大学;电子科技大学 | arXiv:2610.01499 关键词:视频生成评测, 视觉文字渲染, WER, 关键帧引导 前序问题:广告、科学演示和界面视频里的文字常承担核心信息。模型能把灯光与动作做得漂亮,招牌仍可能拼错、缺字或小字不可读;只评审美与物理合理性无法发现这些问题。需要把文本正确性与画面任务完成度分开衡量。 本文贡献:VTR-Bench 用 300 个 prompt 覆盖五类场景,对具体文字载体分别转写并计算 WER,同时用每条 prompt 的 20 问 checklist 检查场景与运动要求。作者另外提出关键帧引导生成流程,由 Director agent 根据视觉反馈反复调整图像、首帧及运动计划,再生成视频。主贡献是生成模型评测与改进,符合 AIGC 范围,而不是通用视频理解。 论文 Figure 2:VTR-Bench 总览。左侧:专家设计五种场景类别,引导场景 seed 生成与人工过滤;保留的 seed 用于构造 prompt,再通过参考图生成和 VLM 审查迭代完善,最后人工复核。右侧:生成视频在两个维度分别评估,Video Score 以 20 问 checklist 衡量场景与视频要求完成度,WER 比较针对具体文字载体的 VLM 转写与参考文字,衡量视觉文字保真。 实验效果:主表 1 比较 11 个视频模型,Wan3.0 的整体 WER 最低,为 0.250,Video Score 为 0.849;MiniMax H3 为 0.447/0.756,Seedance2.5 为 0.641/0.791。表 2 中 Qwen3.8-27B 对文字块 WER 的 Pearson 为 0.9541,视频级为 0.9842,支持其与人工转写的相关性。官方代码:VTR-Bench。 论文 Figure 1:即使视频视觉上可信,现有视频模型仍难正确渲染文字。上方是 Seedance2.5 生成的视频;Video Score 是 20 问 checklist 中满足要求的比例,WER 是相对参考文字的词错误率。左下展示视频中的四种文字渲染问题,右下展示 11 个模型在 VTR-Bench 上的整体 WER。 批判点评:WER 是词级编辑距离,0.250 不等于“25% 的视频失败”,也不能推出每个视频都错四分之一。不同模型的分辨率与生成管线不同,排行榜还受评审模型影响;相关性高不意味着每条转写都正确。关键帧 agent 的迭代成本也应单独核算,不能把更高预算的改进当作单次生成能力。 趋势观察 从像素记忆走向状态载体 Oneira 显式记录交互后果,World Observer 持续生成选定区域的视角;两条路线都让镜头外状态获得约束,但尚未证明无限时域或全面物理可靠性。 控制接口先解决几何歧义 4Director 用完整刚体网格,GenCine 用局部运动 handle;它们共同把相机和物体放进世界坐标系,分别在完整几何与形变灵活性之间取舍。 短序列必须携带可用信息 SILSA 的切片潜变量与 SemanTok 的短语义前缀都减少局部 token 负担;这是不同任务中的表示设计趋势,不能把各论文加速数字横向相乘。 评测拆开能力与代价 视频里的字、音频的空间感、用户历史匹配和端到端耗时都需要独立指标。各论文测试集、评分口径和硬件不同,本期不做跨论文统一排行榜。 今日讨论 SILSA 用切片拓扑监督改善单物体孔洞与连通性;面对输入视角不充分或分布外形状,你会优先增加多视角条件,还是设计可验证的拓扑约束? 人工智能炼丹君 整理 | 2026-10-05