搜索到
16
篇与
diffusion
的结果
-
 AIGC 每日速读|2026-05-27|美团LongCat-Avatar 1.5开源逼近闭源数… 今日 AIGC 论文速览 今日共 7 篇 · 工业级数字人开源对标闭源 1 篇 · 音视频联合生成评测体系 1 篇 · 视觉生成新范式:层级与通道级 2 篇 · DiT 推理加速与可控编辑 2 篇 · 原生多模态架构路线图 1 篇 重点论文标题列表 LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongAV-Compass:首个分钟级音视频生成评测基准 MRT:20B多层透明图像生成超Qwen CVQ:通道级VQ取代patch挑战传统 RT-Lynx:激活稀疏化让DiT GEMM加速1.55x 今日论文速览 1. LongCat-Video-Avatar 1.5:美团数字人开源对标HeyGen LongCat-Video-Avatar 1.5 Technical Report | 美团 LongCat Team | arXiv:2605.26486 关键词:数字人·美团 LongCat·8 NFE 蒸馏·RLHF·开源对标闭源 前序问题:音频驱动视频生成虽然进展飞快,但要做到「商业级稳定性」仍然难——商用场景下需要的不仅是「唇形对得上」,还要全身时序稳定、长视频身份不漂、多人交互/物体交互不崩,并且部署侧推理 budget 严苛 本文贡献:美团 LongCat-Video-Avatar 1.5:以「系统工程 + 生产就绪」而非架构创新为优先项的开源数字人框架。把 audio encoder 升级到 Whisper Large 并精修训练 recipe,做到准确唇形同步 + 全身时序稳定 + 长视频严格身份一致;通过严格数据清洗 + RLHF 训练,泛化到动漫/动物等风格化域,并原生处理多人交互和物体处理这类真实复杂场景;为工业部署引入 advanced step distillation 把推理压到 8 NFE 实验效果:在 500+ 多样测例 benchmark 上的定量指标 + 严格人评显示 v1.5 在 human-likeness 和专家级质量评估上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越;开源发布拉近了「学术原型」与「商业级部署」的差距 批判点评:美团摆明用「工程优先」的姿态——Whisper Large + 严苛数据 + RLHF + 8 NFE 蒸馏这套组合拳是教科书级的工业打法,公开报告稀缺。但「commercial-grade」更多靠数据规模和清洗,单一架构 trick 不构成壁垒;对标 HeyGen / OmniHuman 1.5 的具体维度需要更详细的 ablation 才能说服业界,且 8 NFE 与 Kling Avatar 2.0 之间的真实人评差距值得追踪 2. LongAV-Compass:首个分钟级音视频生成评测基准 LongAV-Compass: Towards Unified Evaluation of Minute-Scale Audio-Visual Generation Across T2AV, I2AV, and V2AV | 北京大学, Kling, 南大, 上交, 港科广州, 上海 AI Lab | arXiv:2605.26244 关键词:音视频生成·minute-scale·评测基准·T2AV/I2AV/V2AV·北大 前序问题:音视频联合生成正在从「短片段」走向「分钟级长内容」,但现有评测协议几乎都还停留在 5-10 秒文本条件生成;很少支持文本/图像/视频三种条件统一评测,更没说清楚长时间下身份一致性、叙事连贯、音画对齐到底怎么退化 本文贡献:LongAV-Compass:首个面向 minute-long 音视频生成的系统化评测基准。284 个精选测例覆盖 T2AV / I2AV / V2AV 三种输入,按应用场景和生成复杂度组织;统一评测框架结合 MLLM 辅助评估和 DINO-v2 / ArcFace / CLIP / ImageBind 等感知指标,覆盖 20+ 细粒度维度——段内质量、跨段一致性、全局叙事连贯、语义对齐、音画同步全都评 实验效果:在 11 个代表性模型上跑 + 人对齐验证,把当前系统在「保持连贯、保持语义对齐、保持时序一致」上的瓶颈量化呈现;为分钟级音视频生成提供了首个诊断式 testbed——音视频联合生成的「评测短板」正式被补上 批判点评:把音视频联合生成的评测从 5-10s 短片推到分钟级是必要补位——评测落后一直是这个赛道的隐形天花板。20+ 细粒度维度 + MLLM 辅助 + 4 大经典感知模型组合非常综合。但 MLLM 评测本身的偏置是隐忧,DINO-v2/ArcFace/CLIP/ImageBind 的权重融合策略需要更多 ablation;分钟级测例 284 个对开源社区评测可行但工业级评测仍偏小 3. MRT:20B多层透明图像生成超Qwen MRT: Masked Region Transformer for Layered Image Generation and Editing at Scale | 微软亚研 MSRA | arXiv:2605.27235 关键词:多层图像生成·20B·masked region·8 步实时·MSRA 前序问题:层级图像生成与编辑是图像生成走向「可复用 / 可重编辑 / 可组合」的关键能力——类比自然语言里的「逐词编辑」——但在大规模上一直是 underexplored 的空白。多层透明生成 + 多任务统一框架既缺数据也缺方法 本文贡献:MRT:20B 参数 masked region diffusion 模型,专为多层透明图像生成与编辑打造,在 10M+ 多语言设计样本上训练,支持多 aspect ratio 与多语言 prompt。两项核心贡献:(i) 把 text-to-layers / image-to-layers / layers-to-layers 三任务统一到「共享 masked region diffusion」框架,靠 selective token masking 灵活切换层级生成与编辑;(ii) overflow-aware canvas layer 处理边界 inconsistency 并支持半透明背景合成,做出可编辑且延伸至画布外的完整图层。配套 diffusion 蒸馏实现 8 步实时多层生成 实验效果:在三项任务上全面超越此前 SOTA 包括商业系统;user-study 显著优于同期 Qwen-Image-Layered 的 image-to-layers 质量,且推理快 10-100×,activation GPU 显存降低 50-90%——为多层透明图像生成立下新基准 批判点评:把多层图像生成做到 20B + 三任务统一 + 8 步实时是非常工业化的工作量;超越 Qwen-Image-Layered 的人评结果是强信号。但 10M+ 设计样本的语义/版权分布未明,多语言/多 ratio 的真实可控性需要更细 ablation;overflow-aware canvas layer 在极端 aspect ratio 下的稳定性也需要追踪 4. CVQ:通道级VQ取代patch挑战传统 Channel-wise Vector Quantization | 上海创新研究院, 西湖大学, 浙大, 复旦 | arXiv:2605.26089 关键词:视觉 tokenization·channel-wise VQ·CAR·next-channel·DPG 86.7 前序问题:传统视觉自回归(VAR)和 VQ-based 文生图都把图像分成 patch、给每个 patch 分配一个离散 token——但这种 patch 视角本质是「把图像当空间网格」,不太符合人类绘画「先勾结构再补细节」的层次过程。codebook 利用率上不去、增大 codebook 后 collapse 也是顽疾 本文贡献:Channel-wise Vector Quantization (CVQ):新视觉 tokenization 范式,离散化对象从 patch 换到 feature map 的每一个 channel——一张图被表示为「不同层级视觉细节的离散等级」而不是「空间 patch 网格」。基于 CVQ 提出 Channel-wise Autoregressive (CAR):next-channel prediction 替代 next-patch prediction,先勾全局结构再渐进精修细粒度属性 实验效果:CVQ 在 16K+ codebook 规模下实现 100% codebook 利用率(无任何 trick),重建质量显著超过传统 VQ;CAR 在文生图上拿到 DPG 86.7 / GenEval 0.79——证明「按 channel 分层渲染」是 patch-based 视觉自回归的现实替代品 批判点评:把 tokenization 从空间 patch 切换到 channel 维度是真正的范式 rethink——「先结构后细节」也与人类作画过程契合。100% codebook 利用率是很硬的数字。但 channel 抽象层次的物理含义不够清晰(哪个 channel 对应「结构」哪个对应「细节」依赖训练涌现),跨分辨率/跨模态时的稳定性需要进一步验证;与 latest DiT 路线的端到端比较略浅 5. RT-Lynx:激活稀疏化让DiT GEMM加速1.55x RT-Lynx: Putting the GEMM Sparsity In a Right Way for Diffusion Models | 国内系统研究团队 | arXiv:2605.26632 关键词:DiT 加速·激活稀疏化·N:M sparsity·CUDA kernel·1.55x 前序问题:DiT 推理太贵——量化和蒸馏已经被深挖,但能砍掉将近一半 FLOPs 的「半结构化稀疏(N:M sparsity)」一直 underexplored。原因是大家都在做 weight 稀疏化,但对 weight 做 50% 剪枝会拿掉关键模型容量,让生成质量崩坏 本文贡献:RT-Lynx:核心 insight 是「DiT 的激活本身天然稀疏,比 weight 更适合 N:M 半结构化稀疏化」。提出 paradigm shift——从 weight sparsification 转到 activation sparsification;配 error-compensation 缓解精度损失;并实现针对该场景高度优化的 CUDA kernel 实验效果:线性层平均 1.55× speedup,多个扩散模型上保留原生生成质量同时显著加速;为 DiT 部署提供「除量化和蒸馏外的第三条加速路线」 批判点评:把「稀疏化目标」从 weight 切到 activation 是非常对的洞察——activation 在 inference 时本来就动态出现 zero,强制 N:M 模式损失更小。1.55× 加速 + 不掉质量在 DiT 推理优化里属于实打实的硬增量。但 N:M 模式需要硬件配合(Ampere/Hopper 的 sparse tensor core),消费级 GPU 上的实际收益要打折;激活稀疏化对极长 token 序列(高分辨率视频)下的可扩展性需评测 6. ControlLight:Flow Matching做连续强度可控低光增强 ControlLight: Towards Controllable, Consistent, and Generalizable Low-Light Enhancement | 中科院深圳, StepFun | arXiv:2605.25569 关键词:低光增强·flow matching·连续可控·一致性·中科院深圳 前序问题:现有深度学习低光增强方法都在「有限数据集 + 单一增强目标」上训练——既泛化差又不可控。真实场景里同一张暗图,不同用户/不同场景需要不同的增强强度,但现有方法把它当作一个固定函数 fit 本文贡献:ControlLight:「可控 + 一致 + 可泛化」的低光增强框架。先建大规模真实退化图像数据集,对每张图给出「连续光照强度」标签作为监督;引入 misalignment-aware weighted flow matching loss,让模型在不同控制强度下输出仍然保持图像结构一致——用户可以连续滑动「增强强度」拿到不同结果而不撕裂 实验效果:在多个 benchmark 上超过现有低光增强 SOTA,同时具备「连续强度可控」+ 「真实场景泛化」能力,把低光增强从「一锤子函数」改造成「可调节工具」 批判点评:把 flow matching 用到低光增强 + 连续条件标签 + misalignment-aware loss 三件套是非常 clean 的设计——其中「misalignment-aware」直接 attack 不同强度下结构一致的根因。但「连续光照强度标签」如何从真实退化数据获取本身是个隐藏难题;与最近基于 diffusion 的图像 restoration 在极端低光场景的比较需要更全面 7. Native MM Roadmap:原生多模态架构路线图三分类 Toward Native Multimodal Modeling: A Roadmap | 华威大学, Monash, 港理工, 腾讯优图 | arXiv:2605.25343 关键词:原生多模态·NMM·路线图·three-class taxonomy·腾讯优图 前序问题:多模态建模正在从 modality-agnostic 推理走向 world modeling。早期 late-fusion(拼 encoder + frozen LLM + 输出头)已显疲态,最近转向 Native Multimodal Modeling (NMM)——把各模态从根上集成进同一个 transformer 拿到更强性能。但 NMM 的设计空间目前仍未系统化 本文贡献:为社区提供形式化的 NMM 路线图:(1) 形式化定义「架构原生性」,区分 mid-fusion / early-fusion 与非原生范式;(2) 从「输入-输出对偶」角度把现有 native 模型组织成三类——Multi-to-Text(跨模态理解,纯文本输出)/ Multi-to-Target(场景化生成,如图像/音频/视频生成)/ Multi-to-Multi(对称输入输出的统一建模);(3) 全栈式工业视角剖析从架构协调、海量数据 curation、训练 recipe 到推理部署和评测的端到端 pipeline 实验效果:把当前散乱的「统一多模态架构」研究归结成一份可被工程师和研究员同时参考的路线图——理解和生成在「统一 transformer 范式」下无缝共存是 NMM 的目标终态。对走向 GPT-4o / Gemini 1.5 级原生多模态的开源工作给出系统化方法学 批判点评:「形式化 architectural nativity + 输入输出对偶三分类 + 全栈工业视角」三个层次组织得很清晰——是社区急需的概念清理。但综述类天然有「分类强、实证少」的局限,三类边界(特别是 Multi-to-Target 和 Multi-to-Multi)在最新模型上可能交叉;对未来 1-2 年具体技术抉择的指导力度需要在落地 case 中验证 趋势观察 工业级开源数字人 / 视觉基础模型加速对标闭源 — 美团 LongCat-Video-Avatar 1.5 用 Whisper Large + RLHF + 8 NFE 蒸馏的工业打法,在 500+ 测例上与 HeyGen / OmniHuman 1.5 / Kling Avatar 2.0 等闭源系统打平甚至超越——昨天百度 ERNIE-Image 是文生图,今天美团 LongCat-Avatar 是数字人——国内大厂正在多个垂类同时按下「开源对标闭源」按钮 音视频联合生成评测从「短片」推到「分钟级」 — LongAV-Compass 提供首个 minute-scale 音视频生成评测基准——284 个测例覆盖 T2AV / I2AV / V2AV、20+ 细粒度维度(段内质量 + 跨段一致 + 全局叙事 + 语义对齐 + 音画同步)。和最近 Baton / SpongeBob / StreamChar 等音视频联合生成模型一起,把「短片评测」时代正式翻篇 视觉生成 tokenization / 架构范式正在被 rethink — MRT 把「图像生成」从单层 RGB 推到「多层透明 + 三任务统一 + 8 步实时」;CVQ 把视觉 tokenization 从 patch-wise 切换到 channel-wise,重提「先结构后细节」的人类作画过程并拿到 100% codebook 利用率与 GenEval 0.79——patch + 单层这两个长期假设都在被挑战 DiT 推理加速的第三条路:从「weight 稀疏」转向「activation 稀疏」 — RT-Lynx 指出 DiT 激活本身就稀疏,对 N:M 半结构化稀疏化远比 weight 鲁棒,配合错误补偿和定制 CUDA kernel 拿到 1.55× 线性层加速且不掉质量——量化、蒸馏之外,「激活稀疏化」正式成为 DiT 部署的第三条加速路线 Native 多模态架构走向系统化,可控生成成为最后一公里 — Toward Native Multimodal Modeling 把原生多模态架构形式化为「Multi-to-Text / Multi-to-Target / Multi-to-Multi」三分类,给出从架构到训练到部署的全栈 roadmap;ControlLight 用 misalignment-aware flow matching 把低光增强做成「连续强度可控」工具——「统一架构 + 可控生成」正在收敛成下一代生成模型的双轨 人工智能炼丹君 整理 | 2026-05-27 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
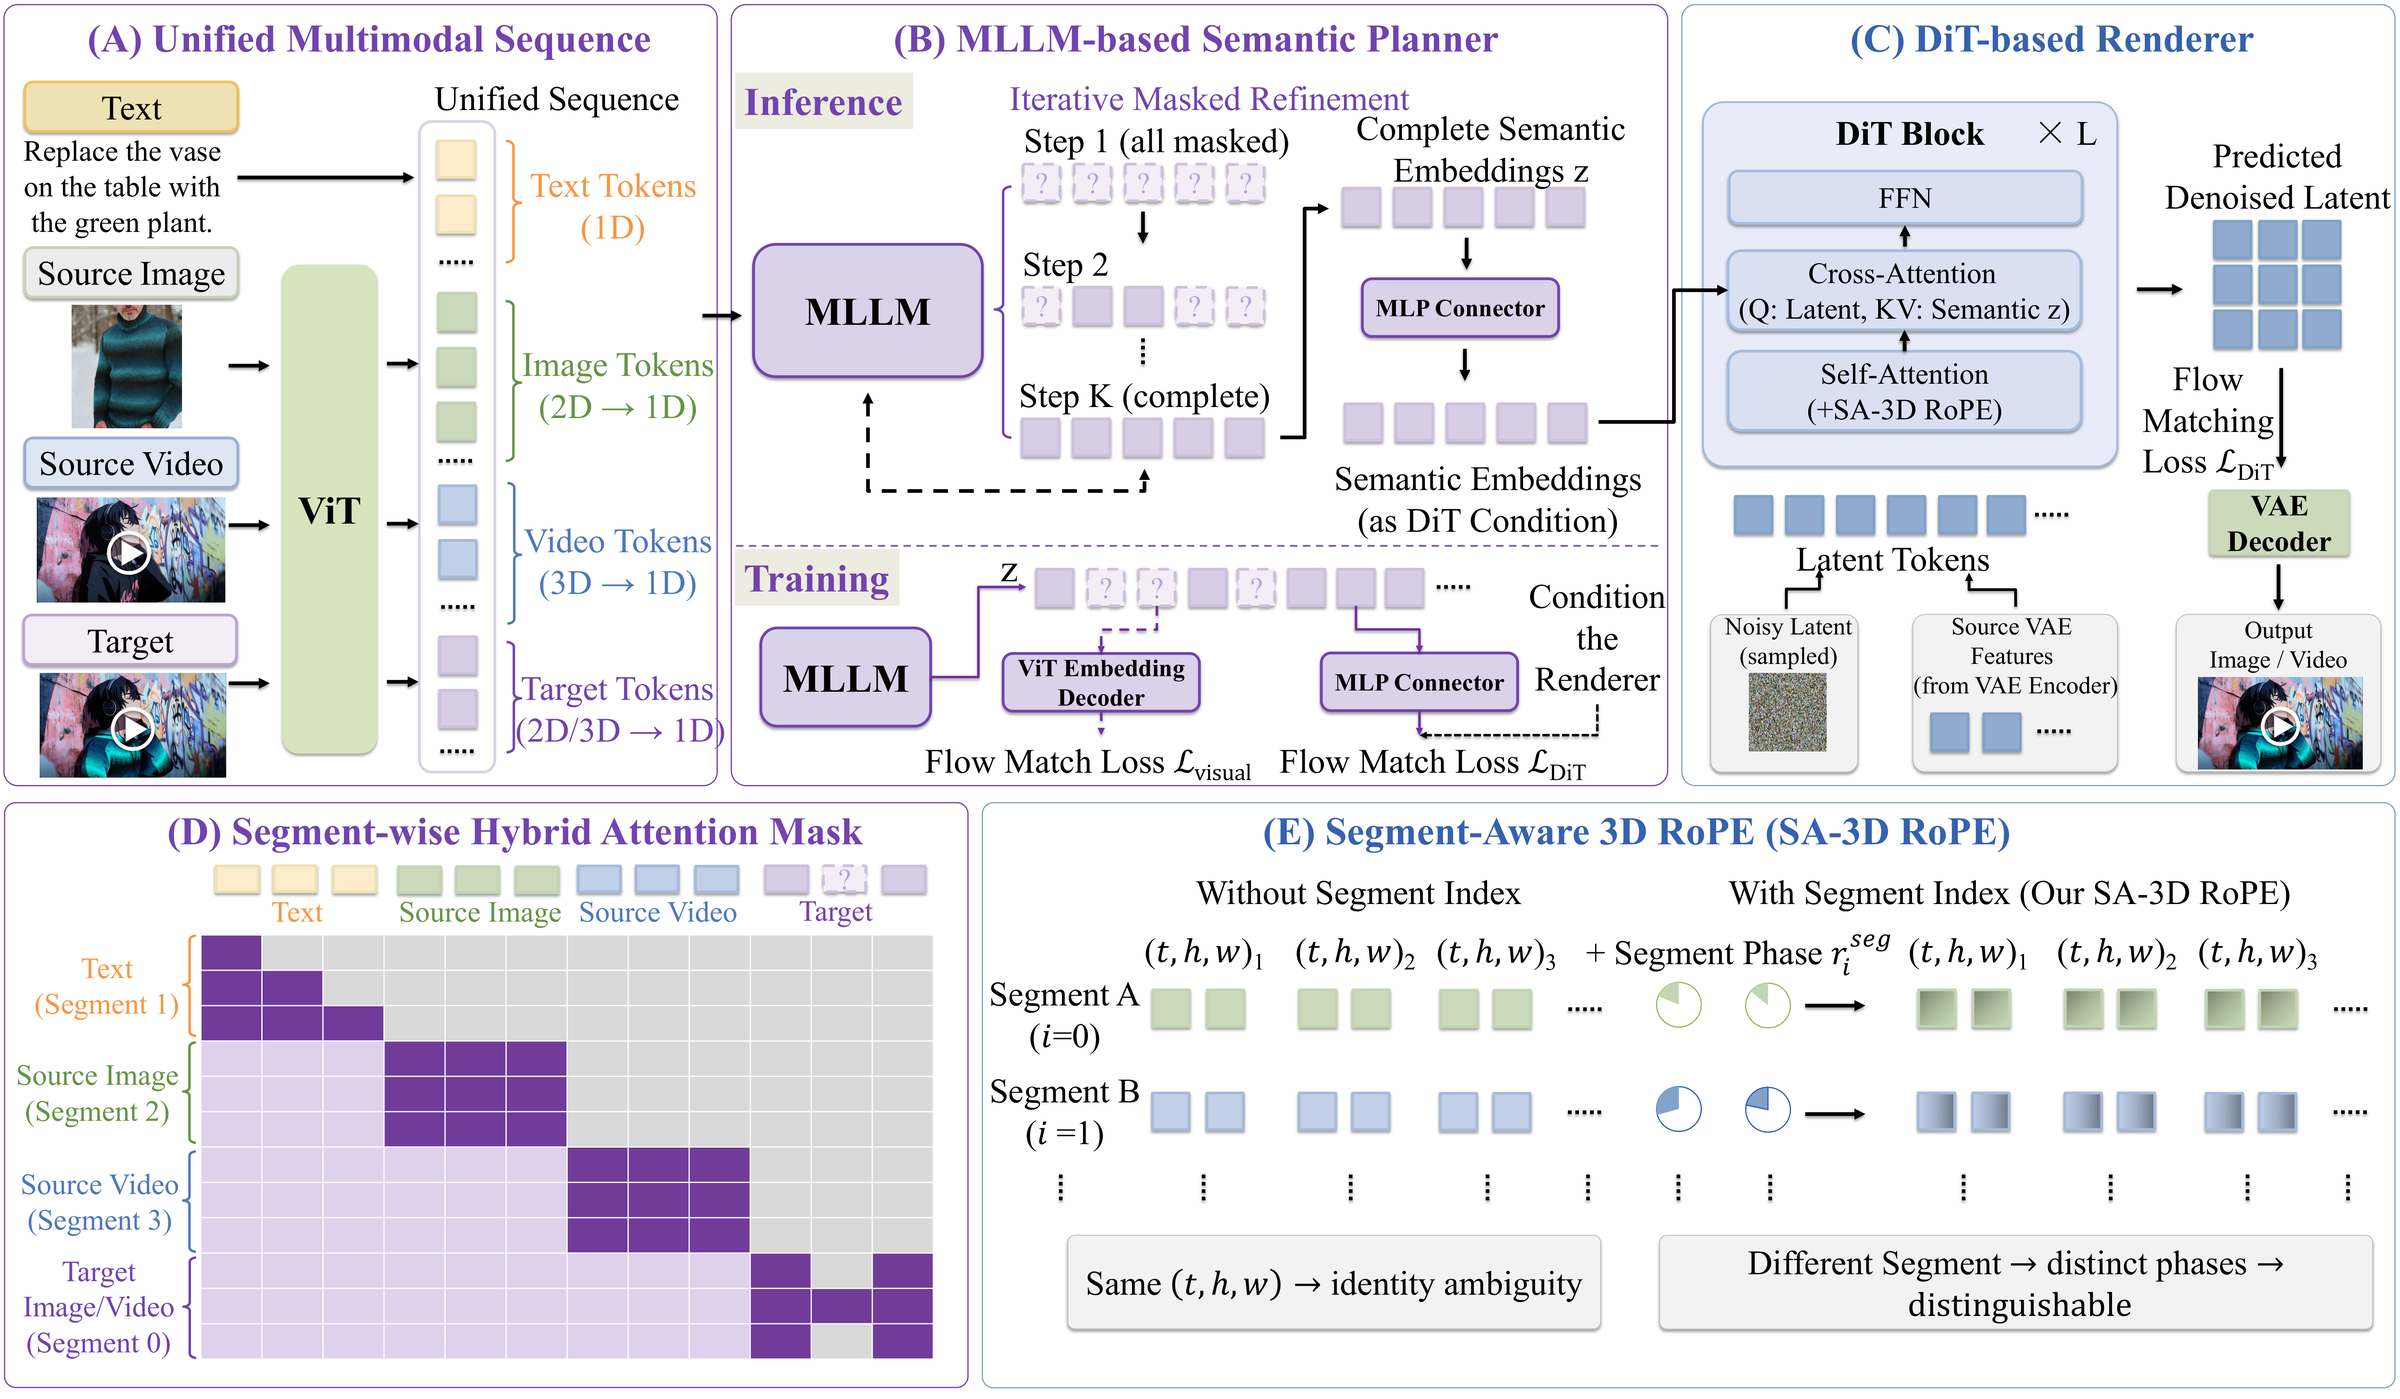
AIGC 每日速读|2026-05-25|字节Bernini让MLLM规划DiT渲染视频 今日 AIGC 论文速览 今日共 11 篇 · 统一视频生成与编辑 2 篇 · Unified Audio 与音乐生成 2 篇 · 文生图基础架构与高清解码 3 篇 · 视频世界模型与可控生成 2 篇 · 高效推理与长上下文 2 篇 重点论文标题列表 Bernini:MLLM做语义规划DiT做像素渲染 StepAudio 2.5:单一音频基础模型三任务全SOTA ⚡ PiD:512潜变量→2048图像 <1秒解码 SCOPE:首个跨游戏FPS世界模型zero-shot迁移 DecQ:8个查询+3.9%算力把RAE重建拉满 今日论文速览 1. Bernini:MLLM做语义规划DiT做像素渲染 Bernini: Latent Semantic Planning for Video Diffusion | 字节跳动 Bernini Team | arXiv:2605.22344 关键词:统一视频生成·MLLM 规划·DiT 渲染·SA-3D RoPE·CoT ⚠️ 前序问题:MLLM 擅长跨模态推理与语义对齐,扩散模型擅长高保真像素合成——但目前两条路线要么混入一个端到端 unified model(损失各自强项),要么靠 adapter 松耦合(语义传递不充分)。视频生成与编辑亟需一种新分工,能把 MLLM 的语义规划能力和 DiT 的像素渲染能力同时榨干 本文贡献:提出 Bernini 统一视频生成与编辑框架:MLLM 规划器直接在 ViT embedding 空间预测目标语义表征(不是文本),DiT 渲染器以这个语义 plan 为主条件,文本特征 + 编辑场景下的源视频 VAE 特征做辅助引导。规划器和渲染器分开训练 + 轻量协同微调,保住各自预训练能力。引入 SA-3D RoPE(Segment-Aware 3D RoPE)处理多视觉输入,并在规划器中引入 CoT reasoning 把「理解」翻译成「生成指令」 实验效果:在多项视频生成与视频编辑 benchmark 上达到 SOTA;编辑任务上 MLLM 的预训练理解力可直接迁移为强泛化能力——挑战性编辑场景下尤其明显 批判点评:「MLLM 当规划器、扩散模型当渲染器」是非常合理的下一代统一架构分工——既避免了端到端 unified model 的能力打架,也比 adapter 路线传递了更丰富的语义。但论文用 ViT embedding 而非文本作为接口让组件互换性变差,规划器换到其他 MLLM 需要重新对齐;SA-3D RoPE 在多视觉输入场景的扩展上限(如 5+ 参考图)未充分测试 2. StepAudio 2.5:单一音频基础模型三任务全SOTA StepAudio 2.5 Technical Report | 阶跃星辰 StepFun | arXiv:2605.23463 关键词:Unified Audio·ASR·TTS·实时对话·RLHF ⚠️ 前序问题:Unified audio-language model 是大趋势,可现实是它们在 ASR/TTS/实时对话三件事上常常打不过专用系统——语义理解、生成合成、低延迟对话天生有结构与目标差异。如何让一个 backbone 同时压过三个专用 SOTA 是开放挑战 本文贡献:StepAudio 2.5 把「模态接口统一」与「目标分化」分两层处理:文本与音频共享多模态表征空间作为底座,任务特化由「数据构造 + 优化目标 + 解码策略」三件事决定。重头戏是把 post-training 从标准 SFT 升级为「任务定制 RLHF」——ASR 用可验证 multi-token decoding 提速、TTS 用 preference-based RLHF + context-rich supervision 保表现力、Realtime 用 generative reward modeling 框架优化人格一致与低延迟 实验效果:在 ASR / TTS / Realtime 三个方向的标准 benchmark 上同时达到 SOTA,证明「单一音频语言基础模型在三个目标上压过专用系统」是可行的——RLHF 是统一 backbone「分化部署」的关键钥匙 批判点评:把「目标分化交给 RLHF」是非常聪明的分工——既保住统一架构的训练效率,又给三个任务留出独立优化空间。但论文的 RLHF 训练成本巨大且对各任务的奖励信号设计依赖深,落地复现门槛高;与 GPT-4o / Gemini 这种闭源多模态对话模型的实时对话直接对比缺失 3. PiD:512潜变量→2048图像 <1秒解码 PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion | NVIDIA, 多伦多大学, Vector Institute | arXiv:2605.23902 关键词:Pixel Diffusion·高清解码·DMD2 蒸馏·6× 加速·RAE ⚠️ 前序问题:T2I 主流采用「潜空间扩散 + decoder 还原像素」两段式,但 decoder 是重建优化的——只学逆向 encoder,并不主动合成细节。当目标分辨率拉到百万级(megapixel),decoder 的计算变得非常昂贵,画质上限也被牢牢锁死 本文贡献:提出 PiD(Pixel Diffusion Decoder):把「latent → pixel」decoding 改写成「条件像素扩散」,统一了解码与超分两步。直接在高分辨率像素空间去噪,原生支持 4× / 8× 上采样;通过轻量 sigma-aware adapter 把含噪 latent 注入像素扩散 backbone,使 PiD 能在 latent 还没去噪完时提前接手,让上游 latent diffusion 提前停步。再用 DMD2 蒸馏把推理压到 4 步。同时支持普通 VAE latent 和语义 latent(SigLIP/DINOv2,给 RAE 模型用) 实验效果:512×512 latent 解码为 2048×2048 像素在消费级 RTX 5090 上 <1 秒(峰值 13GB),在 GB200 上最快 210ms——比 cascaded diffusion-based super-resolution 快约 6×,视觉保真度也更好。直接把「高清文生图」的推理成本拉到接近实用区间 批判点评:把 decoder 从「重建优化」改为「条件生成优化」是非常正确的方向——这是 RAE 路线之外又一条反思 latent decoding 的工作。<1 秒 2K 解码 + 6× 加速是少有的同时省时又提质的硬数字;但 PiD 与原生 pixel-space 扩散(如 PixArt-Σ pixel)之间的对比仍未完全展开,DMD2 4-step 蒸馏的稳定性如何随分辨率扩展仍需观察 4. SCOPE:首个跨游戏FPS世界模型zero-shot迁移 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 国科大 UCAS-Terminus AI Lab, 新加坡国立 NUS, 浙江大学, 港科大广州 | arXiv:2605.23345 关键词:FPS 世界模型·视频扩散·跨游戏迁移·CrossFPS·per-pixel 条件 ⚠️ 前序问题:FPS(第一人称射击)游戏的可玩世界模型,每一帧都要响应高频重叠的多种操作信号,同时还不能扰动屏幕中无关区域。已有方案要么全图注入动作信号(粒度太粗),要么只在单款游戏上训(无法跨游戏迁移) 本文贡献:观察到 FPS 操作具有「空间选择性」:开火/换弹只影响武器周围的局部 scope,而镜头/移动指令影响全局背景。SCOPE 在预训练视频扩散 transformer 的每个 block 插入条件模块,把特征重塑成 per-pixel 时序序列,每个位置根据本地视觉内容计算自己的动作响应——不依赖任何分割标注就把 in-scope 效果与 out-of-scope 生成分开。同时构建 CrossFPS:首个多游戏 FPS 数据集(7 款游戏、69K 帧对齐 10-DoF 控制信号片段),让模型学到游戏无关的视觉-动作映射 实验效果:训得的世界模型在多个未见场景上 zero-shot 迁移成功,动作响应度强、scope 分离精确,跨游戏泛化效果优——首次让 FPS 世界模型走出「单游戏专门训」的范式 批判点评:「scope 局部 vs 全局」的解构是非常贴近 FPS 物理直觉的观察,per-pixel 时序条件注入比全图条件优雅得多。CrossFPS 数据集让 FPS 世界模型有了 ImageNet 时刻的基础;但 10-DoF 控制信号离真实玩家的复杂连招仍有距离,对长 horizon 一致性(数百帧战斗)效果论文未充分披露 5. DecQ:8个查询+3.9%算力把RAE重建拉满 DecQ: Detail-Condensing Queries for Enhanced Reconstruction and Generation in Representation Autoencoders | 复旦大学, 上海 AI Lab | arXiv:2605.22777 关键词:RAE·DINOv2·细节 Query·重建生成解耦·3.9% 算力 ⚠️ 前序问题:Representation Autoencoder(RAE,把视觉基础模型当 tokenizer encoder)能让 latent diffusion 收敛更快、生成更好——但 VFM 必须冻住,限制了细粒度重建能力。如果反过来微调 VFM 解锁重建,又会破坏预训练语义空间、拖累生成。重建 vs 生成长期是 trade-off 本文贡献:DecQ 思路简单优雅:用一组轻量「detail-condensing queries」通过 condenser 模块从中间层 VFM 特征里抽取细粒度信息,再把这些 query 拼到 decoder 端辅助重建,同时在生成建模阶段与 patch token 一起被预测。深浅两层信息都被聚合,无需碰 VFM 主权重,重建-生成 trade-off 被巧妙绕开 实验效果:DINOv2-based RAE 上仅加 8 个 query 和 3.9% 额外算力,PSNR 从 19.13 dB 提到 22.76 dB(重建端 +3.6dB);生成端比 RAE 收敛快 3.3×,无 guidance FID 1.41、有 guidance FID 1.05——重建与生成同时提升且开销可忽略 批判点评:「不碰冻结 VFM、只加一组 query 当辅助通道」是非常 ROI 高的设计,是「冻结 vs 微调」之外的第三条路。从 PSNR / FID 数字看是确凿的正向贡献;但 8 个 query 是否够撑起更大分辨率(512+)下的细节量级仍待验证,与最新 token-merging / FlexQuery 等类似工作的对比略浅 6. SEGA:DiT训练免微调按频段动态缩放注意力 SEGA: Spectral-Energy Guided Attention for Resolution Extrapolation in Diffusion Transformers | 多伦多大学, Vector Institute | arXiv:2605.22668 关键词:DiT·分辨率外推·RoPE·训练免微调·频段自适应 ⚠️ 前序问题:DiT 在训练分辨率之外生成时画质显著掉,目前 training-free 方案常用 RoPE 外推 + 注意力 scaling 修正,但 scaling 都是一刀切——对 RoPE 各分量(含不同频段)施加同样的缩放,导致「全局结构 vs 细节恢复」此消彼长 本文贡献:提出 SEGA:完全 training-free,根据每个去噪步 latent 的空间-频段结构,动态地对 RoPE 不同分量分别 scaling。低频分量保结构、高频分量恢细节,按内容自适应分配——而不是固定常数 实验效果:多个目标分辨率上一致提升 DiT 高分辨率合成质量,超过现有 training-free 基线;不需要重训,可即插即用 批判点评:「不同频段差别 scaling 而不是常数」是经过谱分析后的小而正确的改进,对 DiT 高清生成是廉价收益。但论文主要在 SD3/FLUX 系列上验证,更激进外推倍率(如 4×)下是否仍稳健没充分展开;与 ScaleCrafter / FreeU 等同类训练免微调方案的端到端定量对比较少 7. Gated DeltaNet-2:线性注意力擦写解耦1.3B全面胜出 Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention | NVIDIA | arXiv:2605.22791 关键词:线性注意力·Gated DeltaNet·擦写解耦·长上下文·NVIDIA ⚠️ 前序问题:线性注意力把无界 softmax cache 压缩成固定 recurrent state,难点不在于「忘掉什么」而在于「怎么编辑这个压缩记忆而不打乱已有联系」。已有 Delta-rule 模型用 scalar gate 同时控制 key 端的擦除和 value 端的写入——一个标量做两件事,能力被绑死 本文贡献:Gated DeltaNet-2(GDN-2)泛化了 Gated DeltaNet 与 KDA:把 erase 与 write 解耦成两个 channel-wise gate(擦除门 b_t / 写入门 w_t);两者塌缩到同一 scalar 时退化为 KDA,再叠加 decay 塌缩则退化为 Gated DeltaNet。配套给出 fast-weight 更新视角、chunkwise WY 算法(channel-wise decay 吸收到非对称 erase 因子)、gate-aware backward——保住了高效并行训练 实验效果:1.3B 参数在 100B FineWeb-Edu tokens 上训完,在语言建模/常识推理/检索上综合超过 Mamba-2 / GDN / KDA / Mamba-3 变体;在 RULER 长上下文 needle-in-a-haystack 多 key retrieval 上优势最大,纯循环与混合架构都强。代码开源 批判点评:「擦除/写入解耦」是 linear attention 设计上一个本应早被做的细节修正——一个 gate 控两件事本来就是工程妥协。GDN-2 是少有「同时改写规则又保住并行训练」的设计;但论文聚焦语言建模,对视觉生成场景(视频扩散 / 多模态 backbone)线性注意力替换的实际收益尚需后续验证,1.3B 规模在 7B+ 是否仍领先 Mamba-3 也是开放问题 8. Geo-Align:首个相机控制视频生成RL几何奖励 Geo-Align: Video Generation Alignment via Metric Geometry Reward | 中科大, 上海 AI Lab, 浙大 | arXiv:2605.23903 关键词:相机控制视频·RL 对齐·metric 3D 奖励·video re-rendering ⚠️ 前序问题:相机控制视频生成(video-to-video re-rendering)此前几乎全靠合成数据上的 SFT,真实多视角同步视频极度稀缺,模型在真实 OOD 视频上对物理尺度与相机轨迹的遵循非常差——「能拍但不像」一直没解决 本文贡献:Geo-Align 首次为相机控制视频再渲染提出 RL 框架:基于预训练模型,用「尺度感知感知奖励」对齐。具体而言引入 metric 3D estimator 从生成视频中抽取精确相机轨迹,对 rotation / translation 偏差显式惩罚;数据 pipeline 精心设计——以真实条件视频 + 合成数据派生的目标相机轨迹训练,消除对 paired data 的依赖 实验效果:相机可控性与视觉保真度同时优于现有 SFT 基线,验证 metric geometry 奖励是补救「合成 → 真实」迁移损耗的有效手段——是 video re-rendering 的下一步 批判点评:把 video re-rendering 从 SFT 推进到 RL + 几何奖励是必然的下一步,metric 3D estimator 当 reward model 思路漂亮;但 metric 3D estimator 本身的精度上限直接决定奖励质量,对动态场景(人物快速运动、遮挡)的估计误差如何不被奖励放大需要后续验证 9. LMDM:消费级笔记本跑实时音乐扩散 Live Music Diffusion Models: Efficient Fine-Tuning and Post-Training of Interactive Diffusion Music Generators | UC San Diego, CMU, Mila, Northeastern | arXiv:2605.22717 关键词:音乐扩散·实时生成·KV Cache·ARC-Forcing·consumer GPU ⚠️ 前序问题:现在最强的「实时流式音乐生成」走的是 discrete-AR(离散自回归)路线,训练和推理都要工业级算力。开源社区强势的音频扩散是双向、非流式的——理论上不能做实时演奏 本文贡献:LMDM 重新审视 block-wise outpainting 扩散管线:识别出诸多推理瓶颈是它比 discrete-AR 慢的根因,提出 block-wise KV Caching 补回;进一步引入 ARC-Forcing post-training,无需 RL 或 reward model 就能稳健做对齐,缓解 error accumulation 实验效果:扩散模型首次在推理复杂度上反超离散 AR 路线,能在消费级游戏本上本地实时跑——支持文条件生成、草图条件音乐合成、jamming;论文还展示了 LMDM 作为「generative delay」在真人音乐家即兴演奏中的真实艺术家-AI 合作 批判点评:把扩散从「非流式」拉到「实时演奏」是开源社区音频生成的关键一步——把 KV Cache 思路从语言模型迁过来很合理。但和 Suno/Udio 这类闭源系统直接对比缺失,对极长(>10 分钟)持续演奏的稳定性论文未深入讨论;ARC-Forcing 替代 RLHF 的 robustness 在不同流派/复杂编曲下的表现仍需更多实验 10. ETCHR:图像编辑器即多模态推理助手 ETCHR: Editing To Clarify and Harness Reasoning | 上海 AI Lab, 港中文 | arXiv:2605.23897 关键词:Think with Images·图像编辑·推理增强·VLM 奖励·MLLM 解耦 ⚠️ 前序问题:MLLM「think with images」范式越来越火,但 toolkit 路线被固定动作束缚,unified 路线产生的中间图常常很噪。如果想用「专用图像编辑器」当 MLLM 的视觉推理助手,会遇到两个 gap:(1) language-side,被动指令跟随的编辑器无法把抽象问题映射成合适的视觉变换;(2) generation-side,推理深度增加时编辑正确性快速退化 本文贡献:ETCHR 提出一个「question-conditioned, reasoning-aware」图像编辑器,与下游 understanding model 完全解耦。两阶段训练:第一阶段 Reasoning Imitation(在编辑轨迹上 SFT),第二阶段 Reasoning Enhancement(用 VLM-derived 奖励同时优化编辑正确性 + 下游推理准确率)。解耦让 ETCHR 可以 plug into 任意开闭源 MLLM 而无需重训 实验效果:覆盖细粒度感知/图表理解/逻辑推理/拼图复原/3D 理解 5 类任务,Pass@1 平均提升:Qwen3-VL-8B +4.82(55.95→60.77)、Gemini-3.1-Flash-Lite +5.47(65.08→70.55)、1T MoE Kimi K2.5 +4.61(76.55→81.16)——证明 reasoning-aware editor 通用有效 批判点评:「编辑器作为 MLLM 的可插拔视觉推理助手」是非常正确的下一步分工,比 toolkit / unified 两条路线都更模块化。但 ETCHR 训练强依赖 VLM-derived rewards,奖励信号的偏差可能复制到编辑器;与最新 unified MLLM(如 GPT-4o Image / Bagel)端到端的 think-with-image 能力对比还需要更全面 11. Swift Sampling:泰勒展开找时序惊奇帧0.02倍开销 Swift Sampling: Selecting Temporal Surprises via Taylor Series | Microsoft Research India | arXiv:2605.22678 关键词:长视频·帧选择·预测编码·Taylor 展开·训练免微调 ⚠️ 前序问题:长视频里大部分帧冗余,关键信息藏在「时序惊奇」——视觉特征偏离了预测轨迹的瞬间。已有 training-free 帧选择要么靠辅助网络(额外算力),要么靠视频特化的超参(不通用) 本文贡献:受脑科学预测编码启发,Swift Sampling 把视频建模成视觉 latent 空间里可微的轨迹,计算 velocity 和 acceleration,用 Taylor 展开预测后续帧的「预期路径」。偏离预期最猛的帧 = 时序惊奇帧 = 应被采样的关键帧。训练免微调、几乎零额外开销 实验效果:比基线只多 0.02× 算力开销(比领先方法的 overhead 还低 30×)。3 个长视频 QA benchmark + 10 个下游任务上一致优于 uniform sampling 与其他 query-agnostic 基线;长视频小预算场景下提升最大(+12.5 分准确率) 批判点评:「预测编码 → Taylor 外推 → 惊奇帧」的链条简洁且物理直觉强,几乎零成本是工程上极少见的免费收益。但 Swift Sampling 是 query-agnostic 的——任务相关的关键帧(需要 query-conditional)仍是它的盲区,未来与 query-aware 方法的组合空间巨大 趋势观察 统一架构出现新分工:MLLM 当语义规划器,扩散/像素模型当渲染器 — Bernini 用 MLLM 在 ViT embedding 空间预测目标语义,DiT 拿这个 plan 当主条件渲染像素;ETCHR 把编辑器训成 MLLM 可插拔的视觉推理助手——「端到端 unified」之外,「语义规划 + 像素渲染」的分工路线正在成型。这条路线把各组件的预训练能力都榨干,比 adapter 更深、比端到端更模块化 像素空间扩散解码器替代传统 VAE:高清/高效解码的新范式 — PiD 把 latent→pixel 改成条件像素扩散,512 latent <1 秒解到 2048 像素(消费级 RTX 5090),比 cascaded SR 快 6× 且画质更好;DecQ 不动 RAE 冻结 VFM 只加 8 个 query + 3.9% 算力就让重建 PSNR +3.6dB、生成收敛快 3.3×——「decoder 该重建还是该生成」的争论开始让位给「decoder 应同时承担解码与上采样」的新范式 Unified Audio 模型靠任务定制 RLHF 同时压过专用系统 — StepAudio 2.5 把 ASR/TTS/Realtime 三件事架在共享 backbone 上,让任务分化交给「数据 + RLHF reward + 解码策略」三件套——ASR 用可验证 multi-token decoding、TTS 用 preference RLHF、Realtime 用 generative reward modeling,最终三项 benchmark 同时 SOTA。证明「unified 不必妥协」的关键钥匙是 RLHF 视频生成对齐从 SFT 走向几何/物理约束的强化学习 — Geo-Align 首次给相机可控视频再渲染加 RL:用 metric 3D estimator 抽取相机轨迹,对 rotation/translation 偏差显式给奖励,不再依赖稀缺的 paired 真实多视角数据。SCOPE 的 per-pixel 时序条件设计也隐含「空间选择性」的物理直觉——视频生成的对齐方式开始引入几何/物理约束 推理期免训练优化在文生图/长视频/长上下文遍地开花 — SEGA 给 DiT 做按频段自适应注意力 scaling 解决高分辨率外推;Swift Sampling 用 Taylor 展开找时序惊奇帧选关键帧(0.02× 开销 +12.5 分);GDN-2 把线性注意力的 erase/write 解耦改善长上下文检索——「免训练 + 信号利用」的范式从图像扩散扩到视频/语言全场景,给落地侧带来快速收益 人工智能炼丹君 整理 | 2026-05-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
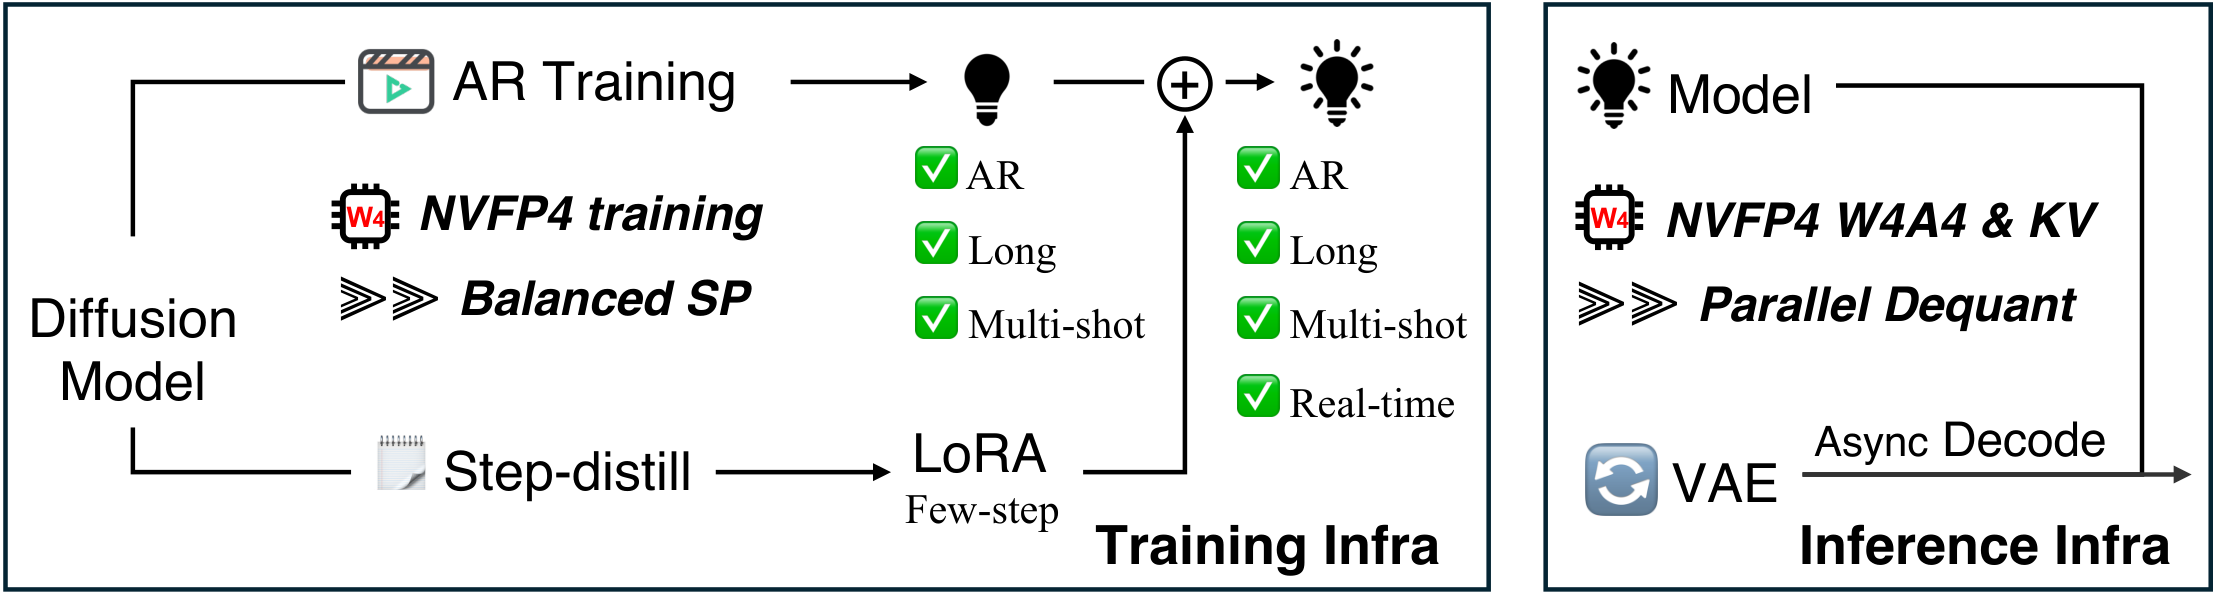
AIGC 每日速读|2026-05-19|长视频生成FP4训推全栈LongLive-2.0 今日 AIGC 论文速览 今日共 13 篇 · 长视频生成与训推优化 2 篇 · 扩散推理加速与量化 4 篇 · 视频编辑与实时特效 2 篇 · 统一多模态生成 1 篇 · 音频生成与综述 2 篇 · 扩散 RL 后训练 2 篇 重点论文标题列表 LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× TACache:Rectified Flow 训练免训练加速 4.14× Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Lance:原生统一图像视频理解生成 MoE 模型 StreamingEffect:单 H200 实时 720p 人像视频特效 今日论文速览 1. LongLive-2.0:NVFP4 长视频生成训推全栈提速 2.15× LongLive-2.0: An NVFP4 Parallel Infrastructure for Long Video Generation | NVIDIA | arXiv:2605.18739 关键词:长视频生成·NVFP4·序列并行·AR 视频扩散·Song Han 前序问题:长视频生成的训练和推理同时卡在显存和速度上:现有 Self-Forcing 系列依赖 ODE 初始化 + DMD 蒸馏,流程冗长;推理端把 KV cache 与计算精度压不下去,使得分钟级、多镜头、可交互的 AR 视频生成在大模型规模下难以落地 本文贡献:提出 LongLive-2.0:首个 NVFP4 端到端长视频生成训练 + 推理基础设施。(1) 训练侧的 Balanced SP——把 teacher-forcing 布局与序列并行(SP)协同设计,在每个 rank 上配对干净历史 + 噪声目标的时间块,并搭配 SP-aware 分块 VAE 编码;(2) 直接把扩散模型微调成长时多镜头交互式 AR 模型,跳过 ODE 初始化 + DMD 蒸馏;(3) 推理侧 Blackwell 上跑 W4A4 NVFP4,KV cache 也量化到 NVFP4,配合异步流式 VAE 解码 实验效果:训练加速 2.15×、推理加速 1.84×;LongLive-2.0-5B 在保持 benchmark 强表现的同时达到 45.7 FPS 推理;可独立 LoRA 切换为 4 步 / 2 步实时生成模式,是首个面向长视频生成的 NVFP4 训推一体系统 批判点评:把 NVFP4 这种 Blackwell 新精度从推理推到训练全链路是工程级里程碑,5B 跑出 45.7 FPS 把长视频 AR 推到了实时门槛;但 NVFP4 对硬件的强绑定限制了非 Blackwell 集群的复现路径,量化 KV cache 在多镜头切换时的累积误差也值得长期追踪 2. TACache:Rectified Flow 训练免训练加速 4.14× Accelerating Rectified Flow Models via Trajectory-Aware Caching | 上海交大, 军事科学院, 华为 | arXiv:2605.16789 关键词:Rectified Flow·训练-free 加速·缓存·正交分解·扩散推理 前序问题:扩散与 Rectified Flow 模型靠迭代评估速度场出图/出视频,计算昂贵;现有 cache 方法靠跳步加速,但粗略的近似在长跳步区间累积误差大,激进加速下质量明显劣化 本文贡献:提出 TACache(Trajectory-Aware Cache)训练-free 加速框架,遵循「先跳步后补偿」范式:对 RF 轨迹上离散速度加速度做正交分解(平行 + 正交残差),分离每步近似误差的幅值与方向来源;离线阶段用幅值 / 方向累积阈值生成跳步表,在线阶段结合样本历史正交方向重构被跳过的速度,无需额外模型评估 实验效果:在 BAGEL、FLUX.1-dev、Wan2.1-1.3B 上分别实现文生图 4.14×、文生视频 2.11× 加速;在所有 reference-based fidelity 指标上一致优于已有 cache 类方法 批判点评:「先跳步后补偿」+ 速度加速度正交分解,把 cache 类方法从经验调参推到了误差可控的工程范式;但分解效果对模型与数据集分布敏感,离线统计在 prompt 分布漂移时是否仍稳定,还需要更长尾的验证 3. Aurora:VLM Agent 把模糊指令拆解给视频编辑器 Aurora: Unified Video Editing with a Tool-Using Agent | 罗切斯特大学, Adobe | arXiv:2605.18748 关键词:视频编辑·VLM Agent·工具调用·统一扩散·欠规范请求 前序问题:现有统一视频编辑模型把文本、源视频、参考图喂进同一个 DiT 一把搞定替换 / 删除 / 风格 / 参考插入;设计很灵活,但默认用户已提供了 model-ready 的文本、参考图与空间锚定——真实请求里这些往往缺失 本文贡献:提出 Aurora:把工具增强 VLM agent 与统一视频扩散 transformer 配对——agent 把原始用户请求映射成对齐 transformer 条件通道的结构化编辑计划,先解决「文本和视觉欠规范」再生成;用监督数据训练完整编辑规划 + 参考图选取,再用偏好对训练鲁棒工具调用与指令润色;并发布 AgentEdit-Bench 评估「欠规范用户请求」下的 agentic 视频编辑能力 实验效果:在 AgentEdit-Bench 与两个现有视频编辑 benchmark 上,Aurora 显著超越纯指令 baseline;VLM agent 还能迁移到其他冻结的视频编辑模型,作为通用前置规划层 批判点评:把视频编辑里「用户输入欠规范」这一真实痛点显式拆解给 VLM agent 处理,是务实且可迁移的范式;但 agent 错误规划带来的级联编辑错误尚未充分量化,agent + DiT 的端到端延迟也是落地前要解决的关键 4. Lance:原生统一图像视频理解生成 MoE 模型 Lance: Unified Multimodal Modeling by Multi-Task Synergy | 字节跳动 Intelligent Creation Lab | arXiv:2605.18678 关键词:统一多模态·MoE·双流架构·原生训练·图像视频生成 前序问题:统一多模态模型要么靠模型尺寸堆量、要么沿用图文为主的设计,在「图像 + 视频 × 理解 + 生成 + 编辑」的全格子上很难一并打通;理解和生成两条能力路径互相干扰,多模态 token 异质性也让位置编码难以兼顾 本文贡献:提出 Lance:原生轻量级统一多模态模型,从零训练,采用「双流 MoE + 共享交错多模态序列」架构——联合上下文学习同时把理解与生成的能力路径解耦;引入 modality-aware RoPE 缓解异质视觉 token 的相互干扰;训练采用分阶段多任务范式,配合自适应数据调度同时强化语义理解与视觉生成 实验效果:图像和视频生成上大幅超越现有开源统一模型,同时保持强多模态理解能力,证明统一不必靠堆参数,「能力路径解耦」是更可持续的统一范式 批判点评:「统一上下文 + 解耦能力路径」的设计直击当前统一模型最大痛点:什么都做但什么都不极致;不过双流 MoE 的训练稳定性、与闭源旗舰模型的差距,以及在更长视频上的可扩展性仍待时间检验 5. StreamingEffect:单 H200 实时 720p 人像视频特效 StreamingEffect: Real-Time Human-Centric Video Effect Generation | 新加坡国立 Show Lab | arXiv:2605.17019 关键词:视频编辑·实时流式·人像特效·因果蒸馏·VideoEffect-130K 前序问题:电商直播、娱乐、Vlog 等场景需要实时人像视频特效,但缺数据、缺可部署的编辑模型;视频编辑的高效蒸馏几乎没人做,现有加速大多围绕文生视频,无法保住身份、背景与时序一致性 本文贡献:提出 StreamingEffect:上下文式视频编辑架构 + 因果 AR 学生蒸馏,把采样从 50 步压到 4 步;支持关键帧控制——可以在线注入参考特效帧并沿流传播,实现交互式编辑;同时构建 VideoEffect-130K 数据集——70K 特效视频 + 60K 编辑视频、600 类特效,是已知最大的人像视频特效数据集 实验效果:在单张 H200 GPU 上实现实时高质量 720p 视频编辑,数据集和方法共同填补了「人像视频特效实时编辑」的开源生态空白 批判点评:把视频编辑显式当作「实时流式 + 关键帧可控」问题来解,配套 130K 高质量数据是最大的工程贡献;但 600 类特效的覆盖度、4 步学生在长流式生成下身份漂移、以及 H200 之外的部署门槛,是产品化关键考验 6. MeanFlow-LSE:MeanFlow 蒸馏推到 80B 工业级模型 Stabilizing, Scaling & Enhancing MeanFlow for Large-scale Diffusion Distillation | 西电, 腾讯混元 | arXiv:2605.17834 关键词:MeanFlow·扩散蒸馏·大规模训练·HunyuanImage·少步生成 前序问题:MeanFlow 因公式简洁、表现强劲在少步蒸馏受关注,但优化目标不稳定 + 「mean-seeking bias」限制了它在大规模工业模型上的应用,蒸馏到 12B / 80B 级别经常训练崩溃或质量塌陷 本文贡献:(1) 引入 warm-up 技术,用离散解替代原 MeanFlow 微分解,避免 stop-gradient 项含未训好模型导致的训练崩溃;等模型对平均速度场有初步拟合后再切回微分解继续精炼;(2) 引入轨迹分布对齐作为辅助目标,缓解极少步推理下复杂目标分布上的 mean-seeking bias,让学生模型轨迹分布贴近教师 实验效果:在 FLUX.1-dev(12B)上超越现有蒸馏方法;推到 80B 的 SOTA 工业模型 HunyuanImage 3.0,依然展现出鲁棒泛化与强表现,是首次把 MeanFlow 蒸馏验证到 80B 量级 批判点评:warm-up + 轨迹分布对齐两步组合直击 MeanFlow 在大模型上的两大顽疾,工程上意义重大;但 warm-up 阶段 / 切换时机依赖经验设定,对不同 backbone 的迁移性还需更系统消融 7. I2V-Survey:图生视频扩散首份系统综述 Image-to-Video Diffusion: From Foundations to Open Frontiers | 港城大, 格里菲斯大学等 | arXiv:2605.17248 关键词:图生视频·扩散综述·I2V·taxonomy·开放挑战 前序问题:图生视频(I2V)已成为生成模型的核心方向,对内容一致性、身份保留与运动连贯性的要求都比通用视频生成更严;但现有论文大多把 I2V 当作通用视频生成的子话题,缺乏专门的 taxonomy 与系统分析 本文贡献:把扩散 I2V 单独立题,系统梳理任务定义、模型架构、数据集、评测指标,并按架构和训练范式给出 taxonomy;进一步抽取 4 个核心设计——条件编码 / 时序建模 / 噪声先验 / 时空上采样,配合典型应用与开放挑战 实验效果:为 I2V 这一独立子方向提供首份结构化综述,给出可复用的 4 大设计轴和应用-挑战双视角,便于研究者和工程团队系统理解技术路径 批判点评:把 I2V 从「视频生成的角落」抬到独立子方向,「4 个核心设计 + taxonomy」是清晰可用的索引框架;但综述截止时间内未能覆盖最新一波因果 / 实时 I2V,未来需要持续更新追踪 8. WavFlow:原始波形空间直生高保真音频 WavFlow: Audio Generation in Waveform Space | Meta AI, 东北大学 | arXiv:2605.18749 关键词:音频生成·波形空间·Flow Matching·V2A·T2A 前序问题:现代音频生成几乎都依赖潜空间压缩,引入额外复杂度并潜在丢失信息;但波形空间维度极高、能量分布稀疏,让扩散模型直接在波形上建模长期失败 本文贡献:提出 WavFlow:直接在原始波形空间生成高保真音频,无中间表示。通过 waveform patchify 把音频重塑为 2D token grid,引入 amplitude lifting 对齐信号尺度,使 flow matching 中的 x-prediction 优化稳定;并构建自动化数据流水线,整理 500 万视频-文本-音频三元组,从零学习细粒度声学模式 实验效果:在视频转音频 VGGSound 上取得 FD_PaSST 59.98 / IS_PANNs 17.40 / DeSync 0.44;在文生音频 AudioCaps 上 FD_PANNs 10.63 / IS_PANNs 12.62,与已有潜空间方法持平或超越,证明中间压缩并非高质量音频合成的必要条件 批判点评:「不要 latent,直接干波形」是颇有勇气的反潮流路线,patchify + amplitude lifting 是让 flow 在波形上稳的关键工程;但波形 flow matching 的训练成本与采样开销比 latent 方案高得多,工业级落地需要更激进的加速 9. TAPE:时序感知 token 剪枝免训加速视频扩散 Temporal Aware Pruning for Efficient Diffusion-based Video Generation | 匹兹堡大学, IIT, Rutgers, Microsoft AI | arXiv:2605.17837 关键词:视频扩散·token 剪枝·训练-free 加速·时序一致性·ViT 前序问题:视频扩散 ViT 架构出视频质量高,但长时空序列上的注意力计算极贵;已有 token 剪枝多基于 attention、按帧独立操作,难以保住跨帧时序连贯,naive 应用会产生背景不稳、闪烁、画质下降 本文贡献:提出 TAPE 训练-free 时序感知剪枝:(i) 时序平滑对齐相邻帧的 token 重要性,抑制选择抖动;(ii) 在选定层做 token 重选,使剪枝匹配各层的不同语义关注,避免误差在特定区域累积;(iii) 时间步级预算调度——早期噪声重的步骤激进剪、后期保真关键步骤放宽 实验效果:显著提速的同时保持高视觉保真度,超越前期 token reduction 方法;作为 plug-in 训练-free 加速,能直接套到现有视频扩散模型上 批判点评:把 token 剪枝从「每帧独立」拉回「时序感知」是补足视频域专属约束的正确方向,三项设计互相协同;但激进时间步预算调度对极长视频的累积误差、以及 ViT 之外架构的迁移性仍是开放问题 10. SafeDiffusion-R1:在线 GRPO + CLIP 引导奖励安全对齐 SafeDiffusion-R1: Online Reward Steering for Safe Diffusion Post-Training | MBZUAI | arXiv:2605.18719 关键词:扩散安全·在线 RL·GRPO·CLIP 引导·内容审核 前序问题:扩散模型移除预训练中学到的不安全内容,现有方法要么需要昂贵的 unsafe-text 配 safe-image 监督数据,要么走离线 RL / SFT 在合成数据上训,灾难性遗忘严重,生成质量明显劣化,扩展性差 本文贡献:提出在线 RL 框架:在正负 prompt 上跑 GRPO;引入 steering reward 机制利用 CLIP 嵌入空间的固有性质——把文本表示推向正向安全方向、远离负向,无需为每个安全维度单独训 reward 模型;在线策略让模型从包括显式不安全 prompt 在内的多样请求中学习而不灾难性遗忘 实验效果:不当内容下降到 18.07%(vs SD v1.4 的 48.9%),裸露检测 15 vs baseline 646;GenEval 组合生成质量从 42.08% 提升到 47.83%;安全增益泛化到 7 类未见有害 prompt 类别 批判点评:把「安全对齐」从离线 SFT 推到在线 GRPO,叠加 CLIP 嵌入引导避开 reward 模型训练,工程友好且可扩展;但 CLIP 嵌入方向偏向、对抗性提示下 steering 的鲁棒性,仍需对抗压力测试持续追踪 11. CGPO:按 reward 方差自适应难度的文生图 RL Curriculum Group Policy Optimization: Adaptive Sampling for Unleashing the Potential of Text-to-Image Generation | 北邮, 中国电信 TeleAI | arXiv:2605.17807 关键词:文生图·GRPO·课程学习·自适应采样·RL 对齐 前序问题:文生图 RL(特别是 GRPO 系)训练时统一采样策略忽视了样本难度与模型当前能力的匹配,训练效率低,模型常在已掌握或还远不能掌握的 prompt 上空转 本文贡献:提出 CGPO 自适应课程训练框架:每条 prompt 生成一组图像由 reward 模型打分,用组内 reward 方差作为「prompt 不一致性」的在线 proxy——方差高说明模型部分掌握但未稳定,正是最该多采的可学习 prompt,从而提高其采样概率;再用比例公平优化做类别校准,平衡多类别数据集的训练难度 实验效果:在 GenEval、T2I-CompBench++、DPG Bench 上一致提升生成性能,为 GRPO 类文生图 RL 提供可即插即用的课程化增强 批判点评:用 reward 方差当「可学习 prompt」proxy 是优雅且无需额外标注的设计;但 reward 模型本身的偏差会被该 proxy 放大,长期训练下需要监控 reward hacking 12. DiRotQ:PCA 旋转感知 W4A4 DiT 量化 DiRotQ: Rotation-Aware Quantization for 4-bit Diffusion Transformers | d-Matrix | arXiv:2605.16732 关键词:DiT·4-bit 量化·PCA 旋转·W4A4·FLUX 前序问题:DiT 出图质量 SOTA 但推理代价高;激进 PTQ 到 4-bit 能省算力却经常严重掉点;已有 smoothing / mixed precision / rotation / low-rank residual 等方法都只能部分缓解,与 FP16/BF16 仍有可见差距 本文贡献:提出 DiRotQ W4A4 PTQ 框架——通过 PCA 找到激活方差主成分所在的低秩子空间,对该子空间用更高精度保留,其余分量量化到 4-bit;推理时用校准得到的正交变换把激活旋转到 PCA 基,逆旋转离线融入权重;再叠加 GPTQ 的权重量化形成完整 W4A4 系统,并给出 Triton kernel 端到端加速 实验效果:在 PixArt-Σ MJHQ-30K 上取得 FID 15.9 / PSNR 19.1 dB,超越 SVDQuant(FID 18.9 / 17.6);12B FLUX.1-dev 在单卡 RTX 4090 上显存降 2.1×,推理比 BF16 加速 2.3×;并首次提出 VLM-as-a-Judge 评测协议 批判点评:把 PCA 子空间高精度保留 + 离线融入权重的设计,把旋转量化做到了 W4A4 的较好均衡,落地友好;但 PCA 校准对长尾 prompt 的覆盖度、VLM-as-a-Judge 与人类偏好的对齐度,是后续要追踪的关键 13. SpectralProgressive:频谱先粗后细动态扩展分辨率 Spectral Progressive Diffusion for Efficient Image and Video Generation | Stanford | arXiv:2605.18736 关键词:频谱扩散·渐进分辨率·训练-free 加速·视频生成·去噪调度 前序问题:扩散模型在频域里隐式自回归生成——低频先出、高频后出;在噪声主导的早期对全分辨率做计算大量冗余,但目前没人把这一观察系统化用于推理加速 本文贡献:提出 Spectral Progressive Diffusion 通用框架——沿去噪轨迹渐进扩展分辨率;设计频谱噪声扩展机制,并从模型自身的功率谱推出最优分辨率调度;支持 training-free 加速和一种新的微调配方,进一步同时改善效率与质量 实验效果:在多个 SOTA 预训练图像和视频生成模型上获得显著加速,且画质保持;为预训练扩散模型提供一条「无需重训」的频谱渐进推理路线 批判点评:把扩散「频谱自回归」的隐式行为显式化为分辨率调度,思路清晰且与 cache 等加速正交;但频谱调度对噪声分布的假设强依赖训练分布,跨数据集与跨模态迁移性需更广验证 趋势观察 NVFP4 把长视频生成训推一体化推到实用门槛 — LongLive-2.0 把 NVFP4 从纯推理量化推到训练 + KV cache + 异步流式 VAE 解码全链路,5B 模型跑出 45.7 FPS——下一代视频生成基础设施开始与 Blackwell 硬件深度协同,长视频 AR 真正走向「可部署的实时」 扩散加速从 cache 推到「频谱 + 时序 + 量化」三路同时压榨 — TACache 从轨迹正交分解给跳步补偿、TAPE 从时序感知做 token 剪枝、SpectralProgressive 从频谱调度动态扩展分辨率、DiRotQ 从 PCA 旋转把 DiT 推到 W4A4——扩散推理优化第一次在「时间步 / 空间 token / 数值精度 / 频谱通道」四个轴上系统并进 视频编辑进入 agent 时代 — Aurora 把模糊用户请求交给 VLM agent 拆解成结构化编辑计划再喂给 DiT;StreamingEffect 配套 130K 数据 + 4 步因果蒸馏直接做实时人像特效——视频编辑从「模型一把吃下所有输入」转向「agent 解码意图 + 模型专注生成」 统一多模态从堆参数走向「能力路径解耦」 — Lance 用「双流 MoE + 共享交错序列」把理解与生成的能力路径显式解耦,配合 modality-aware RoPE 处理 token 异质性;证明轻量原生设计也能在「图像 + 视频 × 理解 + 生成 + 编辑」全格子上同时领先 扩散 RL 对齐从 reward 工程走向 reward 机制 — SafeDiffusion-R1 用 CLIP 嵌入做 steering reward 替代专门 reward 模型;CGPO 把 reward 方差当 prompt 难度 proxy 实现自适应采样——扩散 RL 后训练正在从「堆 reward 模型」转向「挖 reward 信号本身的几何」 人工智能炼丹君 整理 | 2026-05-19 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
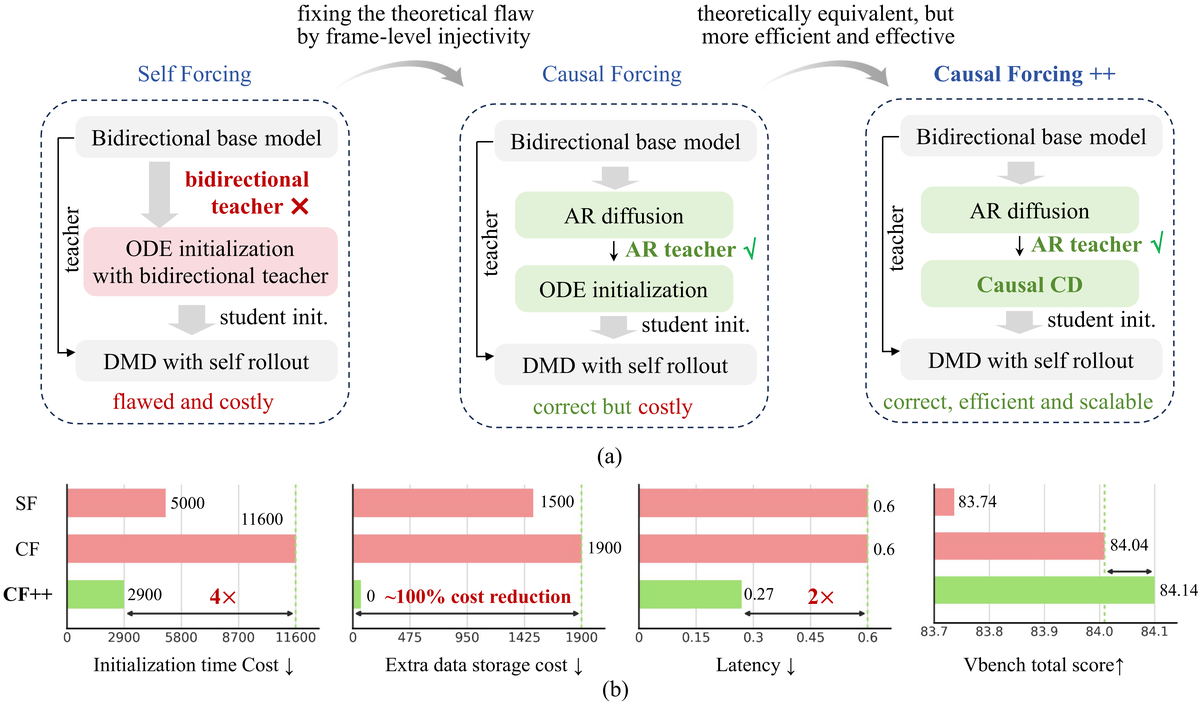
AIGC 每日速读|2026-05-15|实时视频2步出帧Causal Forcing++ 今日 AIGC 论文速览 今日共 8 篇 · 实时 AR 视频与世界模型 3 篇 · 相机控制与视频生成 2 篇 · 图像编辑持续学习 1 篇 · 扩散模型 RL 后训练 1 篇 · 视频世界模型评测 1 篇 重点论文标题列表 Causal Forcing++:因果一致性蒸馏 Warp-as-History:把相机引起的形变直接转化为「相机扭曲 ACE-LoRA:动态正则化框架 RefDecoder:参考条件视频 VAE decoder DiffusionOPD:多任务训练范式 今日论文速览 1. Causal Forcing++:因果一致性蒸馏 Causal Forcing++: Scalable Few-Step Autoregressive Diffusion Distillation for Real-Time Interactive Video Generation | 清华 TSAIL, 生数科技 | arXiv:2605.15141 关键词:少步AR视频·因果一致性蒸馏·实时交互生成·世界模型·Genie3 前序问题:实时交互式视频生成需要低延迟、流式、可控的 rollout。现有自回归扩散蒸馏在 chunk-wise 4 步取得了不错效果,但 chunk 粒度过粗、采样延迟仍然不可忽略;当尝试更激进的 frame-wise 1-2 步时,少步 AR 学生的初始化策略要么目标错位、要么不能少步生成、要么算力代价大到无法 scale 本文贡献:提出 Causal Forcing++ 因果一致性蒸馏(Causal CD)流水线:核心观察是 Causal CD 学习与 Causal ODE 蒸馏相同的 AR-条件流图,但只需在相邻时间步之间用一次教师 ODE 步在线提供监督,无需预先计算并存储完整 PF-ODE 轨迹——既高效又易优化;进一步把流水线扩展到 Genie3 风格的 action-conditioned 世界模型 实验效果:在 frame-wise 2 步设定下,全面超越 SOTA 4 步 chunk-wise Causal Forcing:VBench Total +0.1、VBench Quality +0.3、VisionReward +0.335,同时首帧延迟降低 50%、Stage 2 训练成本降至约 1/4 批判点评:把蒸馏从 chunk-wise 4 步推进到 frame-wise 2 步,是实时交互式视频生成可用性上的关键一步——把瓶颈识别为「初始化」是非常贴切的诊断;但 1-2 步生成对教师 ODE 误差的放大效应、以及在更复杂 action 条件下的稳定性还需更多压力测试 2. Warp-as-History:把相机引起的形变直接转化为「相机扭曲 Warp-as-History: Generalizable Camera-Controlled Video Generation from One Training Video | 上海交大, 上海 AI Lab | arXiv:2605.15182 关键词:相机控制·视频生成·零样本·伪历史·LoRA 微调 前序问题:相机可控视频生成已经很成熟,但现有方法普遍需要在大规模带相机标注的视频上做后训练(额外的 camera encoder、控制分支、注意力/位置编码改造);training-free 方案则把代价转嫁到测试时优化或 denoising 时的额外 guidance,依然不便宜 本文贡献:提出 Warp-as-History:把相机引起的形变直接转化为「相机扭曲后的伪历史」,在 frozen 视频生成模型自带的「视觉历史」通路中喂进去——目标帧位置编码对齐、剔除没有有效观测来源的 token,无需训练或架构改动即可零样本服从相机轨迹;可选用一段相机标注视频做轻量 LoRA 微调进一步提升泛化能力 实验效果:在多个数据集上的实验显示:完全 training-free 即可让冻结视频生成模型获得不平凡的相机轨迹跟随能力;只用「一段」相机标注视频做 LoRA 微调,即可在未见视频上同时改善相机贴合度、画质与运动动态 批判点评:把相机可控问题视作「历史 warp」是一个非常优雅的视角,几乎不增加任何训练成本;但 zero-shot 能力依赖底模的「视觉历史」通路是否足够强,没有该通路的扩散视频模型迁移性可能受限;另外极端轨迹下的孔洞填充质量值得关注 3. ACE-LoRA:动态正则化框架 ACE-LoRA: Adaptive Orthogonal Decoupling for Continual Image Editing | 上海交大, vivo AI Lab | arXiv:2605.14948 关键词:持续学习·图像编辑·LoRA·正交解耦·CIE-Bench 前序问题:现有 SOTA 扩散模型靠参数高效微调(LoRA 等)适配各类图像编辑任务,但真实业务需要在不断到来的新任务上持续学习同时保留旧任务能力;图像编辑的持续学习问题至今几乎没人系统研究,灾难性遗忘问题严重 本文贡献:提出 ACE-LoRA 动态正则化框架:通过 Adaptive Orthogonal Decoupling 自动识别并正交化任务间干扰,再用 Rank-Invariant Historical Information Compression 解决持续更新中的可扩展性瓶颈;同时发布 CIE-Bench——业内首个面向图像编辑的持续学习评测基准 实验效果:在指令保真度、视觉真实感、抗遗忘鲁棒性上一致优于现有 baseline,建立了「图像编辑持续学习」这一子方向的标准方法+标准评测 批判点评:把「持续学习」首次正式带到图像编辑领域,问题设定和 benchmark 都非常务实;但 14 维基因式正交化的超参对任务序列分布的鲁棒性、以及面对几十个长尾编辑任务时压缩策略的极限,需要更长任务流的实测 4. RefDecoder:参考条件视频 VAE decoder RefDecoder: Enhancing Visual Generation with Conditional Video Decoding | University of Washington, UNC | arXiv:2605.15196 关键词:视频 VAE·参考条件 decoder·视频生成·即插即用·VBench 前序问题:主流 latent 视频扩散模型的 denoising 网络条件丰富,但 VAE decoder 几乎都是无条件的——这种结构性不对称导致细节流失、与输入参考图不一致,是当前视频生成「看起来糊糊的」的隐藏元凶 本文贡献:提出 RefDecoder 参考条件视频 VAE decoder:用一个轻量图像编码器把参考帧映射成细节丰富的高维 token,在 decoder 每个 upsampling stage 与去噪后的视频 latent token 共同处理(reference attention),让 decoder 也获得与 denoising 网络对等的条件信息 实验效果:在 Wan 2.1、VideoVAE+ 等多个 decoder backbone 上一致提升 PSNR 最多 +2.1dB(Inter4K / WebVid / Large Motion);可直接热插拔进现有视频生成系统,无需额外微调,VBench I2V 上主体一致性、背景一致性、综合质量全面提升;天然泛化到风格迁移、视频编辑精修等任务 批判点评:这是一项「补条件」的低风险高收益工作,可即插即用是工程师最爱的属性;但 decoder 端注入参考可能在大幅运动场景下与 latent 表示冲突,长视频累积误差与 reference token 选择策略仍有优化空间 5. DiffusionOPD:多任务训练范式 DiffusionOPD: A Unified Perspective of On-Policy Distillation in Diffusion Models | 阿里 Wan Team, 复旦 | arXiv:2605.15055 关键词:扩散模型 RL·On-Policy 蒸馏·多任务·Wan Team·文生图 前序问题:强化学习是改进文生图扩散模型的强力工具,但现有方法大多局限于单任务优化——多任务联合 RL 受困于跨任务干扰和不平衡,级联 RL 又笨重且易遗忘 本文贡献:提出 DiffusionOPD 多任务训练范式:先独立训练任务专属 teacher,再沿学生自己的 rollout 轨迹做 Online Policy Distillation 把多 teacher 能力蒸馏到统一学生;理论上首次把 OPD 框架从离散 token 提升到连续状态 Markov 过程,给出闭式 per-step KL 目标,统一 SDE 与 ODE refinement,方差更低、泛化更好 实验效果:一致超越多奖励 RL 与级联 RL 基线,训练效率与最终性能两端均占优,在所有评测基准上达到 SOTA 批判点评:把 OPD 严格地搬上连续扩散是漂亮的理论延伸,多任务版本对落地非常有价值;但 teacher 数量增加后蒸馏的 token-level KL 是否仍稳定、teacher 与学生 capacity 失配时的下界,仍需更大规模实验 6. RAVEN:框架 RAVEN: Real-time Autoregressive Video Extrapolation with Consistency-model GRPO | 帝国理工 AGI Lab | arXiv:2605.15190 关键词:实时 AR 视频·一致性模型·CM-GRPO·训练-测试对齐·流式生成 前序问题:因果自回归视频扩散模型靠把过去内容外推未来 chunk 实现实时流式生成,蒸馏自高保真双向教师后已能少步推理;但训练时 history 分布与推理时实际 rollout 分布之间的 gap 一直限制长序列的生成质量 本文贡献:提出 RAVEN training-time test 框架:把每次自身 rollout 重打包为「干净历史端点 + 噪声去噪状态」交错序列,让训练注意力对齐推理时的外推方式,同时让下游 chunk loss 监督未来预测所依赖的历史表示;进一步提出 CM-GRPO,把 consistency 采样步重新表达为条件高斯转移,直接在该核上做在线 RL,避免了之前 flow-model RL 公式中的 Euler-Maruyama 辅助过程 实验效果:RAVEN 在质量、语义、动态度多维评测上超越近期因果视频蒸馏 baseline;CM-GRPO 与 RAVEN 组合后进一步提升性能 批判点评:把 training-test 不一致问题正面解决并配套 CM-GRPO 是组合拳;但 RAVEN 重打包对长序列内存占用的影响、CM-GRPO 在更复杂奖励上的稳定性,还需要在更大模型尺度上验证 7. SANA-WM:2.6B 参数原生面向 1 SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer | NVIDIA, MIT, 港科大 | arXiv:2605.15178 关键词:世界模型·分钟级视频·Hybrid Linear Attention·6-DoF 相机·开源 前序问题:一分钟级别的世界模型既要画质媲美 LingBot-World、HY-WorldPlay 这些产业级大模型,又要在算力、数据、推理硬件三方面都「能用得起」——目前几乎没有开源方案能同时做到 本文贡献:提出 SANA-WM:2.6B 参数原生面向 1 分钟视频生成的开源世界模型——(1) Hybrid Linear Attention 把 frame-wise Gated DeltaNet 与 softmax attention 混合,长上下文内存可控;(2) Dual-Branch Camera Control 保证 6-DoF 轨迹精确跟随;(3) 两阶段生成 + long-video refiner;(4) 鲁棒标注流水线从公开视频中提取 metric-scale 6-DoF 相机姿态作为动作标签 实验效果:仅用约 213K 公开视频片段、64 张 H100 训练 15 天,每个 60s 720p clip 单 GPU 即可生成;蒸馏量化版可在单卡 RTX 5090 上 NVFP4 量化下 34 秒生成 60s 720p;在 1 分钟世界模型 benchmark 上动作跟随精度强于现有开源 baseline,画质相当但吞吐高 36 倍 批判点评:把「分钟级世界模型」做到能在单张消费卡上跑动,是世界模型走向开发者手里的关键一步;但 1 分钟仍然依赖「stage-2 refiner」这一外置模块,端到端 1 分钟生成质量与商业闭源仍有差距 8. PDI-Bench:几何一致性量化框架 Quantitative Video World Model Evaluation for Geometric-Consistency | UCSD, 港科大等 | arXiv:2605.15185 关键词:视频世界模型·几何一致性·评测基准·3D 重建·物理推理 前序问题:生成视频模型越来越被当作隐式世界模型来研究,但「生成视频是否产生了物理合理的 3D 结构与运动」一直缺乏客观度量——现有评测要么靠人工打分要么靠学习式 grader,对几何失败的诊断力都很弱 本文贡献:提出 PDI-Bench(Perspective Distortion Index)几何一致性量化框架:先用 SAM 2、MegaSaM、CoTracker3 抽取物体级观测,单目重建到 3D 世界坐标,再算三类射影几何残差——尺度-深度对齐、3D 运动一致性、3D 结构刚性;配套 PDI-Dataset 覆盖多种压力测试场景 实验效果:在多个 SOTA 视频生成器上揭示了通用感知指标完全捕获不到的「几何特定失败模式」,为「物理基础视频生成 / 物理世界模型」的进展提供了可诊断信号 批判点评:把视频世界模型评测从「看起来对不对」推进到「几何上对不对」是必要的下一步,依托成熟 3D 工具链让指标可复现;但单目重建本身的误差对 PDI 指标的噪声有多大、对真实开放世界长尾场景的覆盖度,是后续要补的关键证据 趋势观察 实时交互视频生成进入 frame-wise 时代 — Causal Forcing++ 把少步 AR 视频从 chunk-wise 4 步压缩到 frame-wise 2 步,首帧延迟降一半;RAVEN 用 training-time test + CM-GRPO 直击 history 分布漂移——实时交互视频已经从「能动」进入「秒级响应」 相机控制从「重训」走向「零样本 + 一段视频微调」 — Warp-as-History 把相机条件转译为 frozen 模型自带的视觉历史通路,零样本即跟随;只用一段视频做 LoRA 即可泛化到未见素材——相机可控视频生成从「依赖大规模标注」滑向「轻数据即用」 VAE decoder 不再是哑终端 — RefDecoder 指出主流视频扩散模型 decoder 长期处于「无条件」状态,导致细节流失;用 reference attention 给 decoder 也加上条件,PSNR 直接 +2.1dB——decoder 端的条件化正成为视频生成的下一个低悬果实 世界模型走向消费级硬件 — SANA-WM 用 Hybrid Linear Attention + 量化在单卡 RTX 5090 上跑出 34 秒生成 60 秒 720p——分钟级世界模型第一次具备了「开发者本地可玩」的硬件包络 评测从感知质量转向几何/物理一致性 — PDI-Bench 把视频世界模型的考评从「看起来真不真」转到「几何上对不对」,借助成熟 3D 工具链给出射影几何残差——这预示着视频生成下一阶段的评测竞赛是「物理可解释性」 人工智能炼丹君 整理 | 2026-05-15 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注