
搜索到
14
篇与
NVIDIA
的结果
-
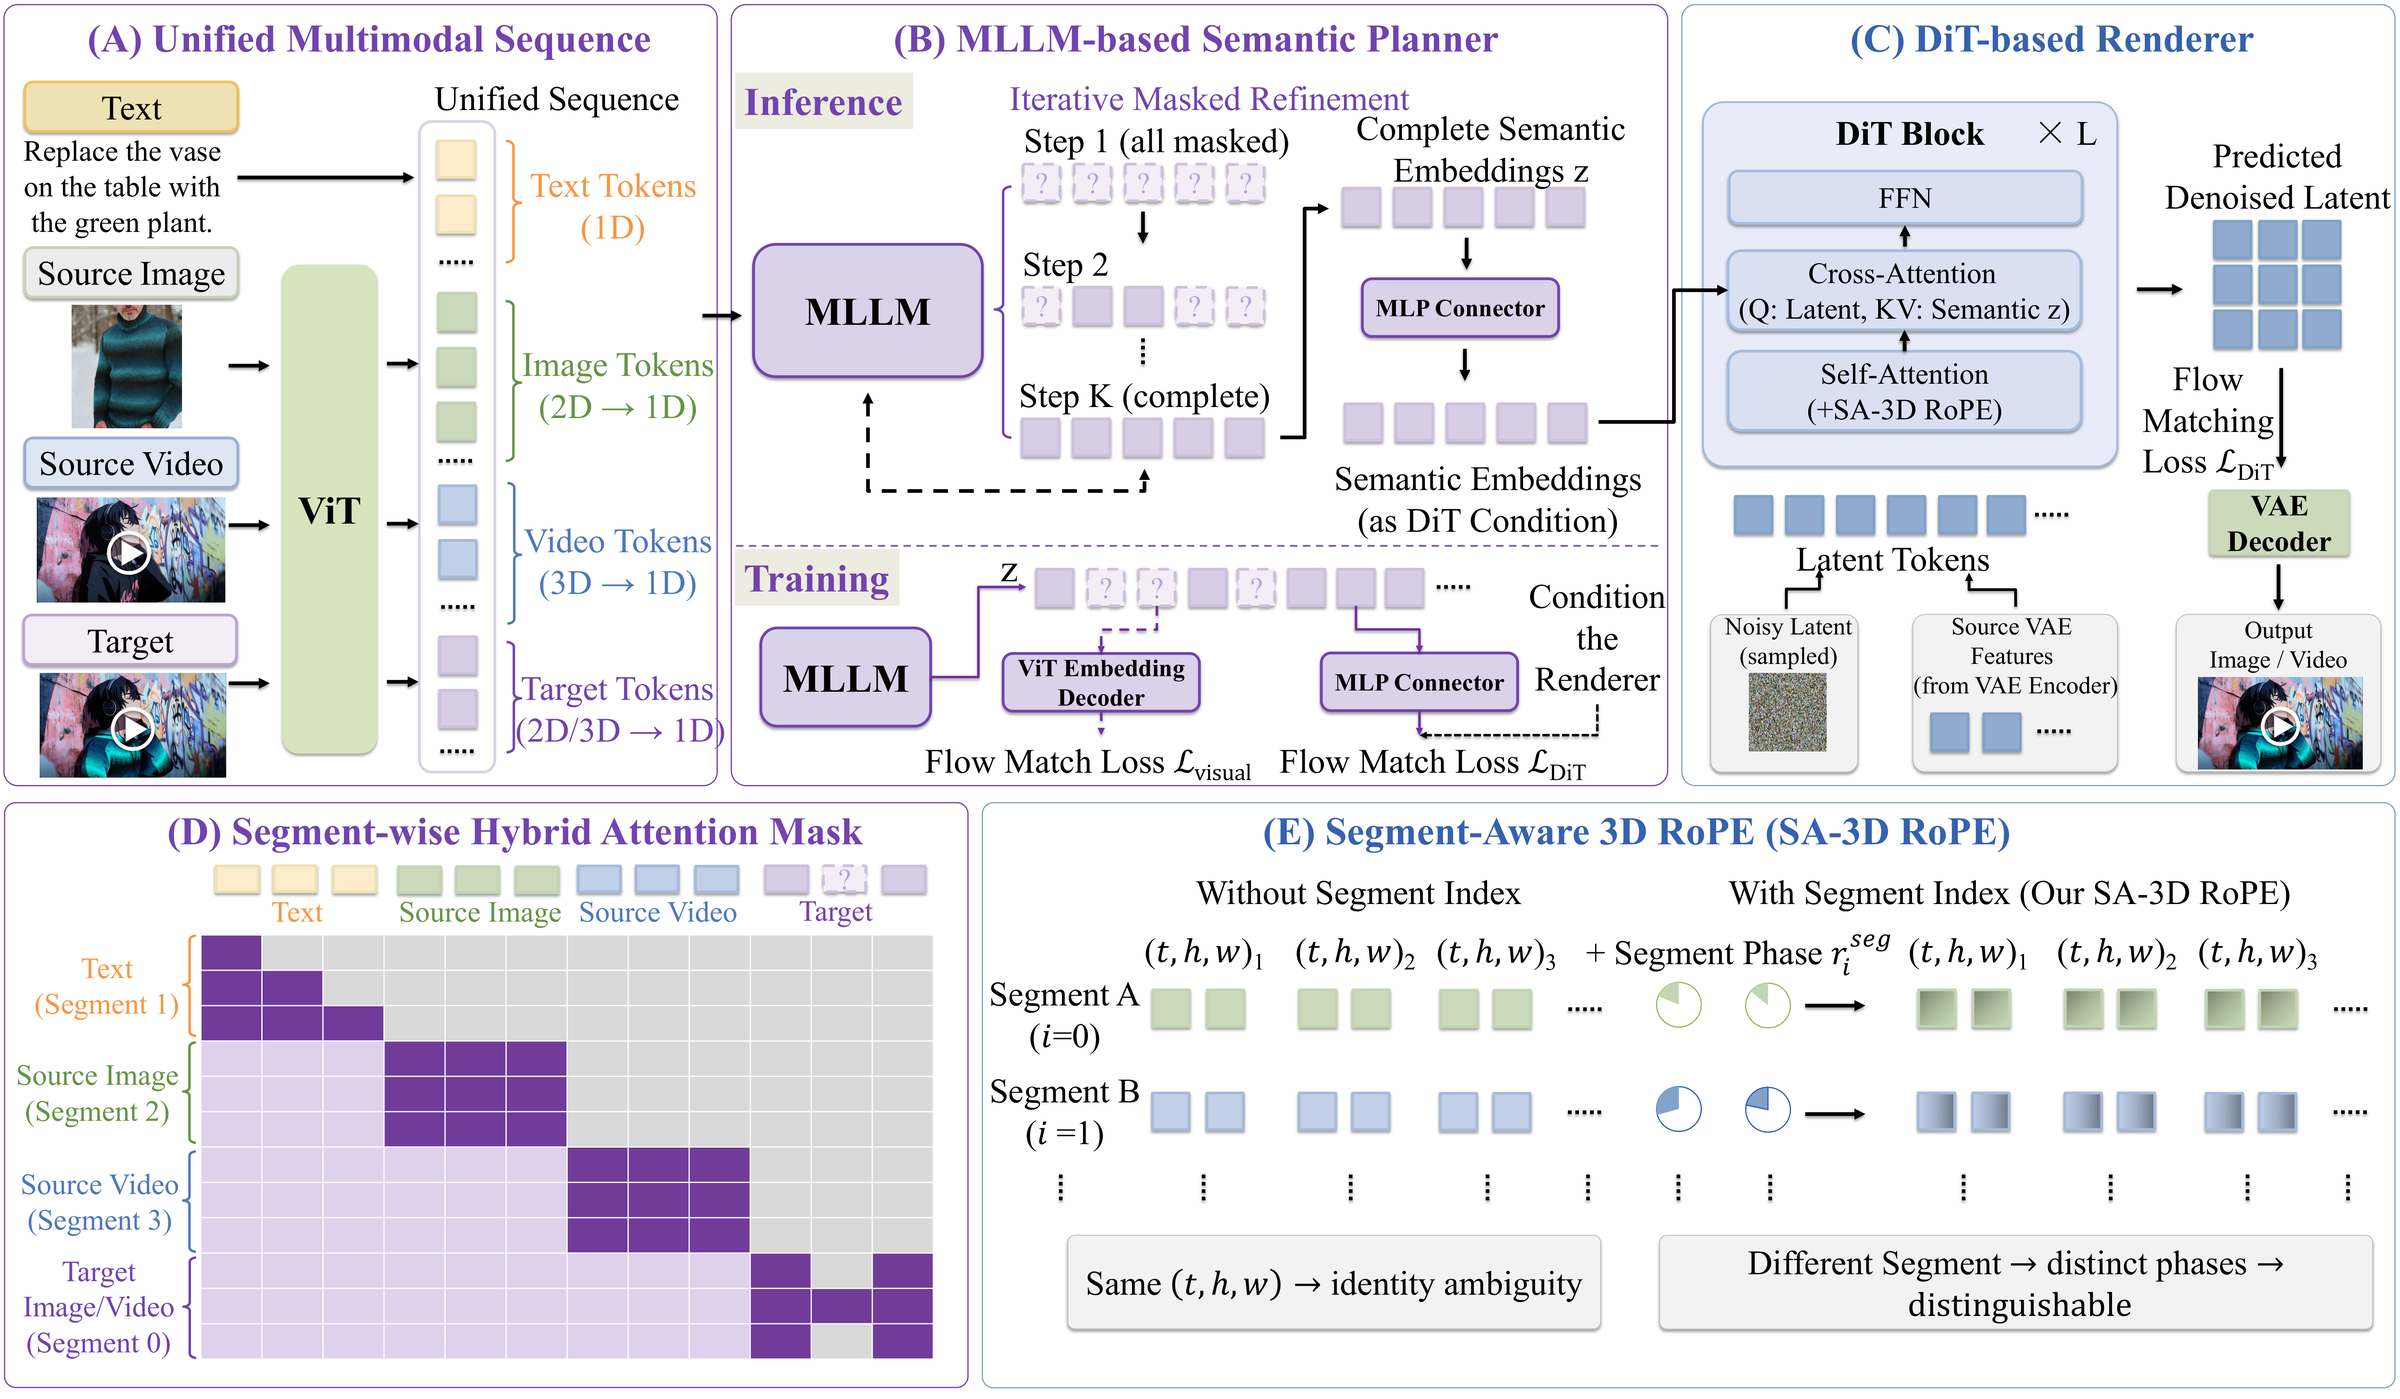
 AIGC 每日速读|2026-05-25|字节Bernini让MLLM规划DiT渲染视频 今日 AIGC 论文速览 今日共 11 篇 · 统一视频生成与编辑 2 篇 · Unified Audio 与音乐生成 2 篇 · 文生图基础架构与高清解码 3 篇 · 视频世界模型与可控生成 2 篇 · 高效推理与长上下文 2 篇 重点论文标题列表 Bernini:MLLM做语义规划DiT做像素渲染 StepAudio 2.5:单一音频基础模型三任务全SOTA ⚡ PiD:512潜变量→2048图像 <1秒解码 SCOPE:首个跨游戏FPS世界模型zero-shot迁移 DecQ:8个查询+3.9%算力把RAE重建拉满 今日论文速览 1. Bernini:MLLM做语义规划DiT做像素渲染 Bernini: Latent Semantic Planning for Video Diffusion | 字节跳动 Bernini Team | arXiv:2605.22344 关键词:统一视频生成·MLLM 规划·DiT 渲染·SA-3D RoPE·CoT ⚠️ 前序问题:MLLM 擅长跨模态推理与语义对齐,扩散模型擅长高保真像素合成——但目前两条路线要么混入一个端到端 unified model(损失各自强项),要么靠 adapter 松耦合(语义传递不充分)。视频生成与编辑亟需一种新分工,能把 MLLM 的语义规划能力和 DiT 的像素渲染能力同时榨干 本文贡献:提出 Bernini 统一视频生成与编辑框架:MLLM 规划器直接在 ViT embedding 空间预测目标语义表征(不是文本),DiT 渲染器以这个语义 plan 为主条件,文本特征 + 编辑场景下的源视频 VAE 特征做辅助引导。规划器和渲染器分开训练 + 轻量协同微调,保住各自预训练能力。引入 SA-3D RoPE(Segment-Aware 3D RoPE)处理多视觉输入,并在规划器中引入 CoT reasoning 把「理解」翻译成「生成指令」 实验效果:在多项视频生成与视频编辑 benchmark 上达到 SOTA;编辑任务上 MLLM 的预训练理解力可直接迁移为强泛化能力——挑战性编辑场景下尤其明显 批判点评:「MLLM 当规划器、扩散模型当渲染器」是非常合理的下一代统一架构分工——既避免了端到端 unified model 的能力打架,也比 adapter 路线传递了更丰富的语义。但论文用 ViT embedding 而非文本作为接口让组件互换性变差,规划器换到其他 MLLM 需要重新对齐;SA-3D RoPE 在多视觉输入场景的扩展上限(如 5+ 参考图)未充分测试 2. StepAudio 2.5:单一音频基础模型三任务全SOTA StepAudio 2.5 Technical Report | 阶跃星辰 StepFun | arXiv:2605.23463 关键词:Unified Audio·ASR·TTS·实时对话·RLHF ⚠️ 前序问题:Unified audio-language model 是大趋势,可现实是它们在 ASR/TTS/实时对话三件事上常常打不过专用系统——语义理解、生成合成、低延迟对话天生有结构与目标差异。如何让一个 backbone 同时压过三个专用 SOTA 是开放挑战 本文贡献:StepAudio 2.5 把「模态接口统一」与「目标分化」分两层处理:文本与音频共享多模态表征空间作为底座,任务特化由「数据构造 + 优化目标 + 解码策略」三件事决定。重头戏是把 post-training 从标准 SFT 升级为「任务定制 RLHF」——ASR 用可验证 multi-token decoding 提速、TTS 用 preference-based RLHF + context-rich supervision 保表现力、Realtime 用 generative reward modeling 框架优化人格一致与低延迟 实验效果:在 ASR / TTS / Realtime 三个方向的标准 benchmark 上同时达到 SOTA,证明「单一音频语言基础模型在三个目标上压过专用系统」是可行的——RLHF 是统一 backbone「分化部署」的关键钥匙 批判点评:把「目标分化交给 RLHF」是非常聪明的分工——既保住统一架构的训练效率,又给三个任务留出独立优化空间。但论文的 RLHF 训练成本巨大且对各任务的奖励信号设计依赖深,落地复现门槛高;与 GPT-4o / Gemini 这种闭源多模态对话模型的实时对话直接对比缺失 3. PiD:512潜变量→2048图像 <1秒解码 PiD: Fast and High-Resolution Latent Decoding with Pixel Diffusion | NVIDIA, 多伦多大学, Vector Institute | arXiv:2605.23902 关键词:Pixel Diffusion·高清解码·DMD2 蒸馏·6× 加速·RAE ⚠️ 前序问题:T2I 主流采用「潜空间扩散 + decoder 还原像素」两段式,但 decoder 是重建优化的——只学逆向 encoder,并不主动合成细节。当目标分辨率拉到百万级(megapixel),decoder 的计算变得非常昂贵,画质上限也被牢牢锁死 本文贡献:提出 PiD(Pixel Diffusion Decoder):把「latent → pixel」decoding 改写成「条件像素扩散」,统一了解码与超分两步。直接在高分辨率像素空间去噪,原生支持 4× / 8× 上采样;通过轻量 sigma-aware adapter 把含噪 latent 注入像素扩散 backbone,使 PiD 能在 latent 还没去噪完时提前接手,让上游 latent diffusion 提前停步。再用 DMD2 蒸馏把推理压到 4 步。同时支持普通 VAE latent 和语义 latent(SigLIP/DINOv2,给 RAE 模型用) 实验效果:512×512 latent 解码为 2048×2048 像素在消费级 RTX 5090 上 <1 秒(峰值 13GB),在 GB200 上最快 210ms——比 cascaded diffusion-based super-resolution 快约 6×,视觉保真度也更好。直接把「高清文生图」的推理成本拉到接近实用区间 批判点评:把 decoder 从「重建优化」改为「条件生成优化」是非常正确的方向——这是 RAE 路线之外又一条反思 latent decoding 的工作。<1 秒 2K 解码 + 6× 加速是少有的同时省时又提质的硬数字;但 PiD 与原生 pixel-space 扩散(如 PixArt-Σ pixel)之间的对比仍未完全展开,DMD2 4-step 蒸馏的稳定性如何随分辨率扩展仍需观察 4. SCOPE:首个跨游戏FPS世界模型zero-shot迁移 SCOPE: Simulating Cross-game Operations in Playable Environments for FPS World Models | 国科大 UCAS-Terminus AI Lab, 新加坡国立 NUS, 浙江大学, 港科大广州 | arXiv:2605.23345 关键词:FPS 世界模型·视频扩散·跨游戏迁移·CrossFPS·per-pixel 条件 ⚠️ 前序问题:FPS(第一人称射击)游戏的可玩世界模型,每一帧都要响应高频重叠的多种操作信号,同时还不能扰动屏幕中无关区域。已有方案要么全图注入动作信号(粒度太粗),要么只在单款游戏上训(无法跨游戏迁移) 本文贡献:观察到 FPS 操作具有「空间选择性」:开火/换弹只影响武器周围的局部 scope,而镜头/移动指令影响全局背景。SCOPE 在预训练视频扩散 transformer 的每个 block 插入条件模块,把特征重塑成 per-pixel 时序序列,每个位置根据本地视觉内容计算自己的动作响应——不依赖任何分割标注就把 in-scope 效果与 out-of-scope 生成分开。同时构建 CrossFPS:首个多游戏 FPS 数据集(7 款游戏、69K 帧对齐 10-DoF 控制信号片段),让模型学到游戏无关的视觉-动作映射 实验效果:训得的世界模型在多个未见场景上 zero-shot 迁移成功,动作响应度强、scope 分离精确,跨游戏泛化效果优——首次让 FPS 世界模型走出「单游戏专门训」的范式 批判点评:「scope 局部 vs 全局」的解构是非常贴近 FPS 物理直觉的观察,per-pixel 时序条件注入比全图条件优雅得多。CrossFPS 数据集让 FPS 世界模型有了 ImageNet 时刻的基础;但 10-DoF 控制信号离真实玩家的复杂连招仍有距离,对长 horizon 一致性(数百帧战斗)效果论文未充分披露 5. DecQ:8个查询+3.9%算力把RAE重建拉满 DecQ: Detail-Condensing Queries for Enhanced Reconstruction and Generation in Representation Autoencoders | 复旦大学, 上海 AI Lab | arXiv:2605.22777 关键词:RAE·DINOv2·细节 Query·重建生成解耦·3.9% 算力 ⚠️ 前序问题:Representation Autoencoder(RAE,把视觉基础模型当 tokenizer encoder)能让 latent diffusion 收敛更快、生成更好——但 VFM 必须冻住,限制了细粒度重建能力。如果反过来微调 VFM 解锁重建,又会破坏预训练语义空间、拖累生成。重建 vs 生成长期是 trade-off 本文贡献:DecQ 思路简单优雅:用一组轻量「detail-condensing queries」通过 condenser 模块从中间层 VFM 特征里抽取细粒度信息,再把这些 query 拼到 decoder 端辅助重建,同时在生成建模阶段与 patch token 一起被预测。深浅两层信息都被聚合,无需碰 VFM 主权重,重建-生成 trade-off 被巧妙绕开 实验效果:DINOv2-based RAE 上仅加 8 个 query 和 3.9% 额外算力,PSNR 从 19.13 dB 提到 22.76 dB(重建端 +3.6dB);生成端比 RAE 收敛快 3.3×,无 guidance FID 1.41、有 guidance FID 1.05——重建与生成同时提升且开销可忽略 批判点评:「不碰冻结 VFM、只加一组 query 当辅助通道」是非常 ROI 高的设计,是「冻结 vs 微调」之外的第三条路。从 PSNR / FID 数字看是确凿的正向贡献;但 8 个 query 是否够撑起更大分辨率(512+)下的细节量级仍待验证,与最新 token-merging / FlexQuery 等类似工作的对比略浅 6. SEGA:DiT训练免微调按频段动态缩放注意力 SEGA: Spectral-Energy Guided Attention for Resolution Extrapolation in Diffusion Transformers | 多伦多大学, Vector Institute | arXiv:2605.22668 关键词:DiT·分辨率外推·RoPE·训练免微调·频段自适应 ⚠️ 前序问题:DiT 在训练分辨率之外生成时画质显著掉,目前 training-free 方案常用 RoPE 外推 + 注意力 scaling 修正,但 scaling 都是一刀切——对 RoPE 各分量(含不同频段)施加同样的缩放,导致「全局结构 vs 细节恢复」此消彼长 本文贡献:提出 SEGA:完全 training-free,根据每个去噪步 latent 的空间-频段结构,动态地对 RoPE 不同分量分别 scaling。低频分量保结构、高频分量恢细节,按内容自适应分配——而不是固定常数 实验效果:多个目标分辨率上一致提升 DiT 高分辨率合成质量,超过现有 training-free 基线;不需要重训,可即插即用 批判点评:「不同频段差别 scaling 而不是常数」是经过谱分析后的小而正确的改进,对 DiT 高清生成是廉价收益。但论文主要在 SD3/FLUX 系列上验证,更激进外推倍率(如 4×)下是否仍稳健没充分展开;与 ScaleCrafter / FreeU 等同类训练免微调方案的端到端定量对比较少 7. Gated DeltaNet-2:线性注意力擦写解耦1.3B全面胜出 Gated DeltaNet-2: Decoupling Erase and Write in Linear Attention | NVIDIA | arXiv:2605.22791 关键词:线性注意力·Gated DeltaNet·擦写解耦·长上下文·NVIDIA ⚠️ 前序问题:线性注意力把无界 softmax cache 压缩成固定 recurrent state,难点不在于「忘掉什么」而在于「怎么编辑这个压缩记忆而不打乱已有联系」。已有 Delta-rule 模型用 scalar gate 同时控制 key 端的擦除和 value 端的写入——一个标量做两件事,能力被绑死 本文贡献:Gated DeltaNet-2(GDN-2)泛化了 Gated DeltaNet 与 KDA:把 erase 与 write 解耦成两个 channel-wise gate(擦除门 b_t / 写入门 w_t);两者塌缩到同一 scalar 时退化为 KDA,再叠加 decay 塌缩则退化为 Gated DeltaNet。配套给出 fast-weight 更新视角、chunkwise WY 算法(channel-wise decay 吸收到非对称 erase 因子)、gate-aware backward——保住了高效并行训练 实验效果:1.3B 参数在 100B FineWeb-Edu tokens 上训完,在语言建模/常识推理/检索上综合超过 Mamba-2 / GDN / KDA / Mamba-3 变体;在 RULER 长上下文 needle-in-a-haystack 多 key retrieval 上优势最大,纯循环与混合架构都强。代码开源 批判点评:「擦除/写入解耦」是 linear attention 设计上一个本应早被做的细节修正——一个 gate 控两件事本来就是工程妥协。GDN-2 是少有「同时改写规则又保住并行训练」的设计;但论文聚焦语言建模,对视觉生成场景(视频扩散 / 多模态 backbone)线性注意力替换的实际收益尚需后续验证,1.3B 规模在 7B+ 是否仍领先 Mamba-3 也是开放问题 8. Geo-Align:首个相机控制视频生成RL几何奖励 Geo-Align: Video Generation Alignment via Metric Geometry Reward | 中科大, 上海 AI Lab, 浙大 | arXiv:2605.23903 关键词:相机控制视频·RL 对齐·metric 3D 奖励·video re-rendering ⚠️ 前序问题:相机控制视频生成(video-to-video re-rendering)此前几乎全靠合成数据上的 SFT,真实多视角同步视频极度稀缺,模型在真实 OOD 视频上对物理尺度与相机轨迹的遵循非常差——「能拍但不像」一直没解决 本文贡献:Geo-Align 首次为相机控制视频再渲染提出 RL 框架:基于预训练模型,用「尺度感知感知奖励」对齐。具体而言引入 metric 3D estimator 从生成视频中抽取精确相机轨迹,对 rotation / translation 偏差显式惩罚;数据 pipeline 精心设计——以真实条件视频 + 合成数据派生的目标相机轨迹训练,消除对 paired data 的依赖 实验效果:相机可控性与视觉保真度同时优于现有 SFT 基线,验证 metric geometry 奖励是补救「合成 → 真实」迁移损耗的有效手段——是 video re-rendering 的下一步 批判点评:把 video re-rendering 从 SFT 推进到 RL + 几何奖励是必然的下一步,metric 3D estimator 当 reward model 思路漂亮;但 metric 3D estimator 本身的精度上限直接决定奖励质量,对动态场景(人物快速运动、遮挡)的估计误差如何不被奖励放大需要后续验证 9. LMDM:消费级笔记本跑实时音乐扩散 Live Music Diffusion Models: Efficient Fine-Tuning and Post-Training of Interactive Diffusion Music Generators | UC San Diego, CMU, Mila, Northeastern | arXiv:2605.22717 关键词:音乐扩散·实时生成·KV Cache·ARC-Forcing·consumer GPU ⚠️ 前序问题:现在最强的「实时流式音乐生成」走的是 discrete-AR(离散自回归)路线,训练和推理都要工业级算力。开源社区强势的音频扩散是双向、非流式的——理论上不能做实时演奏 本文贡献:LMDM 重新审视 block-wise outpainting 扩散管线:识别出诸多推理瓶颈是它比 discrete-AR 慢的根因,提出 block-wise KV Caching 补回;进一步引入 ARC-Forcing post-training,无需 RL 或 reward model 就能稳健做对齐,缓解 error accumulation 实验效果:扩散模型首次在推理复杂度上反超离散 AR 路线,能在消费级游戏本上本地实时跑——支持文条件生成、草图条件音乐合成、jamming;论文还展示了 LMDM 作为「generative delay」在真人音乐家即兴演奏中的真实艺术家-AI 合作 批判点评:把扩散从「非流式」拉到「实时演奏」是开源社区音频生成的关键一步——把 KV Cache 思路从语言模型迁过来很合理。但和 Suno/Udio 这类闭源系统直接对比缺失,对极长(>10 分钟)持续演奏的稳定性论文未深入讨论;ARC-Forcing 替代 RLHF 的 robustness 在不同流派/复杂编曲下的表现仍需更多实验 10. ETCHR:图像编辑器即多模态推理助手 ETCHR: Editing To Clarify and Harness Reasoning | 上海 AI Lab, 港中文 | arXiv:2605.23897 关键词:Think with Images·图像编辑·推理增强·VLM 奖励·MLLM 解耦 ⚠️ 前序问题:MLLM「think with images」范式越来越火,但 toolkit 路线被固定动作束缚,unified 路线产生的中间图常常很噪。如果想用「专用图像编辑器」当 MLLM 的视觉推理助手,会遇到两个 gap:(1) language-side,被动指令跟随的编辑器无法把抽象问题映射成合适的视觉变换;(2) generation-side,推理深度增加时编辑正确性快速退化 本文贡献:ETCHR 提出一个「question-conditioned, reasoning-aware」图像编辑器,与下游 understanding model 完全解耦。两阶段训练:第一阶段 Reasoning Imitation(在编辑轨迹上 SFT),第二阶段 Reasoning Enhancement(用 VLM-derived 奖励同时优化编辑正确性 + 下游推理准确率)。解耦让 ETCHR 可以 plug into 任意开闭源 MLLM 而无需重训 实验效果:覆盖细粒度感知/图表理解/逻辑推理/拼图复原/3D 理解 5 类任务,Pass@1 平均提升:Qwen3-VL-8B +4.82(55.95→60.77)、Gemini-3.1-Flash-Lite +5.47(65.08→70.55)、1T MoE Kimi K2.5 +4.61(76.55→81.16)——证明 reasoning-aware editor 通用有效 批判点评:「编辑器作为 MLLM 的可插拔视觉推理助手」是非常正确的下一步分工,比 toolkit / unified 两条路线都更模块化。但 ETCHR 训练强依赖 VLM-derived rewards,奖励信号的偏差可能复制到编辑器;与最新 unified MLLM(如 GPT-4o Image / Bagel)端到端的 think-with-image 能力对比还需要更全面 11. Swift Sampling:泰勒展开找时序惊奇帧0.02倍开销 Swift Sampling: Selecting Temporal Surprises via Taylor Series | Microsoft Research India | arXiv:2605.22678 关键词:长视频·帧选择·预测编码·Taylor 展开·训练免微调 ⚠️ 前序问题:长视频里大部分帧冗余,关键信息藏在「时序惊奇」——视觉特征偏离了预测轨迹的瞬间。已有 training-free 帧选择要么靠辅助网络(额外算力),要么靠视频特化的超参(不通用) 本文贡献:受脑科学预测编码启发,Swift Sampling 把视频建模成视觉 latent 空间里可微的轨迹,计算 velocity 和 acceleration,用 Taylor 展开预测后续帧的「预期路径」。偏离预期最猛的帧 = 时序惊奇帧 = 应被采样的关键帧。训练免微调、几乎零额外开销 实验效果:比基线只多 0.02× 算力开销(比领先方法的 overhead 还低 30×)。3 个长视频 QA benchmark + 10 个下游任务上一致优于 uniform sampling 与其他 query-agnostic 基线;长视频小预算场景下提升最大(+12.5 分准确率) 批判点评:「预测编码 → Taylor 外推 → 惊奇帧」的链条简洁且物理直觉强,几乎零成本是工程上极少见的免费收益。但 Swift Sampling 是 query-agnostic 的——任务相关的关键帧(需要 query-conditional)仍是它的盲区,未来与 query-aware 方法的组合空间巨大 趋势观察 统一架构出现新分工:MLLM 当语义规划器,扩散/像素模型当渲染器 — Bernini 用 MLLM 在 ViT embedding 空间预测目标语义,DiT 拿这个 plan 当主条件渲染像素;ETCHR 把编辑器训成 MLLM 可插拔的视觉推理助手——「端到端 unified」之外,「语义规划 + 像素渲染」的分工路线正在成型。这条路线把各组件的预训练能力都榨干,比 adapter 更深、比端到端更模块化 像素空间扩散解码器替代传统 VAE:高清/高效解码的新范式 — PiD 把 latent→pixel 改成条件像素扩散,512 latent <1 秒解到 2048 像素(消费级 RTX 5090),比 cascaded SR 快 6× 且画质更好;DecQ 不动 RAE 冻结 VFM 只加 8 个 query + 3.9% 算力就让重建 PSNR +3.6dB、生成收敛快 3.3×——「decoder 该重建还是该生成」的争论开始让位给「decoder 应同时承担解码与上采样」的新范式 Unified Audio 模型靠任务定制 RLHF 同时压过专用系统 — StepAudio 2.5 把 ASR/TTS/Realtime 三件事架在共享 backbone 上,让任务分化交给「数据 + RLHF reward + 解码策略」三件套——ASR 用可验证 multi-token decoding、TTS 用 preference RLHF、Realtime 用 generative reward modeling,最终三项 benchmark 同时 SOTA。证明「unified 不必妥协」的关键钥匙是 RLHF 视频生成对齐从 SFT 走向几何/物理约束的强化学习 — Geo-Align 首次给相机可控视频再渲染加 RL:用 metric 3D estimator 抽取相机轨迹,对 rotation/translation 偏差显式给奖励,不再依赖稀缺的 paired 真实多视角数据。SCOPE 的 per-pixel 时序条件设计也隐含「空间选择性」的物理直觉——视频生成的对齐方式开始引入几何/物理约束 推理期免训练优化在文生图/长视频/长上下文遍地开花 — SEGA 给 DiT 做按频段自适应注意力 scaling 解决高分辨率外推;Swift Sampling 用 Taylor 展开找时序惊奇帧选关键帧(0.02× 开销 +12.5 分);GDN-2 把线性注意力的 erase/write 解耦改善长上下文检索——「免训练 + 信号利用」的范式从图像扩散扩到视频/语言全场景,给落地侧带来快速收益 人工智能炼丹君 整理 | 2026-05-25 更多 AIGC 论文解读,关注微信公众号「人工智能炼丹君」 每日更新 · 论文精选 · 深度解读 · 技术脉络 微信搜索 人工智能炼丹君 或扫描下方二维码关注
-
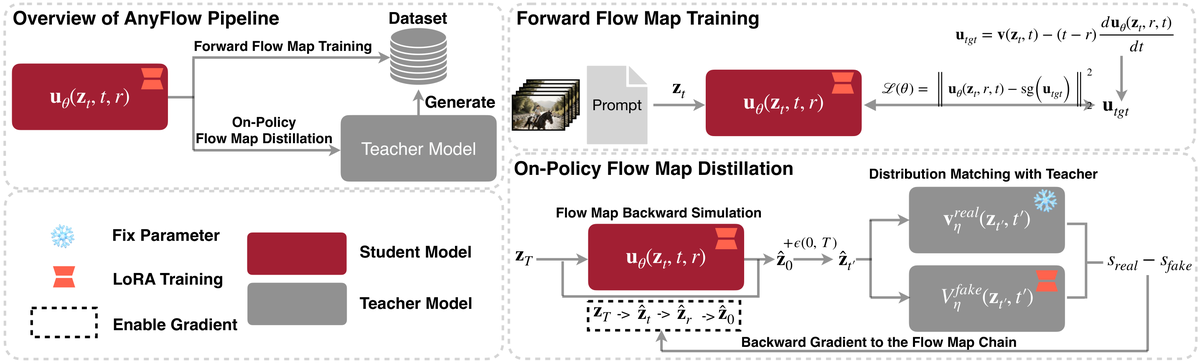
AIGC 每日速读|2026-05-14|视频扩散从少步到任意步AnyFlow 今日 AIGC 论文速览 今日共 6 篇 · 视频扩散与推理加速 2 篇 · 图像生成与表征 2 篇 · 图像编辑与对齐评测 1 篇 · RL 后训练方法论 1 篇 重点论文标题列表 AnyFlow:——首个基于 flow map AsymFlow:rank-asymmetric ⚡ Qwen-Image-VAE-2.0:高压缩 VAE 套件 Edit-Compass:EditReward-Compass Orthrus:双视图框架 今日论文速览 1. AnyFlow:——首个基于 flow map AnyFlow: Any-Step Video Diffusion Model with On-Policy Flow Map Distillation | 新加坡国立大学 Show Lab, MIT, NVIDIA | arXiv:2605.13724 关键词:视频扩散·Flow Map·On-Policy 蒸馏·Any-Step·推理加速 ⚠️ 前序问题:近一年的少步视频生成几乎被一致性蒸馏(Consistency Distillation)统治,4-8 步即可出图,但只要把采样步数从 4 加到 16/32 画质反而塌——CD 用一致性轨迹替换了原始 PF-ODE 轨迹,破坏了 ODE 采样在测试时的可扩展行为,无法服务「任意步数」推理需求 本文贡献:提出 AnyFlow——首个基于 flow map 的任意步数视频扩散蒸馏框架:(1) 把蒸馏目标从端点一致性映射 z_t→z_0 升级为流图过渡 z_t→z_r,让学生学会任意时间区间的跳跃;(2) Flow Map Backward Simulation 把完整 Euler rollout 拆为多段 shortcut,用 on-policy rollout 替代 off-policy 配对蒸馏,缓解少步采样的离散化误差和因果生成的 exposure bias 实验效果:在双向 DiT 与因果两类视频扩散骨干、1.3B 到 14B 全规模区间一致达到或超越 consistency baseline;当步数从 4 提升到 16/32 时性能不再退化、反而单调上升,重新恢复了 ODE 采样的 test-time scaling 优势 批判点评:把蒸馏目标从端点一致性升级到任意区间流图是范式级创新,FMBS 的 on-policy 反向模拟在视频域是首次系统化提出;但论文未公开 VBench/UCF-FVD 等具体数值,复现门槛在 1B-14B 教师 + 大规模 on-policy rollout,数据与算力两端都不低 2. AsymFlow:rank-asymmetric Asymmetric Flow Models | Stanford, ETH | arXiv:2605.12964 关键词:Flow Matching·像素扩散·非对称参数化·FLUX.2·文生图 ⚠️ 前序问题:高维像素空间下做 flow matching 速度预测时,模型必须建模与图像同维的高维噪声,即使数据本身有强低秩结构也只能用满秩参数化硬扛,导致像素扩散与潜空间模型间长期存在显著质量差距 本文贡献:提出 AsymFlow:rank-asymmetric 速度参数化——噪声预测限制在低秩子空间、数据预测保持满维,不改网络结构与训练/采样流程即可解析恢复完整速度;首次给出潜空间预训练→像素空间微调的可行路径,让 FLUX.2 klein 9B 的潜空间先验直接初始化像素生成 实验效果:ImageNet 256×256 取得 1.57 FID,大幅超越同类 DiT/JiT 像素扩散;从 FLUX.2 klein 9B 微调出的像素文生图模型在 HPSv3、DPG-Bench、GenEval 上全面超越其潜空间基模,主观真实感显著提升 批判点评:rank-asymmetric 视角直击像素扩散的本质瓶颈,无侵入式参数化是工程甜点;但低秩子空间的秩选择、与 FLUX.2 这种顶级模型的耦合是否过强、跨数据集泛化能力都还需更大规模验证 3. Qwen-Image-VAE-2.0:高压缩 VAE 套件 Qwen-Image-VAE-2.0 Technical Report | Alibaba Qwen Team | arXiv:2605.13565 关键词:图像 VAE·高压缩·文本渲染·扩散兼容·视觉分词器 ⚠️ 前序问题:高压缩比 VAE 在重建保真度和 diffusability 之间长期难以兼得——压得越狠下游 DiT 越难训,文本密集场景(文档、海报)的字符更是首当其冲糊掉 本文贡献:提出 Qwen-Image-VAE-2.0 高压缩 VAE 套件:架构上引入 Global Skip Connections + 扩展潜空间通道;训练上用十亿级图像 + 合成渲染引擎专项强化文本场景;潜空间用增强语义对齐策略让其更适合扩散建模;编解码器采用非对称 + attention-free 主干降低编码开销 实验效果:在公开重建基准上达到 SOTA;提出 OmniDoc-TokenBench 文档专项评测,在高压缩比下兼顾通用与文本场景;下游 DiT 实验显示其 diffusability 显著优于现有高压缩基线,收敛速度明显加快 批判点评:把 VAE 当成独立产品打磨——文档专项 benchmark + 文本渲染合成数据是务实的工程亮点;但相对其他高压缩 VAE 的提升幅度需等论文公开数值后比较,「diffusability」的量化定义仍偏经验 4. Edit-Compass:EditReward-Compass Edit-Compass & EditReward-Compass: A Unified Benchmark for Image Editing and Reward Modeling | 字节跳动 Doubao Team 等 | arXiv:2605.13062 关键词:图像编辑·Reward Model·多维评测·RL 对齐·Benchmark ⚠️ 前序问题:现有图像编辑 benchmark 难度不足、评测维度粗放,已无法区分前沿模型;与此同时图像编辑 RL 越来越依赖 reward model,但 reward model 评测仍停留在脱离实际 RL 场景的设定上,导致编辑模型与 reward model 都缺少可靠裁判 本文贡献:提出 Edit-Compass + EditReward-Compass 统一评测套件:前者含 2,388 条精标实例,覆盖世界知识推理、视觉推理、多图编辑等六级递进任务,采用结构化推理 + 细粒度 rubric 多维评分;后者含 2,251 对偏好对,模拟真实 RL 优化中的 reward 场景 实验效果:为前沿编辑模型提供了能拉开差距的多维难度梯度,配套的 reward model 评测能反映 RL 训练中 reward model 的真实表现,为后续编辑模型与 reward model 的迭代提供统一坐标系 批判点评:把「编辑能力」和「reward model 能力」两条评测线收编进同一套 benchmark 是踏实的基础工作;2,251 对偏好对的标注一致性、reward 评测对真实 RL 收益的预测力,是这类工作走向社区共识的关键门槛 5. Orthrus:双视图框架 Orthrus: Memory-Efficient Parallel Token Generation via Dual-View Diffusion | Adobe Research, University of Oregon | arXiv:2605.12825 关键词:并行解码·扩散语言模型·KV Cache·推理加速·双视图 ⚠️ 前序问题:自回归 LLM 生成保真度高但串行解码慢,扩散语言模型可并行却质量退化、训练贵、收敛缺乏严格保证——视觉/多模态 token 生成场景同样面临「快」与「准」难以兼得 本文贡献:提出 Orthrus 双视图框架:在冻结的 AR LLM 上挂载一个轻量可训练扩散并行视图,两视图共用同一份高保真 KV Cache——AR 头负责 prefill 构建准确表征、扩散头负责并行解码;通过两视图共识机制保证无损推理,把扩散并行解码移植到 Transformer 几乎零侵入 实验效果:在保证完全等价生成(lossless)的前提下,相比纯自回归提供最高 7.8x 加速,KV Cache 内存仅增加 O(1),参数增量极小;为视觉/多模态自回归 token 生成提供直接可用的并行加速路线 批判点评:把扩散当成 AR 的「并行外设」而不是替代品,借共识机制保留 AR 保真度,工程上很优雅;但 7.8x 加速属上限值,真实任务下并行步内的拒绝率与吞吐曲线值得进一步给出,扩散头训练成本也未充分披露 6. Beyond-GRPO:奖励分配原则 Beyond GRPO and On-Policy Distillation: An Empirical Sparse-to-Dense Reward Principle for Language-Model Post-Training | Meta | arXiv:2605.12483 关键词:LLM 后训练·GRPO·On-Policy 蒸馏·奖励密度·稀疏到稠密 ⚠️ 前序问题:在「可验证标注极其稀缺」的后训练场景下,主流做法(在部署模型本身上跑 GRPO)忽视了一个奖励密度原则:稀疏的序列级奖励应该用在能产生有效探索的强模型上、稠密的 token 级奖励才适合把行为压缩进小模型,这一直觉对生成模型的 RL 对齐同样关键 本文贡献:提出 Sparse-to-Dense 奖励分配原则:把宝贵的可验证数据先「上游」给强 teacher 跑 GRPO 做探索,再以稠密蒸馏的形式「下游」灌给小学生,最后在学生侧再补一段稀疏 RL;具体配方为 forward-KL warmup → OPD on-policy → 学生侧 GRPO 的三段桥 实验效果:在 Qwen3-1.7B 学生固定的前提下,先在 8B teacher 上 RL 再蒸馏全面优于直接在学生上 GRPO;学生侧后续 GRPO 把 MATH 从 75.4% 提升到 78.5%、比 replay baseline 高 2.8 分,AIME 端点也最强 批判点评:「奖励密度」的视角让 GRPO 与 OPD 不再对立而成同一光谱的两端,对资源紧张团队的实践指导价值很高;但结论建立在数学这一可验证任务上,对图像/多模态生成等弱验证任务能否平移仍待验证 趋势观察 视频扩散从「少步」走向「任意步」 — AnyFlow 把蒸馏目标从端点一致性升级到任意区间的 flow map,叠加 on-policy 反向模拟,让一个学生模型在 1/4/16/32 步上都呈现良性 scaling——少步视频生成第一次有了真正的「test-time 预算自由度」 像素扩散借势潜空间预训练 — AsymFlow 用 rank-asymmetric 速度参数化把高维噪声预测限制在低秩子空间,并首次跑通了「FLUX.2 klein 9B 潜空间→像素空间」的微调路径——像素扩散与潜空间扩散开始走向「初始化共享、后期分化」的新协作方式 VAE 不再是配角,而是产品 — Qwen-Image-VAE-2.0 把高压缩 VAE 当作独立产品打磨:Global Skip Connections + 扩展通道 + 文档专项 benchmark,承认了「VAE 决定 DiT 上限」的事实,VAE 进入「文本可读、扩散友好、推理便宜」的三维竞赛 编辑模型与 reward model 同台同尺 — Edit-Compass 把「图像编辑能力」和「reward model 能力」并入同一评测套件,并把 reward model 评测从脱节场景改造成贴合 RL 实战的偏好对——前沿编辑模型的 RL 对齐第一次有了配套的统一坐标系 稀疏-稠密奖励分配成为后训练新共识 — Beyond-GRPO 给出一条简单规则:稀缺可验证数据先在强 teacher 上做稀疏 RL,再以稠密蒸馏下沉到小学生,最后学生侧补稀疏 RL;这一原则同样适用于多模态生成模型的 reward 分配,正在成为下一代 alignment pipeline 的骨架 人工智能炼丹君 整理 | 2026-05-14